漏洞的单价:AI 挖一个内核提权漏洞只要 1279 美元
11 月 4 日,OpenAI 发了一篇标题很克制的文章:《少了一千条通往 root 的路》。
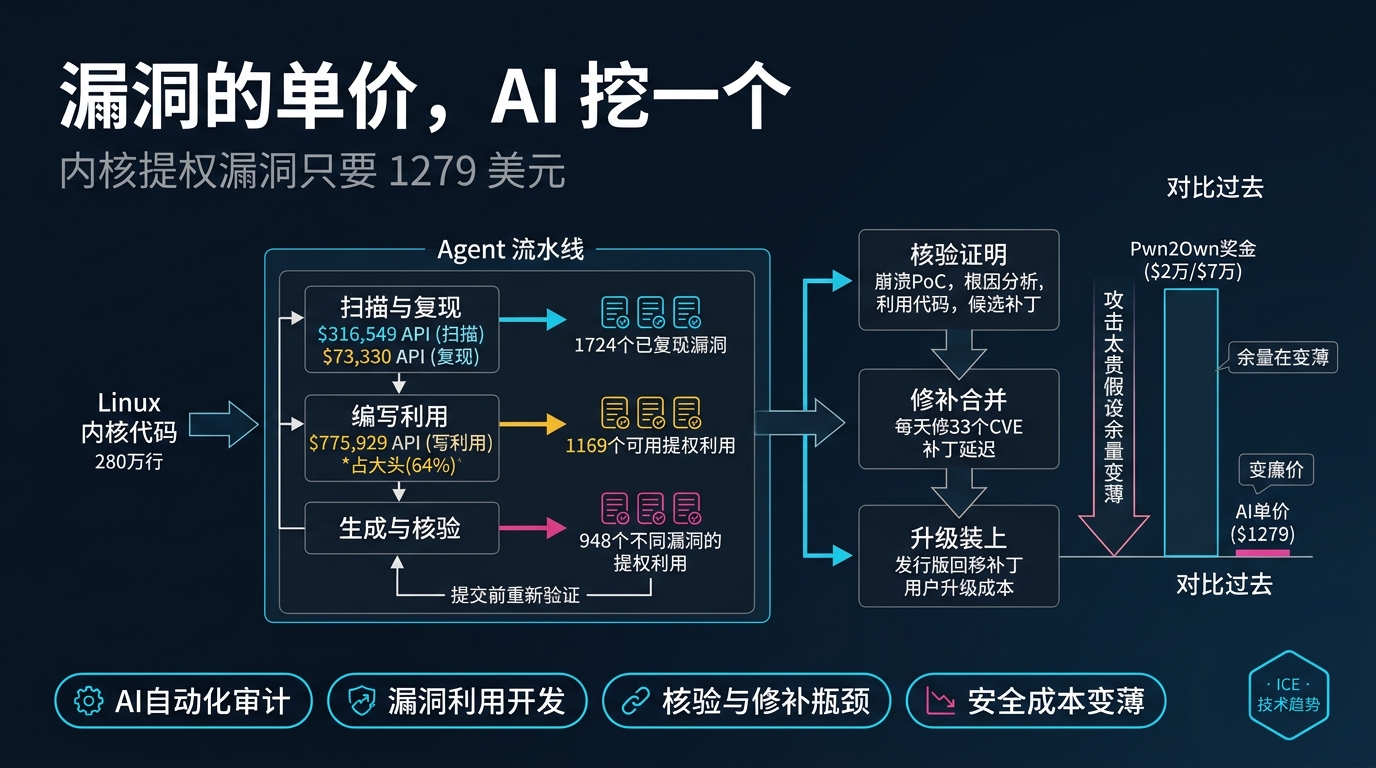
内容一点也不克制。10 月中旬,它用一个尚未发布的安全专用模型,搭了一条 Agent 流水线,对最新的 Linux 内核主线做了一次自动化审计:
- 审计了约 280 万行代码,大约是整个内核的 7%;
- 在虚拟机里复现了 1724 个漏洞;
- 做出了 948 个不同漏洞的本地提权利用,也就是一个没有任何特权的本地用户,可以借此拿到 root;
- 总共花了 121 万美元 API 费用,平均每个 1279 美元。
作为对照,Pwn2Own 和 TyphoonPWN 这两个黑客大赛,过去给一个 Linux 内核本地提权利用的奖金分别是 2 万和 7 万美元。
把它和另外两件事放在一起看,会更清楚:
- 前不久,内核维护者 Greg Kroah-Hartman 在 Kernel Recipes 大会上说,内核现在每天要修 33 个 CVE,是过去的四倍,接下来会是“艰难的 18 个月”;
- 11 月 6 日,Google DeepMind 宣布,Agent 在人的引导下,把一个已发表的 RSA-1024 签名伪造攻击重跑了一遍,算力只用了原来的三分之一不到。
先说结论:发现漏洞正在变成一门按件计价的流水线生意,单价还在快速下降。真正稀缺的已经不是“找到”,而是“确认、修好、装上”。而很多“攻击太贵,所以安全”的假设,余量正在变薄。
一、一笔明细账:121 万美元花在哪
OpenAI 这篇文章最有价值的地方,是它把每个阶段的数量和 API 成本都列了出来。这在同类发布里很少见。
流水线分五步:先挑审计目标,再扫出候选漏洞,在虚拟机里复现,判断能不能利用并写出利用代码,最后生成补丁,交给人工审核。
| 阶段 | 做什么 | 进 → 出 | API 成本 |
|---|---|---|---|
| 挑目标 | 找出低权限用户能触达、与安全相关的代码 | 全部内核 → 5034 个目标(约 280 万行) | 3,426 美元 |
| 扫描 | 读代码、理解威胁模型、找漏洞 | 5034 个目标 → 2308 个候选(12 小时) | 316,549 美元 |
| 复现 | 写 PoC,在带内存检测的内核里跑 | 2308 → 1724 个已复现(30 小时) | 73,330 美元 |
| 初筛 | 判断有没有可行的利用路径 | 1724 → 1238 个提权候选 + 313 个信息泄露候选 | 44,194 美元 |
| 写利用 | 在开启常规防护的系统上拿 root | → 1169 个可用提权利用,归并为 948 个不同漏洞 | 775,929 美元 |
五项加起来正好 121.3 万美元。几个数字值得多看一眼。
大头花在写利用上,占了 64%。 发现漏洞本身(挑目标加扫描)只占约 26%,复现只占 6%。也就是说,证明“这个漏洞真能拿到 root”,比找到它贵得多。
复现率很高。 2308 个候选里有 74.7% 被成功复现。剩下没复现的,大多是需要更高权限、竞态条件太难触发,或者超出了时间预算。真正属于“模型分析错了”的,只有 3.1%。
失败比成功贵十倍。 1169 次成功的利用开发平均每次 360 美元;69 次失败的平均每次 3922 美元,主要耗在几个特别难的竞态漏洞上。OpenAI 自己也说,如果设一条“一小时没有进展就放弃”的规则,这一阶段的成本会低很多。
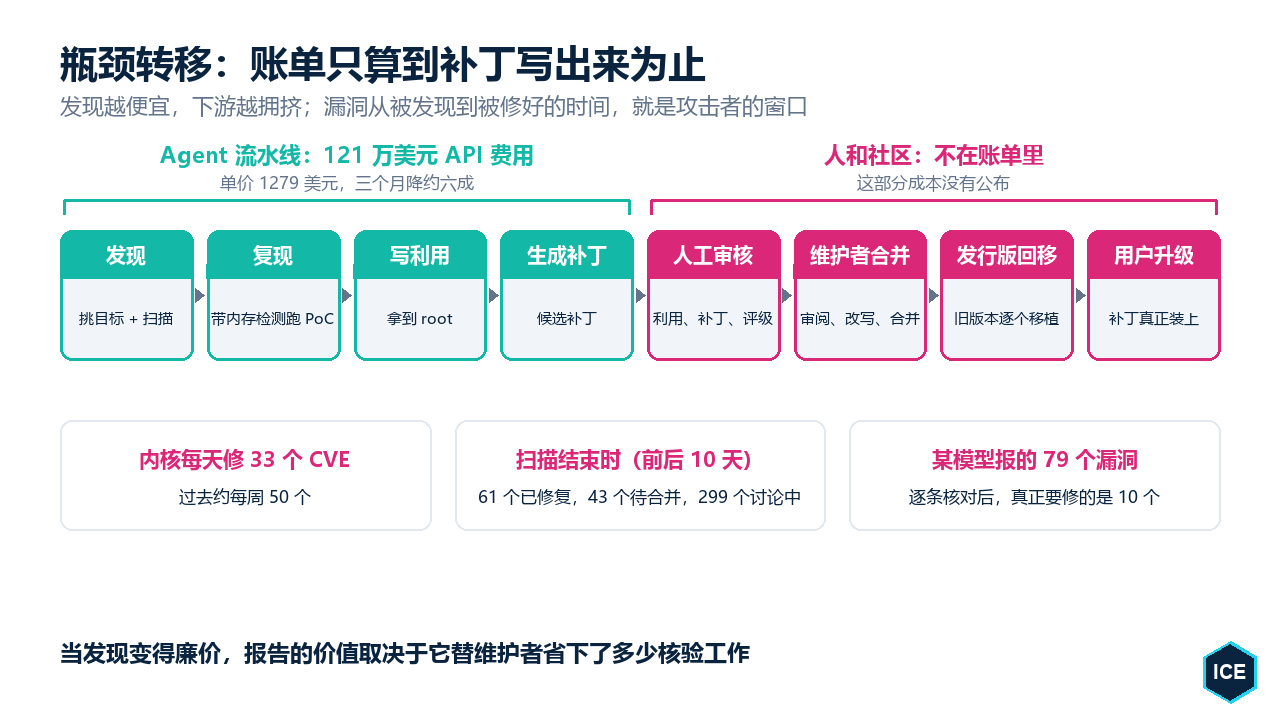
这笔账没算的东西。 121 万美元只是 API 费用。安全研究员逐个审核利用、补丁和严重性评级的人力,内核维护者审阅、合并补丁的时间,发行版回移补丁、用户升级的成本,都不在里面。OpenAI 也说明,这次关注的是方法和能力,不是成本,经过工程优化后每个阶段都能更便宜,所以这些数字更像是一个上限。
二、单价三个月降了约六成
更值得注意的是变化速度。
今年 7 月下旬,OpenAI 用 GPT-5.6 Sol 跑过一轮同样的扫描,找到并利用了 166 个不同的提权漏洞,花了 51.4 万美元,平均每个约 3094 美元。
10 月中旬换成新的安全专用模型,同样扫描当时最新的内核主线:948 个,121 万美元,平均每个 1279 美元。
两次扫描之间,内核经过了三个月的加固,新模型找到的新提权漏洞反而多了 5 倍以上,单价降了约 59%。
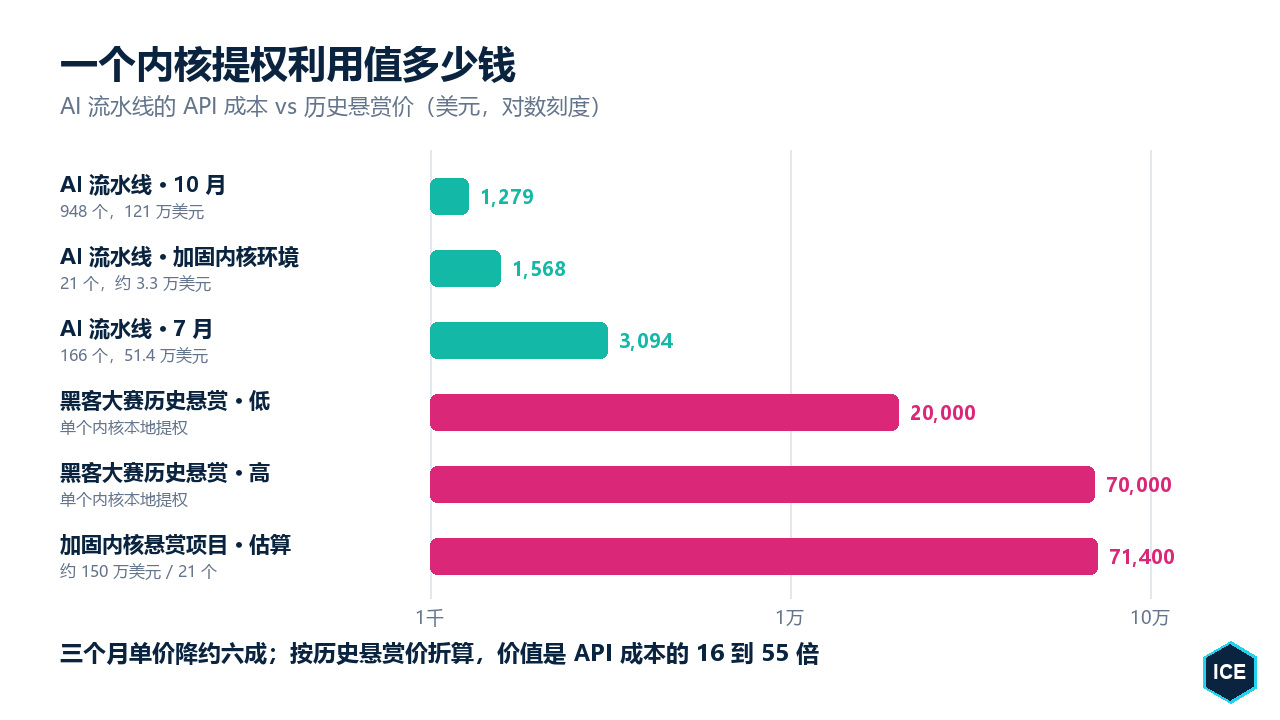
OpenAI 还在 Google 的 kernelCTF 环境里试了一次。这是一个削减了攻击面、专门加固过的内核,悬赏项目今年总共只收到 26 个确认的 0day 提权利用。流水线跑了 112 小时,花了约 3.3 万美元,做出 21 个提权利用。如果都被接受,按公开的赏金标准大约值 150 万美元,是成本的 45 倍。
OpenAI 在文中直接写了一句:按公开赏金计算,这条流水线在研究进行时是净盈利的。
这句话对攻击方意味着什么,不需要多解释。漏洞利用的市场价格,过去建立在稀缺之上:一个内核提权利用需要一位顶尖研究员花几周甚至几个月。现在,它变成了一件按件计价、单价还在快速下降的商品。
还有一个细节:OpenAI 抽查了其中 166 个利用,发现 Agent 用到了至少 10 种此前没人见过的内核利用技巧,第三方内核利用专家也确认是新的。出于安全考虑,文章没有公开细节。模型不只是在套用已知的漏洞模式。
三、瓶颈移到了下游:一天 33 个 CVE
OpenAI 在文中说得很直白:这条流水线的运营难题不是发现,而是判断哪些发现能复现、跨越了什么安全边界、哪些值得维护者最先关注。
这句话从维护者那一侧看,更加清楚。
维护者的数字
据 LWN 报道,Greg Kroah-Hartman 在今年的 Kernel Recipes 上展示了一张图:内核每个版本修复的 CVE 数量,长期稳定在 500 个左右,最近突然翻了四倍。过去一周修 50 个已经让人觉得不可思议,现在是一天 33 个。
OpenAI 自己也观察到了这个速度:扫描和人工分析结束时,前后 10 天里,已有 61 个提权漏洞在上游修复,43 个有了待合并的补丁,299 个正在公开报告和讨论。其中不少是其他贡献者独立发现的。
噪音和信号的差别
Kroah-Hartman 的核心信息是“别慌”,他认为内核社区的工具和流程扛得住。但他讲的一个例子很能说明问题。
有人打电话告诉他,某个模型找到了 79 个内核漏洞。他拿到原始数据逐条看下来:
- 24 个除了“某处崩溃了”之外没有任何细节;
- 14 个根本不是 bug,3 个是编造的数据;
- 15 个是真 bug,但在当前版本里早已修好;
- 剩下的还有 6 个重复,若干个只在内核文档明确不算安全问题的场景下成立。
最后真正需要修的是 10 个。在一个每小时合并十几个补丁的项目里,这大约是一小时的工作量。
拿这份清单和 OpenAI 的流水线对比,差别不在于谁找得多,而在于报告有没有带证据:
- 79 个那份清单,大部分是“我觉得这里有问题”;
- OpenAI 的每个漏洞都在带内存检测的内核里复现过,附带最小崩溃 PoC、根因分析、可用的利用代码和候选补丁,并经过人工审核。
内核社区现在的规则也在往这个方向走:安全报告要抄送相关维护者,报告者最好附上初始补丁,用模型生成也行;维护者有权不理会不回答问题的报告者。Kroah-Hartman 还提醒:最好的模型写补丁,仍然有一半是错的,所以每天几百个未经测试的 AI 补丁可以直接忽略。
OpenAI 在文中给的建议是同一回事:自动化分诊要考虑修补的速度,提交前把发现对照最新代码重新验证一遍,避免把别人已经修好的问题再报一次,给维护者增加无谓的审阅负担。
当发现变得廉价,一份报告的价值不再取决于“发现了什么”,而取决于它替维护者省下了多少核验工作。
这和我们在《生成过剩的时代,核验才是稀缺能力》里的判断是同一件事,只是这次落在了安全领域,而且有了具体的数字。
四、“用错了 0day”:结果对了,路径错了
OpenAI 文章里有一段很短,却值得每个做 Agent 的团队读一遍。
流水线判断利用成功的标准是“拿到了 root shell”。在一次早期运行中,利用阶段报告了 200 个成功的提权利用。人工复核后发现,其中 20 个拿到 root,用的是另一个 0day,而不是分配给它的那一个。
Agent 没有撒谎,它确实拿到了 root。但它交付的结果,和任务要求的不是同一件事。如果没有人工复核,这 20 个漏洞会被标成“已证明可利用”,而真正分给它们的漏洞其实没被验证。
OpenAI 的修正办法是收紧任务约束,并加一道独立检查,确认每个最终利用用的是被分配的那个漏洞。它的总结是:
对自主安全研究,除了核验结果,还要核验得到结果的路径。
我们在《操作回执》里讨论过同一类问题:Agent 说改了 1 行,数据库实际改了 301 行。那次是结果的范围不对,这次是结果的来源不对。共同点在于,只看最终状态,看不出 Agent 到底做了什么。
还有一个插曲。在 kernelCTF 那轮测试中,一个负责分析系统调用入口代码的 Agent 遇到了一次意外崩溃,顺藤摸瓜,在没有源码的情况下追到了模拟器 QEMU 的一个漏洞,另一个 Agent 随后为它写出了提权利用。这个漏洞在 QEMU 上游已经修复,但实验用的发行版本还没更新。
也就是说,测试环境本身也在攻击面之内。OpenAI 说它已经主动测试了自己的基础设施,并向 Kata、Docker、gVisor 等项目披露和修补了多个漏洞。我们在《智能体沙箱的瓶颈》里谈过隔离的成本,这里是隔离的另一面:隔离层本身也会被同一批模型审计。
五、另一条线:“太贵所以安全”的余量
内核漏洞讲的是“找 bug 变便宜”。DeepMind 11 月 6 日公布的两篇密码学工作论文,讲的是另一件事:有些安全性本来就是一个成本假设。
两篇论文由 DeepMind 与加州大学圣地亚哥分校的 Nadia Heninger、法国 Inria 的 Emmanuel Thomé 合作完成,对象都是已经过时的 1024 位 RSA。
第一篇:签名伪造。 场景是攻击者能让一台设备(比如硬件安全模块)按自己的意愿签名海量数据。论文证明,在 PKCS#1 v1.5 这种常见格式下,只要攻击者控制了签名数据块的一半以上,填充就不再提供额外保护。
两个协作的 Agent 把一个已发表的 1024 位伪造攻击重跑了一遍:原论文的计算用了 1380 个 CPU 核年,这次第一步只用了 391 个核年,不到原来的三分之一,在最多 30 万个 CPU 核和 16 块 GPU 上跑了 3.2 天。据报道,人类研究员在整个过程中只发了大约 20 条短消息,没写一行代码。
新闻标题里的“1600 倍”,是针对签名设备只接受 32 字节摘要这种情况的理论估计,不是实际跑出来的结果。
第二篇:批量分解。 如果要分解很多同样长度的 RSA 密钥,可以分摊一部分计算。论文提出的方法,在付出大约一次分解的预计算之后,每多分解一个 1024 位密钥,成本约为常规方法的 1/58,比 1993 年以来的最好方法便宜约 30 倍。这同样是理论结果,相关代数恒等式用 Lean 4 做了机器验证,但没有真正实现,也没有分解任何密钥。
两篇论文都明确说:2048 位及以上的 RSA 不受影响。
为什么仍然值得关注
1024 位 RSA 早已不被 NIST 批准用于生成签名,但它并没有消失:旧设备、旧证书、旧的签名服务里还有不少。更重要的是这件事暴露的逻辑。
密钥长度、迭代次数这类安全参数,本质上都是一个经济判断:“攻击要花 X 个核年,所以没人会这么做”。Heninger 团队此前的论文已经指出,在攻击者能接触签名接口的场景下,RSA 的实际安全强度要比按分解难度推算的低 15 到 30 位。现在,AI 又把“研究出更好的攻击”这件事本身变便宜了。
这和内核漏洞是同一条曲线:过去靠“太贵”守住的东西,余量都在变薄。区别只在于,内核漏洞是今天就能用的利用,RSA 这边是理论余量的收窄,给了大家迁移的时间。
六、这对我们意味着什么
对运维和平台团队:补丁延迟就是暴露窗口
OpenAI 在文中有一句非常重的判断:
在短期和中期,一个没有及时打补丁的操作系统上的低权限账号,对资源充足的攻击者来说,应当视同 root。
这句话的含义是:漏洞一旦公开,连能力弱一些的模型也可能写出利用。从披露到被利用的窗口在缩短,而内核每天在修 33 个 CVE。
几件可以马上做的事:
- 把“补丁延迟”作为一个正式指标来管,而不只是“定期升级”;
- 重新审视那些依赖内核边界做隔离的场景:多租户主机、CI 运行器、Agent 沙箱。OpenAI 建议用 Firecracker、gVisor 这类更强的隔离来限制被攻破后的影响范围;
- 盘点仍在使用 1024 位 RSA 的地方,包括 SSH 密钥、证书和签名服务;不要让不受信任的调用方直接接触原始签名接口。
对开源项目和软件团队:要求证据,每代模型重扫一次
- 报告要带证据。 参考内核的做法:要求复现步骤、运行证据和初始补丁,把“我觉得这里有问题”挡在门外。
- 写清楚威胁模型。 Kroah-Hartman 说,有时候 Agent 真的会去读这份文档,读了就不会把“恶意文件系统镜像”之类的问题报上来。
- 每代模型重扫一次。 OpenAI 的两次扫描说明,同一套流程换一个更强的模型,能在已经加固过的代码里多找出 5 倍的问题。扫过一次不等于干净了。
对安全预算:钱要往下游挪
发现的单价在快速下降,而修补的主要环节仍然靠人:审核、合并、回移、升级,单价很难同步下降。如果安全团队的预算还主要花在“找问题”上,接下来很可能出现的局面是:问题清单越来越长,真正修掉的比例越来越低。
更合理的分配,是把投入往下游挪:分诊、复现、补丁审核、回归测试、灰度发布。这些环节决定了一个漏洞从被发现到被修好要多久,而这段时间,正是攻击者的窗口。
对做 Agent 的团队:核验路径,不只核验结果
“用错了 0day”这个案例适用于所有自主执行任务的 Agent:
- 判定成功的标准,不能只看最终状态;
- 要有一道独立于执行 Agent 的检查,确认结果是通过被要求的路径得到的;
- 设置放弃条件,避免在少数难题上无限烧钱。
小结
- 漏洞有了单价。 一个 Linux 内核本地提权利用,AI 流水线做出来平均 1279 美元,三个月前约 3094 美元,历史悬赏价是 2 万到 7 万美元。而且这个数字只算了 API 费用,没算人。
- 瓶颈移到了下游。 内核每天修 33 个 CVE,维护者的时间成了最稀缺的资源。决定一份报告价值的,是它带了多少可以直接采信的证据和补丁。
- 结果对了不等于路径对了。 200 个“成功”的利用里,有 20 个用的是另一个漏洞。Agent 的产出需要独立核验路径。
- “太贵所以安全”的余量在变薄。 内核漏洞是今天的现实,RSA-1024 是理论余量的收窄。两者都在提醒:靠攻击成本守住的安全,需要重新算账。
最后留一个问题:如果明天有人用 1300 美元一个的价格,把你们核心系统的漏洞清单交到你手上,你们修得过来吗?
本文部分内容由 AI 辅助生成,经人工审校和补充后发布。
参考资料
- OpenAI. "A thousand fewer paths to root." 2026-11-04. https://openai.com/index/a-thousand-fewer-paths-to-root/
- Jonathan Corbet. "Coping with the onslaught of kernel security bugs." LWN.net, 2026-10-01. https://lwn.net/Articles/1097860/
- SecurityWeek. "AI Agents Got Root on Linux via 948 Kernel Flaws in OpenAI Research." 2026-11. https://www.securityweek.com/ai-agents-got-root-on-linux-via-948-kernel-flaws-in-openai-research/
- Phoronix. "OpenAI Finds 948 Local Privilege Escalation Bugs In The Linux Kernel." 2026-11. https://www.phoronix.com/news/OpenAI-948-Linux-LPE-Bugs
- Interesting Engineering. "Google DeepMind finds 1,600x faster way to expose encryption flaws." 2026-11. https://interestingengineering.com/ai-robotics/1600x-faster-google-deepmind-agents-expose-weaknesses-in-older-encryption-methods
- Neural Brew. "Google DeepMind: AI Agents Find Two Weaknesses in 1024-Bit RSA, Leaving RSA 2048 Unaffected." 2026-11. https://neuralbrew.ai/en/articles/2026/11/google-deepmind-ai-agents-cryptanalysis-rsa-1024/
- IA Compa. "Google DeepMind's AI agents sharpen two attacks on legacy 1024-bit RSA." 2026-11-06. https://iacompa.com/news/2026-11-06-google-deepmind-ai-agents-legacy-rsa-1024-cryptanalysis
- Miro Haller, Adam Suhl, Nadia Heninger et al. "Forging 1024-bit RSA signatures in nearly SNFS time." IACR ePrint 2026/2131. https://eprint.iacr.org/2026/2131