模型能力的“可用不可见”,比数据难在哪里
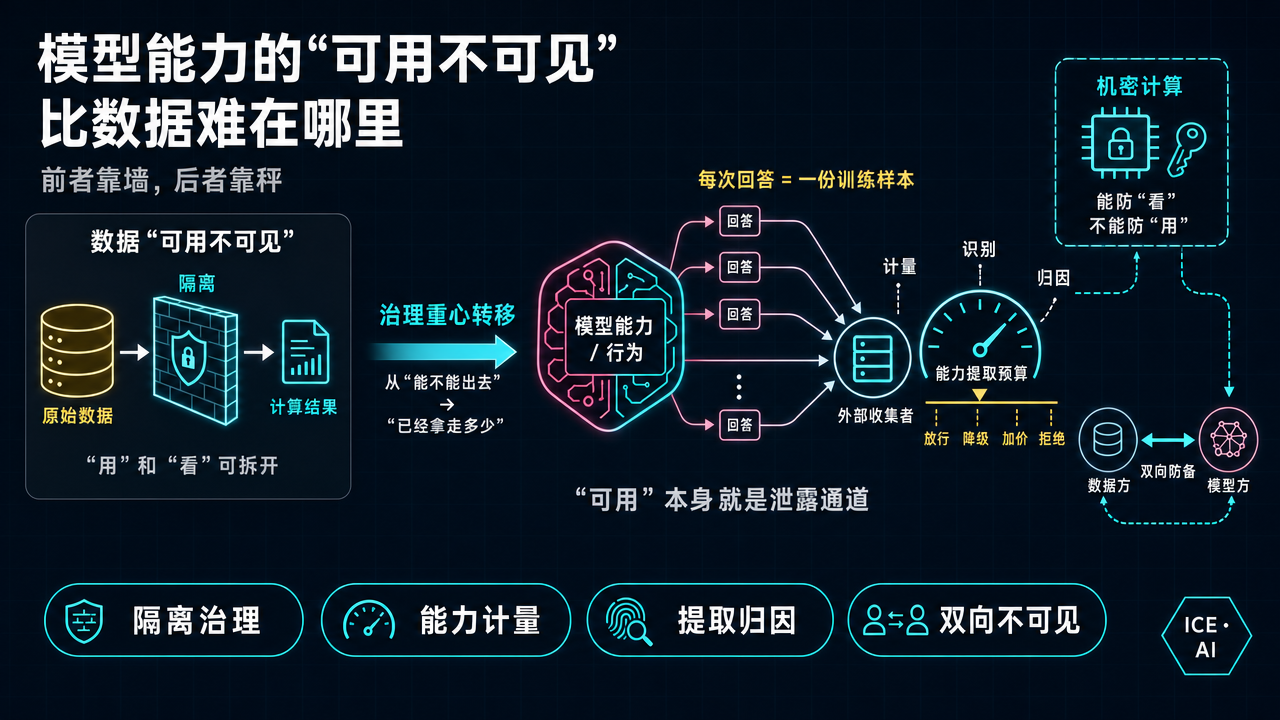
数据圈有一句流传很广的话:数据“可用不可见”。不把原始数据交出去,也能允许别人用它完成计算、获得结果。
现在,同一套思路开始进入模型服务。反蒸馏措施正在限制完整推理过程的流出:客户可以调用模型,却不能借此无限复制模型“怎么想”。
这个类比很诱人,却只对了一半。
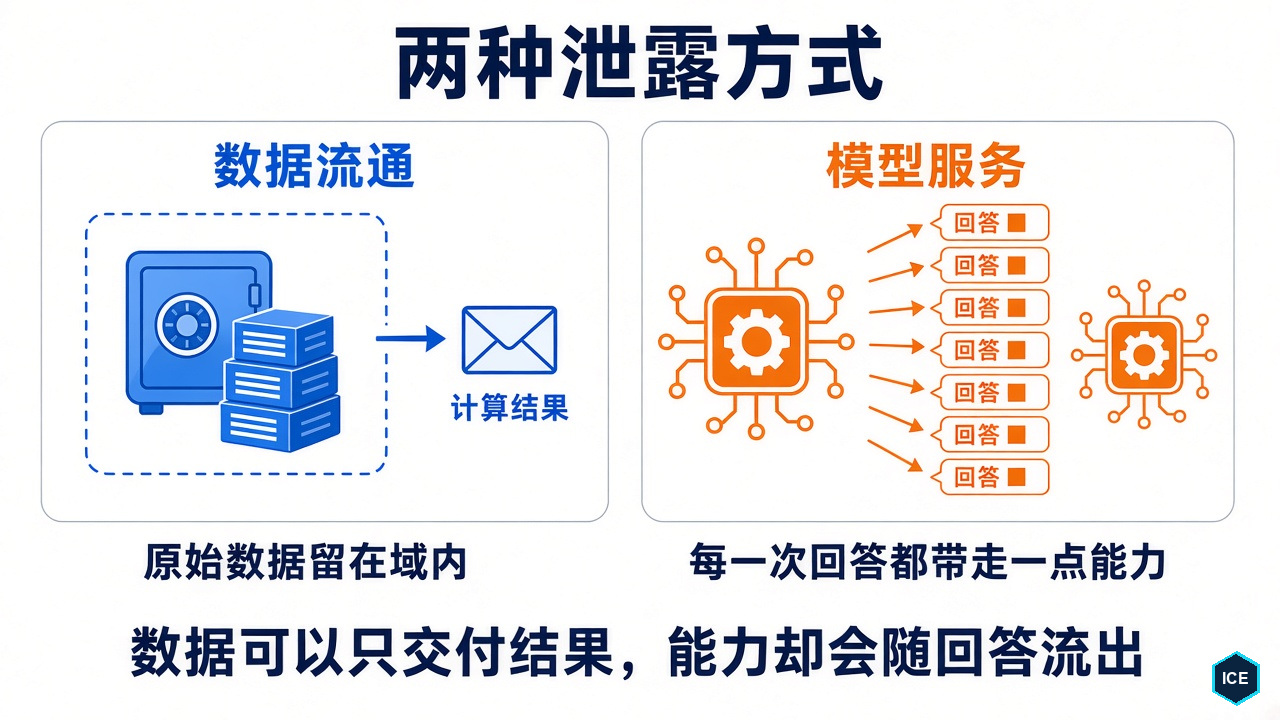
数据可以留在域内,只让计算结果流出;模型能力却要通过输出才能被使用,而每一次输出又都在暴露能力。因此,把“可用不可见”从数据搬到模型能力,不是换个对象套用同一个框架。它至少带来三处变化:可用本身就是泄露通道,治理要从“隔离”走向“计量”,而在私有化部署和智能体场景中,“不可见”还会变成双向要求。
数据的“不可见”,为什么能成立
先回到数据。可信数据流通里的“不可见”能够成立,靠的是一个前提:原始数据和计算结果可以分开。
医院不把病历交给药企,而是让药企的统计模型进到院内环境里跑,只带走“某类药物有效率提升了多少”这样的结果。隐私计算、可信执行环境、数据沙箱、可信数据空间的连接器,技术路线各不相同,做的都是同一件事:让计算过去,让结果出来,让原始数据留下。
这道界线并非绝对安全。反复查询细粒度统计结果,也可能推断出个人信息。因此,数据领域还需要结果审核、最小粒度限制和差分隐私等手段。不过,原始数据与计算结果仍然是两个可以分别控制的对象,治理可以围绕“什么留在域内、什么允许出域”来设计。
4 月那篇《告别“物理占有欲”》讨论过使用方对“看不见”的焦虑。这里想强调的是另一面:数据之所以能做到“可用不可见”,是因为“用”和“看”在技术上可以拆开。
模型能力恰恰拆不开。
第一处变化:能力的“可用”,本身就是泄露通道
模型服务里,被保护的东西是什么?
表面上看,被保护的是权重文件。但在 API 场景中,权重本来就锁在服务端。真正会随调用流出的,是模型表现出来的行为:它怎样理解问题、拆解任务并组织答案。
问题就在这里。对模型来说,交付结果的同时,也在交付能力的样本。 每一次问答都可以成为一份训练材料:问题是输入,回答是标签。单个回答当然不等于模型能力,但当样本足够多、覆盖足够系统时,别人就可能据此训练出行为相近的模型。
这不是新发现。早在 2016 年,学术界就有研究演示了如何只通过预测接口,复制出云上机器学习模型的功能,这类攻击被称为“模型窃取”或“模型提取”。大模型时代的蒸馏攻击,只是把它放大到了工业规模。
差别由此出现。数据流通可以把统计结果与原始记录隔开,只要同时防范结果反推,原始数据就不必离开控制域;模型服务却必须用输出来兑现能力,攻击者收集的每个回答都可能增加复制能力的训练材料。
所以,模型能力的“不可见”,不可能只靠一道绝对的墙来实现,而只能成为一种受控状态。 我们无法做到“能力可用,却一点也不流出”;能做的是降低单次输出携带的可复制信息,并控制累计流出的速度、规模和去向。
第二处变化:从“隔离”转向“计量”
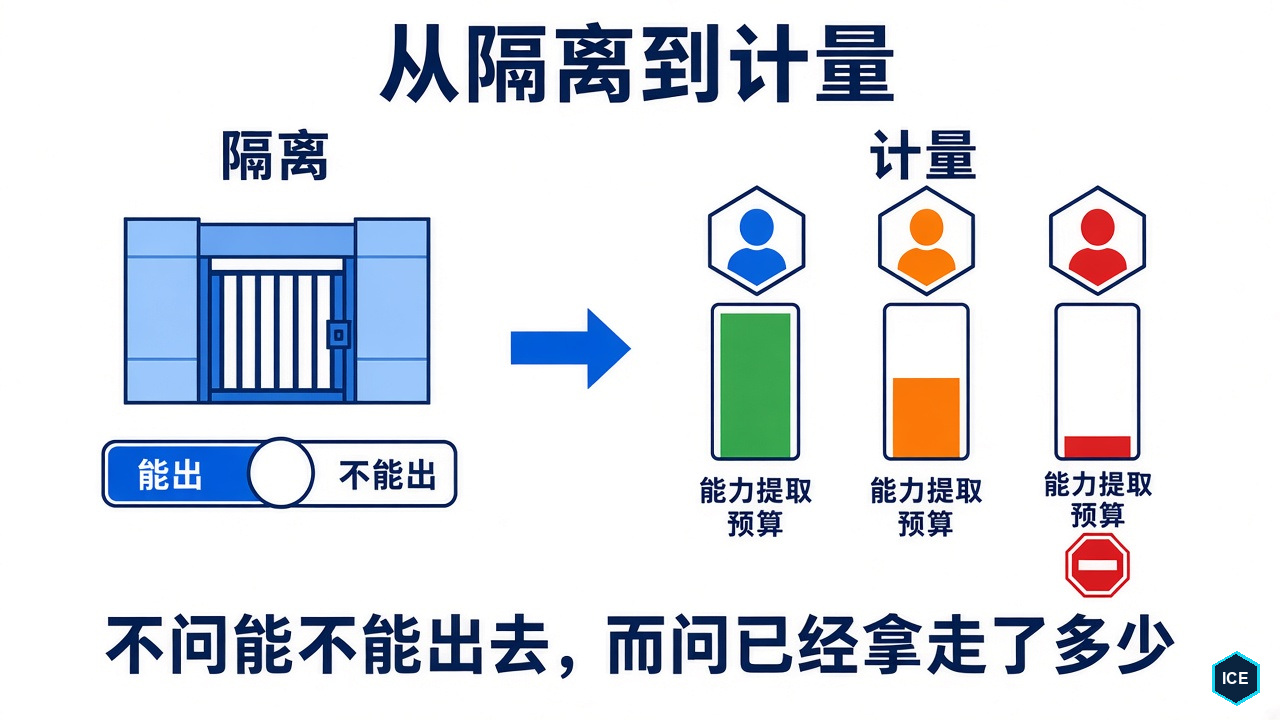
既然无法彻底隔离,治理的重心就会发生转移。
数据领域首先依赖隔离:划定边界,原始数据不出域,只有经过控制的结果可以离开。问题通常是“什么能出去、什么不能出去”。
模型能力则必须增加计量:每一次回答都可能贡献一份可用于复制的材料,关键变成谁在调用、累计获得了什么、到什么程度应该降级或停止。问题从“能不能出去”,变成了“已经拿走了多少”。
这并非全新的思路。差分隐私承认查询结果会带来信息暴露,并用“隐私预算”刻画多次查询累积的风险。借用这种“为累计暴露记账”的思想,可以为模型服务提出一个概念:能力提取预算。
它不是差分隐私的数学移植,而是一种治理框架:对每个调用主体,估算其通过持续调用获得了多少可复制材料,再据此决定放行、降级、加价还是拒绝。
回头看 Anthropic 的三道防线,几乎都可以用这个框架重新理解:
- 推理只给摘要,是降低每一次回答的“含能量”,让单次泄露变小;
- 限流、封号,是给单个账号设上限,防止预算被一次性花光;
- 识别代理网络,是把分散在两万个虚假账号上的消耗合并计算,防止攻击者把一份大预算拆成无数份小预算;
- 被拦截的请求照常计费,是让试探边界本身也要付出代价。
这个转变带来一个直接后果:模型能力治理不能只靠加密,还必须具备识别和归因能力。 平台得知道谁在问、问了什么、分散账号是否属于同一主体,以及这些调用更像正常使用还是系统采集。这更接近反欺诈和风控,而不只是传统的数据安全。
这个预算目前无法精确计算。差分隐私的预算有严格的数学定义,“能力提取量”却没有统一单位。一个账号问了十万个编程问题,可能是正常的大客户,也可能在系统采集。真正困难的不是记录调用量,而是判断哪些调用构成能力提取、多个身份背后是否属于同一主体。因此,现阶段的防护仍要依赖分类器、行为特征和人工研判,也必然伴随误报。
第三处变化:“不可见”变成双向的
前两处变化主要发生在 API 场景:模型在厂商手里,用户通过接口调用。站在模型方的视角,需要重点防范调用方系统性提取能力。
但企业用模型,并不只有 API 这一种方式。
很多政企客户的第一要求是:数据不能出域。 病历、交易记录、工艺参数和政务数据,往往不能直接发到外部模型厂商的服务器上。于是企业选择私有化部署,把模型搬进自己的控制域。
这样一来,问题就反过来了:
- 走 API,是数据方把数据交给模型方。数据方担心的是:我的数据会不会被看见、被留存、被拿去训练?
- 做私有化部署,是模型方把权重交给数据方。模型方担心的是:我的权重会不会被复制、被转卖、被拿去微调成竞品?
两边都想要“可用不可见”,方向却正好相反。数据方要的是“我的数据可用,但你看不见”;模型方要的是“我的模型可用,但你看不见”。 双方不一定互不信任,却都不能把安全建立在对方永不越界的承诺上。
这个两难并不是理论推演。开源与闭源模型之争、权重外泄事件、头部厂商对私有化部署的保留态度,背后都是同一个问题:一旦把权重交出去,就几乎无法收回。
智能体会让这个问题更复杂。智能体不只是回答问题,还要在客户环境里读数据、调工具、做决策。它既需要深入数据域,又携带着模型方的能力和提示工程。数据方的边界和模型方的边界,在同一个运行时里交叠。
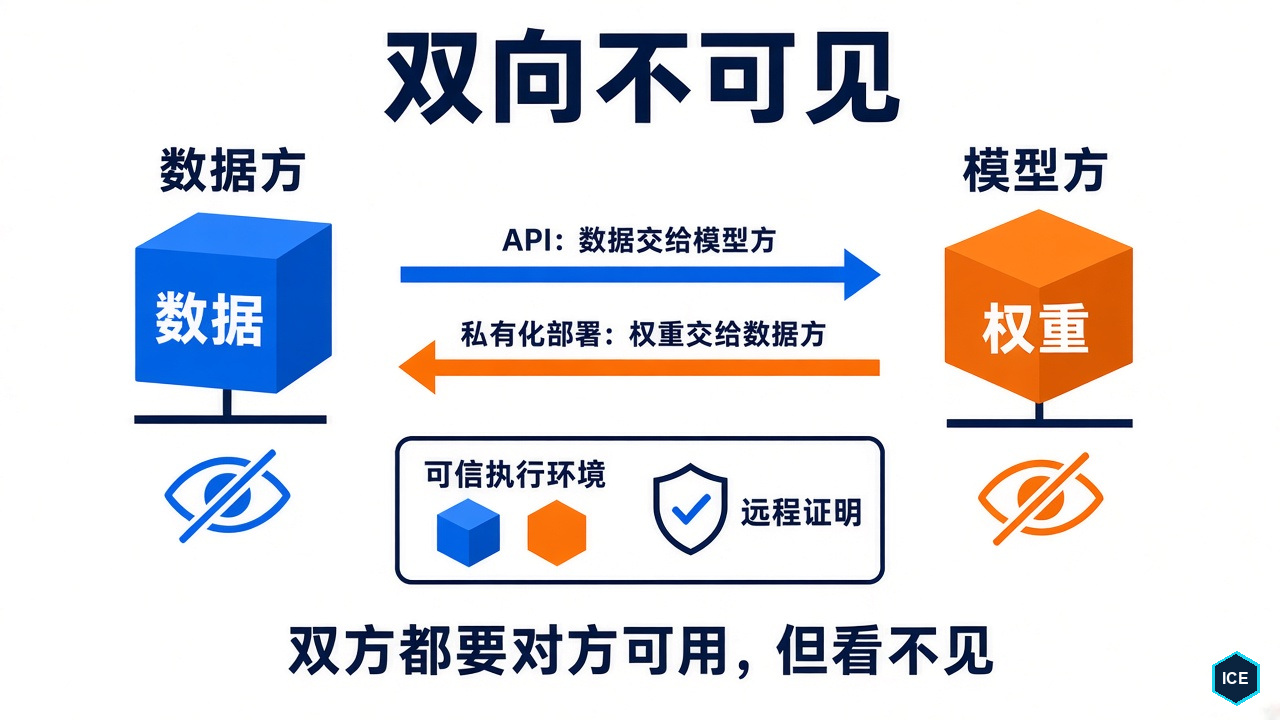
技术上,机密计算提供了一种可能:在经过远程证明的可信执行环境里运行模型。数据方确认环境符合预期后才送入数据,模型方确认环境可信后才释放权重解密密钥,双方原则上都不直接接触对方的明文。新一代 GPU 已开始支持这类能力。
但需要说清楚它的边界。8 月那篇讲 CPU 与 GPU 联合证明的文章提到过:可信执行环境不防物理接触,侧信道研究也在不断出现,机密模式还有可观的性能开销。它能把信任从“相信对方”转移到“相信硬件和证明链”,但没有消除信任。
更关键的是,机密计算主要解决运行过程中“权重和数据不被直接看见”,解决不了第一处变化。 即使权重得到保护,只要一方能够不受限制地反复调用模型,仍可能通过输出训练替代品。硬件可以约束“看”,却不能单独约束“用”;最终还是要回到身份、用途和用量的计量。
这对从业者意味着什么
第一,数据要素治理和模型服务治理会逐步合流。 访问控制、用途约束、使用审计和流向追踪,正在从可信数据空间进入模型服务;模型服务里的行为风控、提取识别和动态限额,也会反过来补充数据流通治理。做数据要素的团队和做模型安全的团队,迟早要坐到一张桌子上。
第二,合约、技术控制和计价方式要协同变化。 合约可以约定调用量上限、禁止用输出训练竞品、不得批量转售,但条款只有配合身份识别、审计和限制手段才可执行。计价也可能从单纯“按 Token 收费”,演化出按调用风险设置额度、价格和验证强度。
第三,企业要重新盘点自己的“能力资产”。 把专家经验做成智能体、把业务规则封装成接口,开放服务的同时也打开了提取通道。在开放之前,至少要回答三个问题:哪些能力一旦被复制就会失去壁垒?谁在调用?调用模式更像在“用”,还是在“学”?
结语
数据的“可用不可见”,主要回答“什么不能被看见”;模型能力的“可用不可见”,还要回答“能被学走多少”。前者首先靠墙,后者还必须有秤。
因此,“可用不可见”不足以概括模型能力治理。更准确的目标也许是:可用、可计量、可归因。 承认能力会随输出流出,再管住流出的速度、规模、主体和去向。
你所在的团队,现在更担心哪一种“被看见”:数据被模型方看见,还是能力被使用方学会?
参考资料
- Anthropic,《Strengthening our defenses against distillation attacks》,2026-10-12 — https://www.anthropic.com/research/distillation-defenses
- Florian Tramèr 等,《Stealing Machine Learning Models via Prediction APIs》,USENIX Security 2016 — https://www.usenix.org/conference/usenixsecurity16/technical-sessions/presentation/tramer
- Cynthia Dwork、Aaron Roth,《The Algorithmic Foundations of Differential Privacy》,2014 — https://www.cis.upenn.edu/~aaroth/privacybook.html
本文部分内容由 AI 辅助生成,经人工审校和补充后发布。