训练合法,下载违法:15 亿美元第一次给数据来源标了价

三位美国作家起诉 Anthropic,说它拿自己的书训练了 Claude。2025 年 6 月 23 日,审这个案子的 Alsup 法官写下这样一句判断:用书训练大语言模型「具有转换性——而且是惊人地具有转换性」,是「我们许多人一生中会见到的最具转换性的用途之一」。合理使用成立,训练这一项作家们输了。
一年后,2026 年 7 月 20 日,接手同一案子的 Martínez-Olguín 法官批准了双方的和解方案:Anthropic 向作家们支付 15 亿美元,涵盖 482,460 部作品,每部约 3,000 美元,外加一道销毁令。法院称其为史上最大的版权集体诉讼和解。
所以这 15 亿不是为训练付的。法院认可用书训练 Claude,不认的是那 700 万本书的来路:它们是从 LibGen 这类盗版网站下载来的,攒成了一个内部图书馆。
一、判决把一件事切成了两半
案子 2024 年 8 月立案,案名 Bartz v. Anthropic(下文简称 Bartz),三位原告是作家 Andrea Bartz、Charles Graeber 和 Kirk Wallace Johnson。指控有两层:Anthropic 用他们的书训练 Claude;以及从 LibGen、PiLiMi 这类影子图书馆下载了七百多万本受版权保护的书,存进一个内部「中央图书馆」留作未披露的将来用途。注意原告没有主张 Claude 的输出侵权——这个案子从头到尾只关于训练和留存。
Alsup 法官把它切成两半,给出了两个相反的答案。
训练那一半,原告输了。 法院认为把整本书喂进去是「合理必要的」,训练数据从不展示给用户,也不替代原书的市场;合理使用第四要素防的是替代,不是竞争。判决里那个类比后来被引用了无数次:
要求任何人在每次阅读一本书时、每次从记忆中回想它时、每次在写新东西时借鉴它时,都为使用这本书单独付费,这是不可想象的。
法院还多走了一步,明确说作者无权就训练主张许可费,训练数据许可市场不是版权法赋予作者可以开发的市场。这一步很关键,第三节要回到它。
盗版获取和留存那一半,原告赢了。 下载并保存七百万本盗版书不受合理使用保护,因为为了训练并不需要这么做。Anthropic 后来改用合法购买的书来训练,也不能免除最初下载和保存的责任。法院的说法是,不存在因为最终用途可能具有转换性就获得的「免罪卡」,并且对「任何后续的合理使用」能否正当化盗版下载表达了明确怀疑。
最能说明这条边界的是 Anthropic 的另一个做法。它有一个内部项目,做法是买入纸质书、拆开扫描成数字文件、销毁原件。法院认定这属于合法的转换性合理使用。
洞见一:同一批比特的法律地位由获取路径决定,不由用途决定
买书扫描得到的文件和从 LibGen 下载得到的文件,对模型来说是同一批 token,训练效果没有区别。但一条路径合法,另一条路径值 15 亿美元。这意味着数据的法律成本不是一个关于「你拿它做什么」的函数,而是一个关于「你怎么拿到它」的函数——而后者在企业内部通常没有任何人负责记录。
二、这笔钱是怎么算出来的:从存在性风险到每部 3,000 美元
先看没有和解的话会是什么局面。版权法定赔偿在故意侵权的情况下可达每部作品 15 万美元。按作品清单上的 482,460 部算,理论上限约 724 亿美元;按七百万本的下载规模算,量级进到万亿。这不是「一笔巨额罚款」,是公司层面的存在性风险。和解发生在赔偿审判已经排上日程的时候。
| 口径 | 金额 | 说明 |
|---|---|---|
| 法定赔偿理论上限(按作品清单) | 约 724 亿美元 | 每部 15 万 × 482,460 部 |
| 实际和解总额 | 15 亿美元 | 约为上述上限的 2% |
| 每部作品(税费前) | 约 3,000 美元 | 集体成员名义所得 |
| 律师费与费用 | 3.02 亿美元 | 申请 3 亿(20%)+ 200 万开支 |
| 每部作品(扣费后) | 约 2,483 美元 | 实际到手 |
| 作品清单覆盖比例 | 约 6.9% | 482,460 / 700 万 |
最后一行值得停一下。下载了七百万本,进入作品清单的只有约 48 万部。 剩下的九成三不是被判定合法,是没进这次索赔——权利人不明、未登记、不在类别定义内,或者干脆没人来认领。换句话说,有价格的只是被数过的那一段。
还有两条不在钱里但更要紧的边界。和解的责任免除不覆盖模型输出引起的主张,也不覆盖 2025 年 8 月 25 日之后发生的行为。也就是说,这 15 亿买断的是一段有明确终点的历史,8 月 25 日之后的获取行为完全暴露在外。
洞见二:和解价不是价格,是止损;但市场只会记住那个数
15 亿是「审判风险 × 败诉概率」和「继续打下去的生存风险」之间的一个妥协,它不是任何人对一部作品的估值。但它现在是锚:后续每一场谈判、每一份尽职调查、每一笔许可报价,都会以每部 3,000 美元为参照点。音乐出版商随后就动议修改对 Anthropic 的诉状,加入类似的盗版主张。定价一旦出现,就会被复用。
三、两个法官,两套逻辑:合理使用这一战原告基本输了
Bartz 之后两天,2025 年 6 月 25 日,Chhabria 法官在 Kadrey v. Meta 里作出了部分驳回,也认定训练具有转换性。但他在两处走得比 Alsup 法官更远。
第一处,他明确认定训练构成合理使用,无论底层材料是否来自盗版渠道——正面偏离了 Alsup 法官在获取路径上留下的怀疑。
第二处,他把原告关于许可市场的论证批为循环论证:
如果为转换性用途支付许可费的损失可以构成可诉的损害,那原告每次都会赢。
同一份意见里还有另一段裁定:关于训练 Llama 时剥离版权管理信息(CMI)的 DMCA 主张,Meta 胜。理由是既然训练构成合理使用,剥离 CMI 就没有促成任何侵权,而法条要求的正是「诱导、促成、便利或掩盖侵权」。这一点第五节要用到,它是理解 2026 年这批新诉状的关键。
但 Chhabria 法官在同一份意见里写下了这段话,语气重得不像法官对胜诉方说的:
这份裁定并不代表 Meta 使用受版权保护的材料训练语言模型是合法的。它只代表这些原告提出了错误的论证,并且没有为正确的那个论证建立起证据记录。
他随后点出了那个「正确的论证」:不是输出会复制原文,也不是失去了许可费,而是模型会用大量相似文本淹没市场、稀释原作。而其中有个刺人的转折——正因为这类书是更好的训练材料,用它们训练出的模型才更擅长稀释它们自己的市场。原告没有为这条建立任何证据记录,所以他判了 Meta 胜。
洞见三:原告在合理使用上连续失利,但失利的方式指明了下一条路
到 2025 年底,「训练是否合理使用」这个问题上,两位加州北区的法官给出的答案都对 AI 公司有利,其中一位还把盗版来源这个变量也一并排除了。原告方从中读出的不是「打不赢」,而是别在这个战场上打。Chhabria 法官那段话几乎是一份操作说明:论证错了,证据记录没建。2026 年的新诉状全部是照着这份说明重写的。
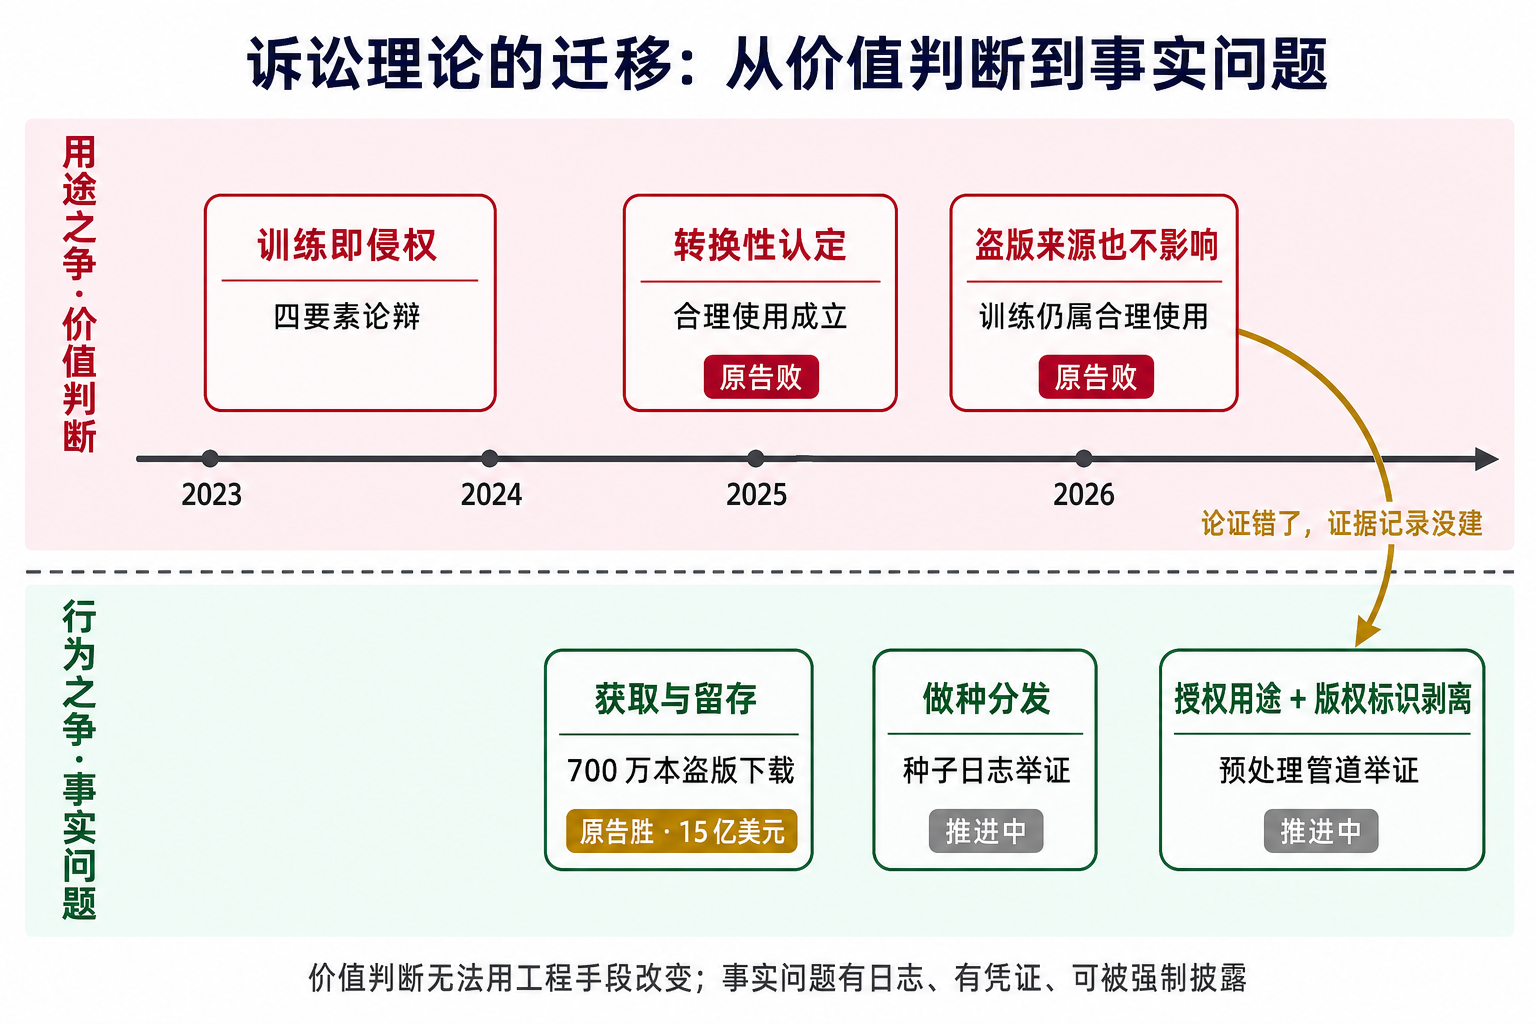
四、战场换了:从用途之争到行为之争
三个动作发生在九个月之内。
做种。 Kadrey 里有一批主张在合理使用裁定后存活了下来:Meta 通过 BitTorrent 下载盗版书时,是否同时把这些书的片段分发给了其他用户。2025 年 12 月 11 日原告动议追加帮助侵权主张,理由是新的日志数据显示存在大规模种子活动,而他们此前「对 Meta 如何获得作品一直不清楚」。2026 年 3 月法院准许这一理论继续推进。注意这里的转向:不再问训练是否合法,而问下载过程本身是否构成向第三方分发。
授权用途。 2026 年 7 月 10 日,Hachette Book Group、Cengage Learning、Elsevier 加上作家 Scott Turow 在纽约南区对 Google 提起集体诉讼。这份诉状最值得看的地方是它没有采用那套已经失败的「训练即盗窃」框架。它说的是:Google 对这些书和期刊文章本来有合法访问权——通过 Google Books、Google Play、Google Scholar 取得——但授权范围是特定用途,而不是训练一个商业生成式 AI 系统。这是一条贴着合同走的理论,它不需要否定 Alsup 法官和 Chhabria 法官的任何判断,因为争点根本不是训练的性质。
剥离标识。 同一份诉状追加了 DMCA 第 1202(b) 条主张:Google 在数据预处理阶段系统性地移除了版权声明、作者名、权利人标识等版权管理信息。诉状的措辞是,这样做是为了「向权利人、Gemini 用户和公众隐瞒其模型是用被窃材料训练的」。
| 用途之争 | 获取之争 | 行为之争 | |
|---|---|---|---|
| 核心主张 | 训练本身构成侵权 | 语料来自盗版渠道 / 超出授权用途 | 做种分发、剥离版权标识 |
| 争的是什么 | 一个价值判断 | 一个事实 | 一个事实 |
| 证据在哪 | 无法直接举证,靠四要素论辩 | 采购凭证、下载记录 | 种子日志、预处理管道 |
| 合理使用能否挡住 | 能,且已经挡住两次 | 部分不能(Bartz 已判) | 取决于底层侵权是否成立 |
| 赔偿口径 | 每部作品最高 15 万美元 | 同左 | 版权同左;1202 条按每次违规 |
| 目前战绩 | 原告连败 | 原告在 Bartz 胜,值 15 亿 | 在推进中 |
洞见四:从价值判断迁移到事实问题,意味着风险从法务转到了工程
「训练是否具有转换性」是一个律师在法庭上论辩的问题,公司内部无法通过任何工程手段改变结果。「这批语料从哪来的」「预处理时删掉了哪些字段」「下载时上行带宽跑了多少」则完全是工程问题——它有答案,答案写在日志、种子记录、数据管道和采购单里,而且这些答案是可被强制披露的。责任的位置变了。
五、CMI 那条不是独立的后门,是乘数
这里最容易读错,所以要说清楚。
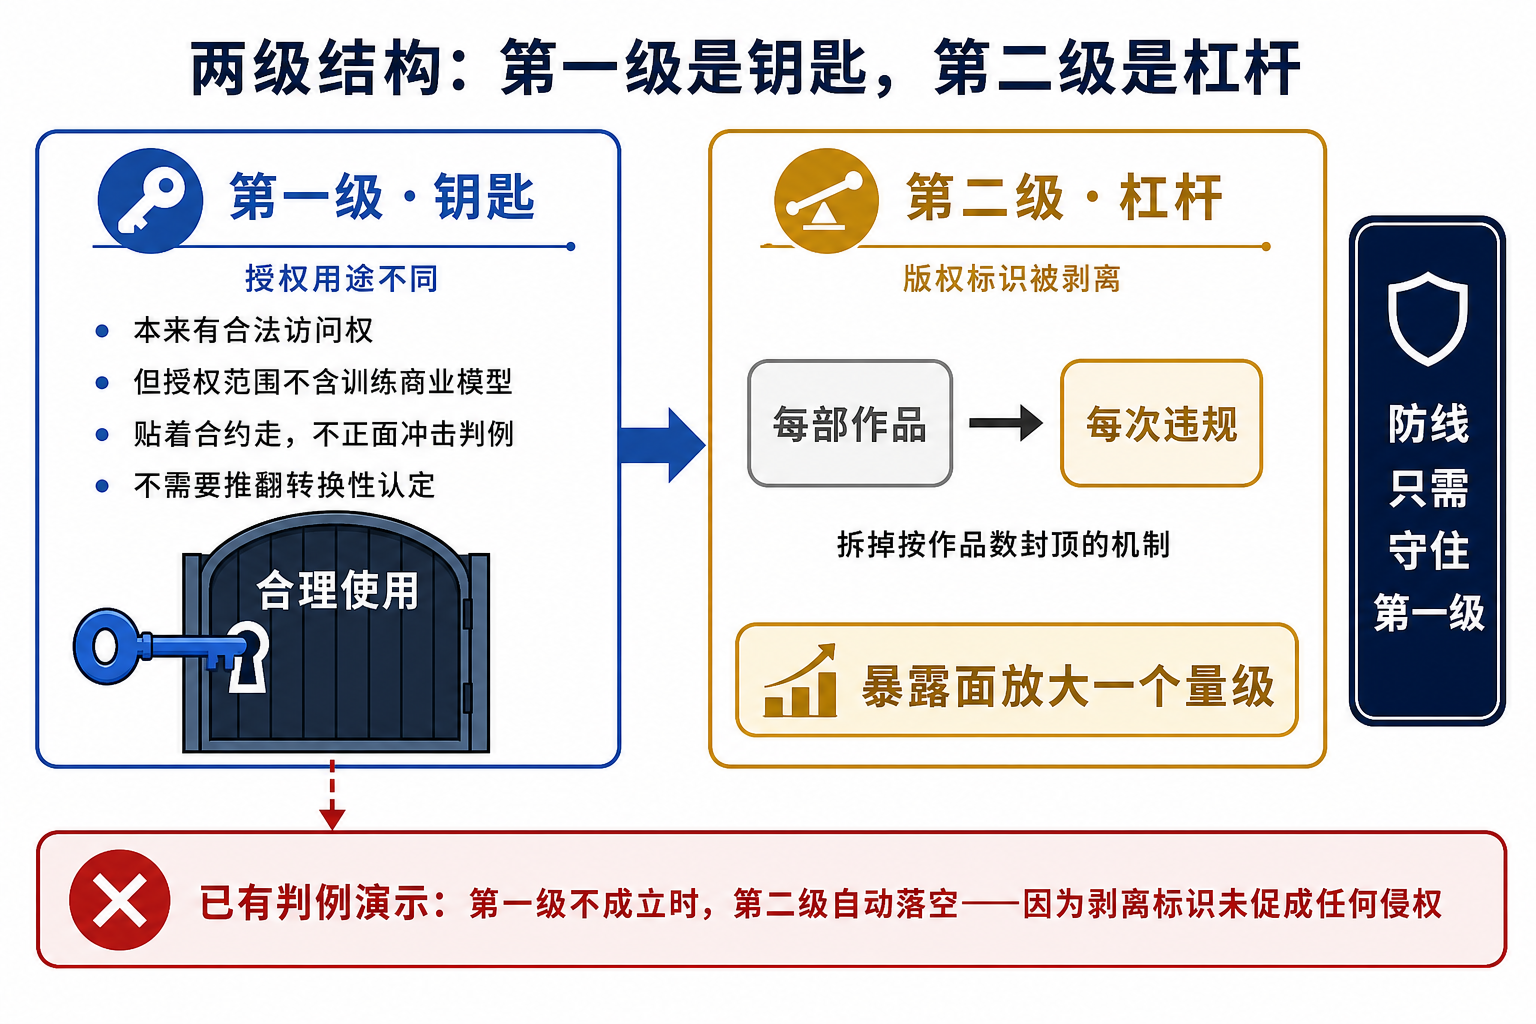
DMCA 第 1202 条不是绕开合理使用的独立通道。 Kadrey 已经演示过:Chhabria 法官认定训练构成合理使用,于是剥离 CMI 没有促成任何侵权,主张直接落空。也就是说,1202 条依附于底层侵权成立。如果 Hachette 那边凿不开合理使用这道门,CMI 这条同样会落空。
但一旦底层成立,量级就不是同一个数量级的问题了,因为两套法定赔偿的计数单位不同。
| 版权侵权法定赔偿 | DMCA 第 1202 条法定赔偿 | |
|---|---|---|
| 计数单位 | 每部作品 | 每次违规 |
| 幅度 | 750 美元起,故意侵权最高 15 万 | 2,500 至 25,000 美元 |
| 「每次违规」通常怎么算 | 不适用 | 少数解释过的法院倾向按每次分发 / 每次呈现计 |
| 是否需要版权登记 | 需要(否则一般无法主张法定赔偿和律师费) | 不需要 |
| 上限逻辑 | 无论侵犯了多少项专有权,按作品数封顶 | 无按作品封顶的机制 |
版权法那一栏有个封顶逻辑:不管你侵犯了多少项专有权、造成了多少次侵权,赔偿按作品数算。1202 条没有这个封顶。一部作品如果被剥离了 CMI 并分发多次,理论上每次都是一次独立违规。法学文献对此的评价相当直白——这个特征让 1202 条主张「对机会主义原告和纯粹的版权巨魔极具吸引力」,在集体诉讼里尤其如此。
洞见五:这是一个两级结构,第一级是钥匙,第二级是杠杆
Hachette 的诉状可以这样读:第一级用「授权用途不是训练商业模型」去凿开合理使用——这一级不与既有判例正面冲突,因为它是合同相邻的理论;第二级用 CMI 主张把赔偿口径从「每部作品」换成「每次违规」,从而拆掉那个封顶。钥匙不值钱,杠杆才值钱,但没有钥匙杠杆用不上。 反过来说,AI 公司的防线只需要守住第一级;一旦第一级被凿开,暴露面会突然放大一个量级。
六、举证本身就是一笔钱
责任移到事实层面之后,取证的规模变了。
针对 OpenAI 的十二起案件 2025 年 4 月被合并成多区诉讼,交由纽约南区审理。2025 年 10 月 27 日,法院驳回了对方的驳回动议,认定「原告已主张存在若干输出,理性的陪审团可能认定它们与原告作品实质性相似,这已足以击败该动议」。随后是取证。
2026 年 1 月 5 日,法院命令交出两千万条输出日志,并在裁定里写道:
OpenAI 没有指出任何判例要求法院下达负担最小的取证令,也没有要求法院具体说明为何拒绝一方提出的取证方案。
2026 年 3 月 9 日,法院又准许原告的强制取证动议,在已经下令交出的两千万条之外,追加七千八百万条和一千万条。合计约 1.08 亿条输出日志。
洞见六:可发现性正在变成主要风险面
这批日志不是为了证明某一次输出侵权,是为了在一亿多条里找出足以支撑集体主张的样本。它的直接后果是:任何为了运营或改进而保留的记录,在这类诉讼里都是证据。 而诉讼周期在这里反过来起作用——这类案子从立案打到取证就是好几年,长到你现在写下的每一行日志都会活到被调取的那一天。数据保留策略从此不只是隐私和成本问题,它是诉讼暴露面的直接控制变量。
七、反身性:行业每签一笔许可,都在为下一批原告补齐证据
Alsup 法官说作者无权就训练主张许可费,训练数据许可市场不是版权法赋予作者可开发的市场。Chhabria 法官说得更直接:如果失去许可费本身就构成损害,原告每次都会赢,这是循环论证。
两位法官都对。但他们的理由依赖于一个经验前提:这个市场当时还不存在。
现在它开始存在了。Disney 与 OpenAI 签了一份为期三年的协议,Sora 可以生成包含 200 多个 Disney 角色的短视频,连同服装、道具、载具和场景;Disney 同时向 OpenAI 投资 10 亿美元并成为大客户。而 Disney 本身正在中加州地区法院起诉 Midjourney,主张的是训练时的复制和输出端持续生成衍生形象。同一家权利人,一边诉讼一边许可。
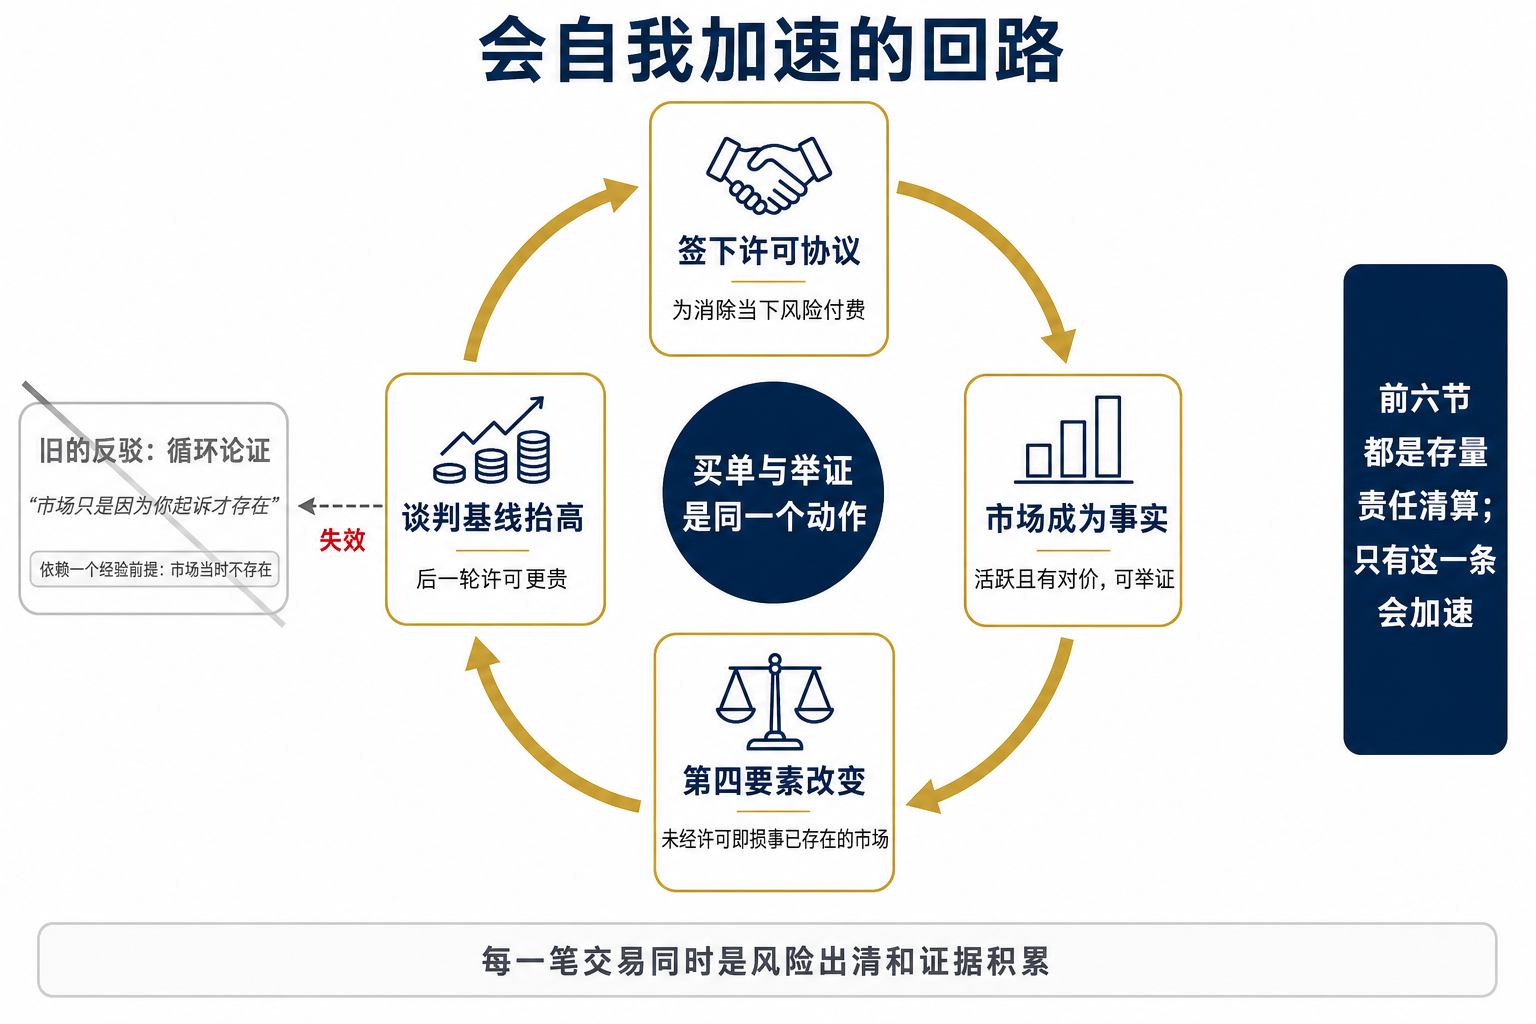
这就构成一个回路。许可交易签得越多,「存在一个活跃的、有对价的训练数据许可市场」就越是一个可举证的经验事实;这个事实一旦坐实,第四要素(市场影响)的分析就变了——未经许可的使用会被视为损害了一个已被证明存在的市场。而循环论证的反驳恰恰在这里失效:当市场已经是事实,「原告主张的市场只是因为他起诉才存在」这个批评就没有对象了。
洞见七:Chhabria 法官那句「循环论证」有保质期,保质期由行业自己签下的许可协议数量决定
这是全篇唯一一条会自己加速的机制。前六节讲的都是存量责任的清算——已经下载的书、已经剥离的标识、已经留下的日志。这一条不同:它意味着 AI 公司为消除当下风险而支付的每一笔许可费,都在同时抬高未经许可者的败诉概率,也在抬高自己在下一轮谈判里的成本基线。买单和举证在这里是同一个动作。
结论
四条可以带走:
训练数据的法律成本挂在获取路径上,不挂在用途上。 买入纸书扫描和从影子图书馆下载,得到的是同一批 token,但一条合法、另一条值 15 亿美元。这意味着尽职调查的问题不是「你们怎么用这批数据」,而是「这批数据每一部分的来路,你们能不能出示凭证」——而在多数公司里,这个问题目前没有责任人。
和解价不是价格,是止损;但它已经成了锚。 15 亿美元是相对理论赔偿上限约 2% 的妥协,覆盖的作品只占下载规模的约 6.9%——有价格的只是被数过的那一段。可是每部 3,000 美元这个数已经进入市场,后续的谈判、许可报价和风险准备金都会以它为参照。
战场从价值判断迁移到了事实问题,因此可发现性成了核心风险面。 「训练是否具有转换性」公司无法用工程手段改变;「语料从哪来、预处理删了什么字段、下载时上行跑了多少」全部有答案,全部可被强制披露。一亿条输出日志的取证令说明了取证规模,也说明了保留策略就是暴露面的控制变量。
CMI 那条不是绕开合理使用的后门,是成立之后的乘数。 Kadrey 已经演示了合理使用成立时它如何落空。真正要防的是第一级——「授权用途不同」这类贴着合同走的理论,它不需要推翻任何既有判例;一旦被凿开,赔偿口径从每部作品换成每次违规,暴露面放大一个量级。
最后是那个反身性的问题。训练数据的法律成本一直都在,只是被推到了未来——而现在它开始到期。更麻烦的是到期的节奏:它不由权利人推动,由行业自己签下的许可协议推动。
所以问题是:当「训练数据许可市场确实存在」成为一个法庭上无法否认的事实之后,那些当年靠「这个市场不存在」赢下合理使用的公司,还剩下哪条抗辩?