智能体沙箱的瓶颈:厂商说 CPU,实测说内存与隔离
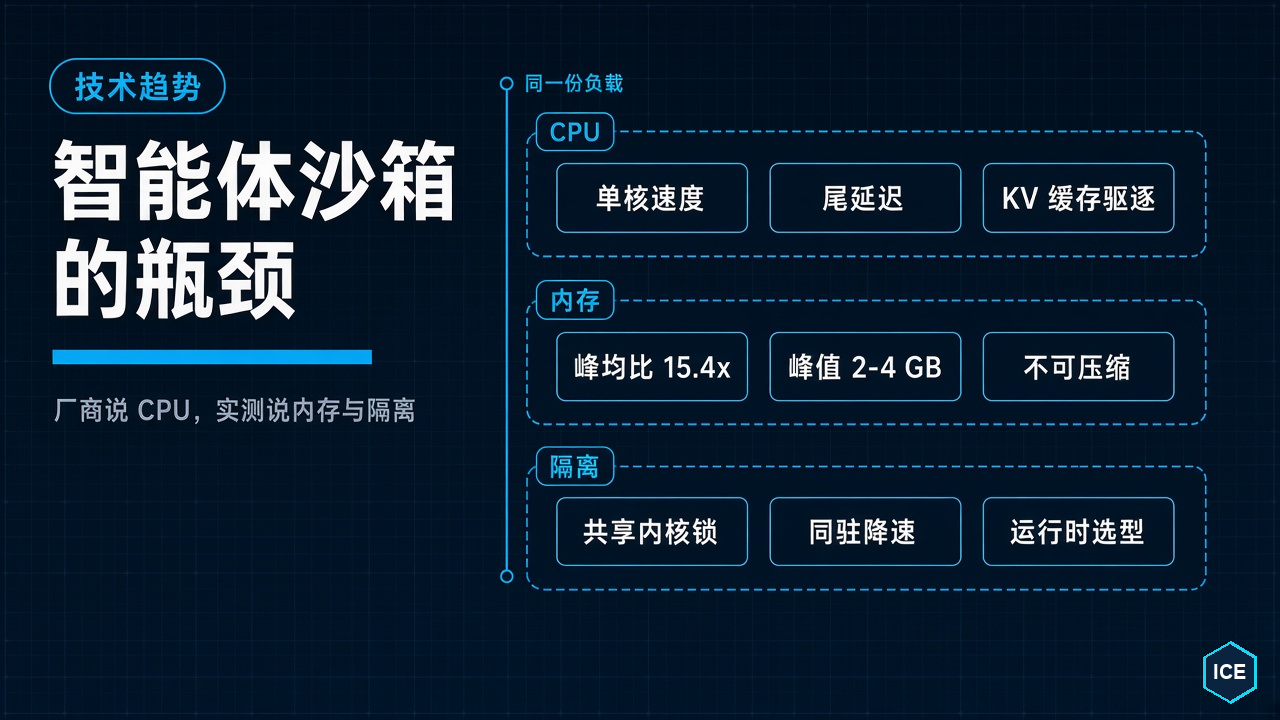
CoreWeave 本周把 NVIDIA Vera Rubin NVL72 推进生产环境,同时公布了一组关于智能体的数字:单机架 128 颗 CPU、11,264 个核心,足以承载一万一千多个并发沙箱;在 Vera CPU 上,沙箱启动速度提高 3 倍以上,Terminal-Bench 中通过任务的平均速度提高 1.7 倍。NVIDIA 的说法更直接——Vera 是第一颗为 AI 智能体设计的 CPU。
只看这些,结论似乎很清楚:智能体时代的瓶颈正从 GPU 移向 CPU,解法是更快、更多的核心。
但两篇基于真实智能体负载的论文给出了另外两组答案。一篇测出,限制并发密度的是内存,智能体的平均 CPU 占用只有单核的 7.6%–13.2%;另一篇发现,同样的任务只需更换隔离运行时,同驻降速就能从 64% 降到 12%。
三组结果并不互相推翻。它们分别在问:
- 一条智能体任务的关键路径怎样更短;
- 一台机器的并发密度怎样更高;
- 多个任务同驻时的相互干扰怎样更小。
“瓶颈”不是某个部件自带的属性。先说清在优化什么,才知道该把钱和工程精力花在哪里。
厂商那套论证,其实站得住
先把 NVIDIA 的论证完整讲一遍。它经常被简化成“CPU 也很重要”这种口号,反而把真正有用的信息丢掉了。
NVIDIA 的出发点不是一台机器能塞下多少智能体,而是 GPU 有没有持续做有效计算。一次智能体会话包含多个模型推理步骤,步骤之间夹着工具调用、代码执行、检索、数据库查询和沙箱评估,这些工作主要由 CPU 侧协调和执行。CPU 侧一慢,GPU 机群会在三个地方受损。
第一是强化学习。RL 的 rollout 阶段要靠 CPU 生成经验数据,其中包含大量顺序、分支密集的逻辑处理。CPU 每秒完成的环境步数不够,同一个训练窗口内能返回的有效评估就会减少。NVIDIA 给出的对比是:基线 CPU 只能完成 45% 的评估,换上单线程性能高 1.8 倍的 Olympus 核心后,这一比例提高到 85%。
第二是尾延迟。对外服务时,平均速度快还不够;当一个 socket 上挤满并发沙箱、工具和数据服务,延迟仍要可预测。Vera 用 88 核单片 die 和统一缓存,减少多 chiplet 设计中跨 chiplet、跨 sub-NUMA 访问带来的抖动。NVIDIA 给出的数据是,峰值负载延迟比其 x86 基线低 40%。
第三条最容易被忽略:KV 缓存驱逐。在满负荷的数据中心里,GPU 不会等待一次工具调用返回,而会继续接收新请求、装入新上下文。等工具调用结束,原会话的 KV 缓存可能已经被挤出显存,GPU 只好重新处理此前的输入。CPU 侧的间隔越长,发生昂贵重算的概率就越高。
这条链是成立的,也解释了为什么内存带宽被反复强调——Vera 用 LPDDR5x 提供最高 1.2 TB/s 总带宽、每核心 14 GB/s,宣称是传统数据中心 CPU 每核带宽的 3 倍以上,功耗不到一半。
请记住这套论证的优化目标:让昂贵的 GPU 机群尽可能少空转。 下面的分歧全都从这里长出来。
实测:你的机器会先被内存塞满
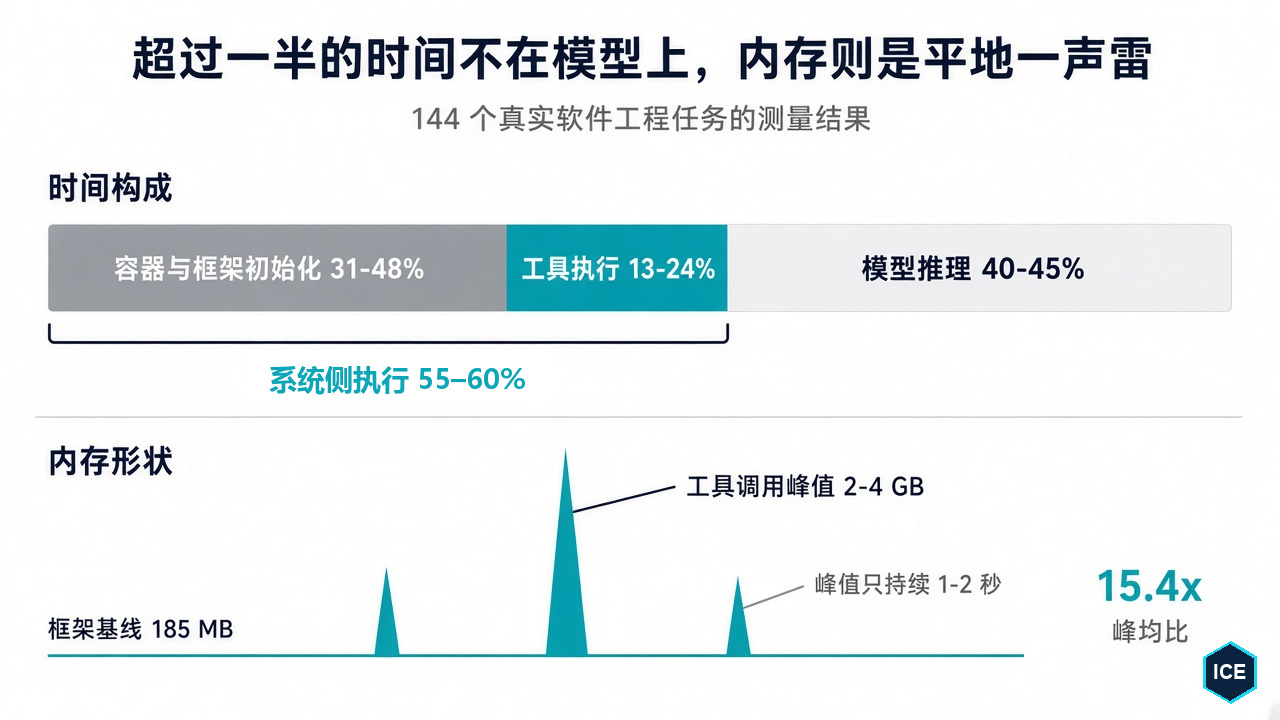
第二组数字来自 AgentCgroup,一项由加州大学圣克鲁兹分校等机构合作完成的研究。研究者用 Claude Code 跑了 SWE-rebench 的 144 个软件工程任务,分别接入云端 Haiku 4.5(33 个任务)和本地 GPU 上的 GLM-4.7-Flash(111 个任务),每秒采样 CPU 与内存,并记录每次工具调用的类型和时间戳。
第一个发现就和直觉相反。智能体的平均 CPU 占用极低:Haiku 13.2%,GLM 7.6%,这里 100% 指一个核心被完全跑满。在一台 24 核机器上,这离饱和差得很远。
真正先触顶的是内存。单个智能体实例的峰值内存可达 2–4 GB,所以一台 128 GB 的机器按峰值分配只能装 32–64 个实例,而在这个并发度上,CPU 利用率还不到总容量的 36%。换句话说,你会先因为内存不够而装不下更多智能体,那时 CPU 还闲着三分之二。
更关键的是内存的形状。论文测出一个清晰的两层结构:智能体框架本身(Claude Code 的 Node.js 运行时)维持约 185 MB 的稳定基线,Haiku 平均 183 MB、GLM 平均 188 MB;真正的波动几乎全部来自工具调用拉起的子进程。跑测试、装依赖会把内存推到 500 MB 至 2 GB,然后迅速掉回基线。
“顶上去再掉回来”的幅度大得离谱。最极端的一个科学计算类任务,峰值内存 4060 MB,平均内存只有 264 MB,峰均比 15.4 倍。作为对照,论文里列的 serverless 负载峰均比约 1.5 倍,微服务 2–3 倍,批处理约 1 倍。智能体是另一个量级。
这些尖峰还只持续 1–2 秒,内存变化率最高到 3 GB/s,单个 1 秒采样区间内内存变动可达 2.9 GB。在 Haiku 数据集里,工具调用只占采样时间的 28.5%,却包含了 98.5% 的内存尖峰。
还有一项常被低估的成本:初始化。智能体容器镜像平均 3.5 GB,范围 2.9 到 17.3 GB,是典型微服务镜像的 7 倍、serverless 函数的 70 倍。容器加框架的初始化占整个任务时长的 31%–48%。把初始化和工具执行加在一起,论文所称的“操作系统侧执行”占用户感知完成时间的 55%–60%,模型推理只占 40%–45%。这里并非全是无效开销——工具执行本身在完成任务——但它说明优化模型推理覆盖不了大部分实际耗时。
在一个“AI 智能体”任务里,超过一半的实际时间没有花在模型推理上。
先问清楚:优化延迟,还是优化密度
到这里,两组结论看起来直接打架:一边说 CPU 在关键路径上,一边说 CPU 根本用不满。
把各自的分母摆出来,矛盾就消失了。
NVIDIA 和 CoreWeave 算的是 GPU 机群的账。那个场景里机器上插着极贵的加速卡,任何让 GPU 空转或重算的行为都是直接损失。CPU 单核速度之所以进入关键路径,是因为它决定了 GPU 两次计算之间的间隙有多长——间隙越长,KV 缓存越可能被驱逐,重算成本越高。这是一笔关于延迟的账。
AgentCgroup 算的是 单机多租户密度的账。这个场景要在一台共享机器上承载尽可能多的并发智能体,关心的是“还能不能再装一个”。这是一笔关于容量的账。CPU 紧张通常先表现为排队和延迟增加;内存跨过硬边界,则会触发 OOM,直接终止任务。
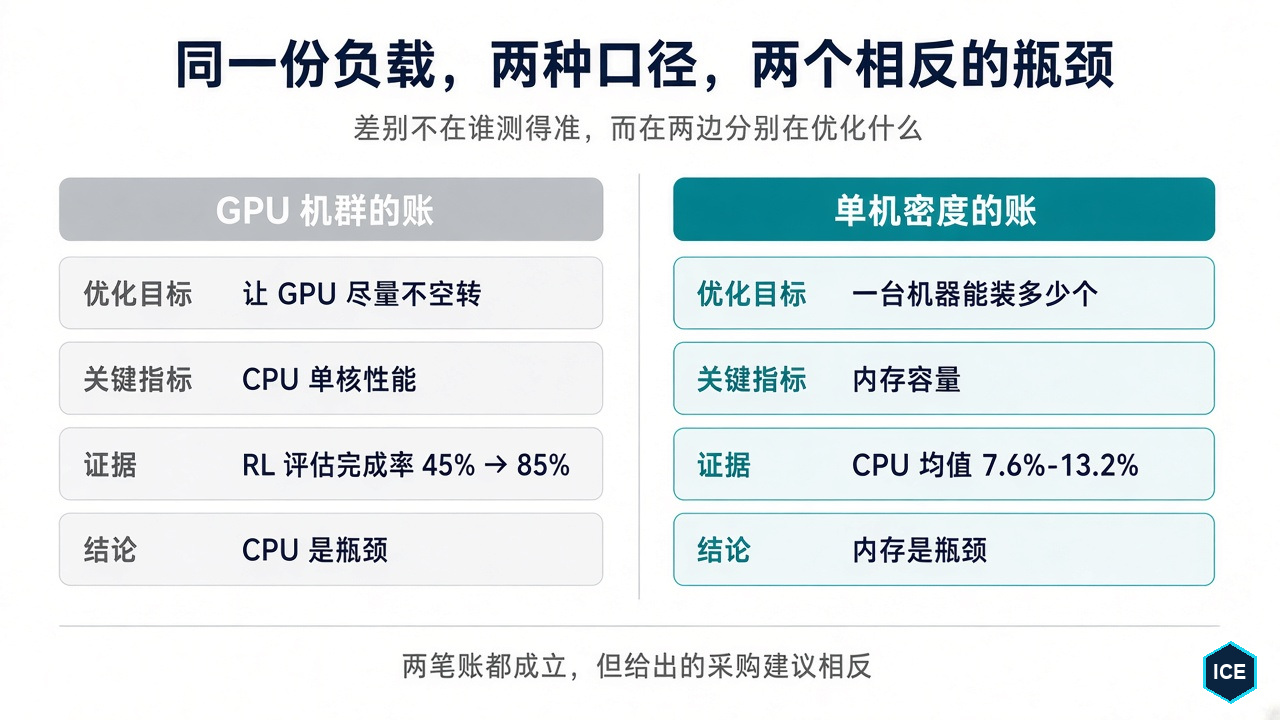
两笔账都成立,但给出的采购和容量规划建议完全不同。如果你在建 AI factory、自己训练模型、跑大规模 RL,NVIDIA 那条链对你有效。如果你在给团队或客户托管大量编码智能体,那么决定并发上限的首先是内存容量;只升级核心速度,不会直接提高可承载的实例数。
这个区分之所以要紧,是因为“智能体时代 CPU 是新瓶颈”正在被当成一条通用结论传播。它有适用边界。
这和之前那篇读 AMD 产品路线图的文章是同一个问题的两面:那时看的是厂商怎么把 agentic 负载写进芯片规格,现在有了实测,可以回头检验那些规格对应的到底是谁的瓶颈。
第三种瓶颈:同驻任务之间的干扰
前两组研究分别回答延迟和密度问题。第三份材料换了一个问题:当多个智能体挤在同一台机器上,它们会把彼此拖慢多少?
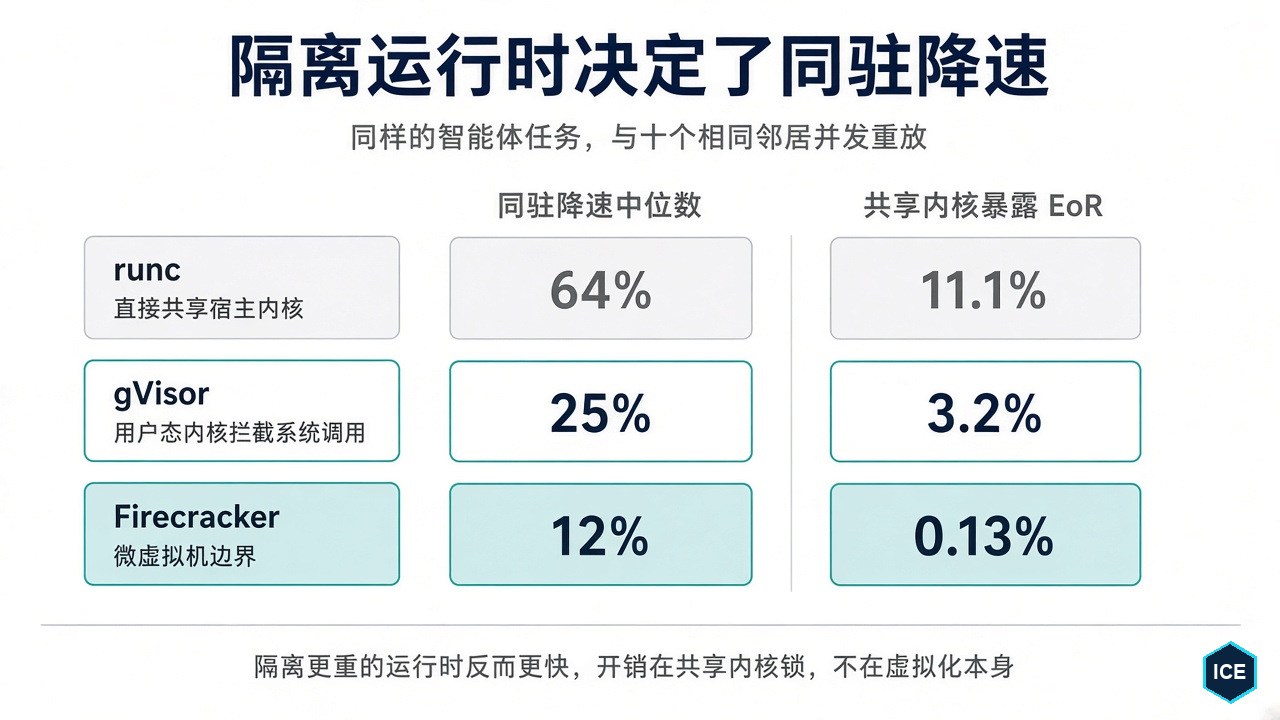
威斯康星大学麦迪逊分校的研究者复用了 AgentCgroup 采集的 Haiku 工具调用轨迹,把同样的任务在三种隔离运行时上重放:原生 Linux 容器 runc、使用用户态内核的 gVisor(runsc-kvm),以及 Firecracker 微虚拟机。
每个任务先单独运行,再和 10 个相同负载的邻居并发运行,两次执行时间的比值就是同驻降速。研究排除了沙箱创建和启动成本,因此测到的是运行期相互干扰,不是三种方案的完整端到端成本。
结果反直觉:runc 的同驻降速中位数约 64%,gVisor 约 25%,Firecracker 约 12%。 在这组运行期实验中,隔离最“轻”的容器反而受干扰最严重,runc 的中位降速是 Firecracker 的五倍多。但这并不等于 Firecracker 在包含启动成本的所有场景中都更快。
论文重点解释的是共享内核锁这一条干扰通道。runc 直接共享宿主内核,十个并发任务的系统调用会竞争同一批内核锁;gVisor 用用户态内核拦下大部分系统调用;Firecracker 则把负载放进微虚拟机。为量化这种暴露,论文提出 EoR(Expectation of Risk,风险期望):用单独运行时的系统调用画像,乘以每个系统调用触及的共享锁平均持有时间,估算任务暴露在共享内核状态里的程度。三个平台的 EoR 中位数分别为 runc 11.1%、gVisor 3.2%、Firecracker 0.13%——runc 比 Firecracker 高约 85 倍,排序与实测降速一致。EoR 不是全部干扰的解释,作者也明确保留了硬件等其他共享通道。
更实用的发现是,隔离收益和工具类型强相关。在文件与 I/O 密集的工具上(文件浏览、读取),gVisor 的 EoR 比 runc 低 5 到 10 倍;但在测试执行和 Python 运行这类工具上,gVisor 和 runc 差不多,说明它在这些路径上并没有少碰宿主内核。甚至有反向案例:包安装在 gVisor 下反而更慢,因为这个动作混合了大量文件系统、进程和包缓存操作,全部要过用户态内核,放大了运行时自身的开销。
在 runc 下降速最严重的也不是计算密集的工具,而是面向文件系统的那一批:Git 操作、文件浏览、写入、grep、编辑、Bash。这和“智能体是计算负载”的印象正好相反。
边界也要说清楚:邻居是同构的(十个相同任务),系统调用到内核锁的映射是近似值,工具类别只有 14 个,平台内部的统计效力有限。论文能稳健支持的是这组实验里的跨平台排序,不能直接推出任意负载都该换成微虚拟机。
为什么现有的资源控制接不住
到这里,问题已经不只是选 CPU、加内存或换运行时。智能体负载还有一组共同特征:1 到 2 秒的尖峰、15.4 倍峰均比、难以预测的执行路径,以及终止后无法恢复的进程内状态。现有资源控制大多不是按这些特征设计的。
AgentCgroup 把它归纳成三个失配。
粒度失配。 资源需求在工具调用这一级变化,而所有现成的控制手段只能在容器这一级设一个策略。cgroup v2 的硬限制(memory.max)逼你二选一:按峰值设,九成以上的内存被浪费,因为峰值出现的时间不到 2%;按均值设,工具爆发时就 OOM。软限制(memory.high)也不行,内存回收分不清框架基线和工具子进程,会给智能体运行时自己制造 GC 压力;而且单一阈值没法区分 git status(平均 13.5 MB)和 pytest(P95 518 MB)。
响应失配。 尖峰只持续 1–2 秒,而 PSI 驱动的方案(systemd-oomd 这类)需要经历压力信号产生、用户态守护进程接收、决策,再写回 cgroup 控制文件。等控制动作生效,尖峰可能已经过去,也可能已经触发内核干预。Kubernetes VPA 更慢:它依赖重启 Pod,或以远慢于秒级爆发的周期调整资源,无法在一次工具调用内部完成响应。
适应性失配。 传统云负载基本是确定性的,可以用历史数据预测;智能体不行。同一个任务跑三遍,执行时间分别是 402、222、259 秒,相差 1.8 倍,而且三次给出的是完全不同的解法,改的文件、改法、策略都不一样。跨任务的峰值内存更是从 197 MB 到 4 GB,相差 20 倍。连看起来像代理指标的东西都不管用:对话轮数和执行时间中度相关(r 在 0.57 到 0.82 之间),但和峰值内存几乎不相关(r 小于 0.11)。
还有一个加重后果的因素:对智能体来说,杀掉重来的代价远高于传统负载。 多 GB 镜像的冷启动要占掉任务总时长的 31%–48%;OOM 会销毁几分钟积累的进程内上下文,而这份上下文不像微服务的外部状态那样可以 checkpoint 或迁移;重跑还不保证收敛到原来的解。三重惩罚叠加,意味着任何把“终止”当兜底的策略都很贵。
重试还会放大这个问题。在 Haiku 数据集中,85%(28/33)的任务包含重试组;GLM 数据集则是 97%(108/111)。这里的“重试组”指连续三次以上执行同一条测试命令。GLM 平均每个任务出现 3.9 组,最多连续重试 56 次;每轮重试都可能留下未释放的内存,最坏情况累计 502 MB。
AgentCgroup 给出的方向,是让控制粒度跟着工具调用走。它用层级 cgroup 为每次工具调用建立资源域,用 eBPF 的 sched_ext 管 CPU、memcg_bpf_ops 管内存,并以节流和冻结替代直接杀进程。它还设计了一条双向通道:智能体在调用工具前声明预期资源需求;系统在节流或 OOM 时把反馈写入 stderr,让智能体改用更省资源的执行策略。
目前这仍是概念验证。轨迹重放实验中,紧内存场景下的基线会 OOM 掉一个低优先级进程,存活率为 66%;加入 BPF 后三个进程全部完成,高优先级任务的 P95 内存分配延迟从 70.97 毫秒降到 50.14 毫秒,下降 29%。结果值得继续跟踪,但还不能视为生产规模的证明。
小结
第一,“瓶颈”这个词必须带上优化目标才有意义。 你在建 AI factory、关心 GPU 不要空转,CPU 单核性能确实在关键路径上;你在一台机器上托管多个智能体、关心能装多少个,先触顶的就是内存,而 CPU 还闲着一大半。拿前一种结论去做后一种采购,会买错东西。
第二,容量规划不能只看平均内存。 15.4 倍的峰均比意味着必须同时考虑基线、突发和可接受的超配比例。按均值硬配额会在工具爆发时 OOM,完全按峰值预留又会浪费大量容量。同时别漏掉容器初始化,它占任务时长的三到五成。
第三,先测同驻干扰,再决定是否升级硬件。 在这组实验里,同样的负载从 runc 换到 Firecracker,同驻降速从 64% 降到 12%。它说明“隔离越重一定越慢”并不成立,但选型时仍要把启动成本、内存开销和工具类型一起算进去。
第四,别把终止当作资源超限的兜底。 智能体的进程内上下文无法 checkpoint,杀掉就是几分钟的工作白做,重跑还不一定走回同一条路。节流和冻结是更合适的降级路径,哪怕实现起来更麻烦。
这三份材料里最该被记住的,其实不是任何一个具体数字,而是一个方法上的提醒:当厂商和论文给出相反结论时,先别急着站队,去看两边各自在优化什么。
本文部分内容由 AI 辅助生成,经人工审校和补充后发布。
参考资料
- NVIDIA. “NVIDIA Vera CPU Boosts AI Factory Throughput to Accelerate Agentic Workloads.” 2026-07-07. https://developer.nvidia.com/blog/nvidia-vera-cpu-boosts-ai-factory-throughput-to-accelerate-agentic-workloads/
- “From Training to Production, NVIDIA and CoreWeave Close the Loop on Agentic AI.” 2026-10-04. https://futuretechmarkets.com/markets/from-training-to-production-nvidia-and-coreweave-close-the-loop-on-agentic-ai-4/
- Yusheng Zheng, Jiakun Fan, Quanzhi Fu, Yiwei Yang, Wei Zhang, Andi Quinn. “AgentCgroup: Understanding and Controlling OS Resources of AI Agents.” arXiv:2602.09345, 2026. https://arxiv.org/abs/2602.09345
- eunomia-bpf. “AgentCgroup” (开源实现). https://github.com/eunomia-bpf/agentcgroup
- Anjali, Michael M. Swift. “Isolation in the Age of Agents.” University of Wisconsin–Madison, 2026. https://os-for-agent.github.io/papers/AgenticOS_SOSP_2026_paper_2.pdf
- Ibragim Badertdinov et al. “SWE-rebench: An Automated Pipeline for Task Collection and Decontaminated Evaluation of Software Engineering Agents.” arXiv:2505.20411, 2025. https://arxiv.org/abs/2505.20411
- Tejun Heo, David Vernet, Josh Don. “Extensible Scheduler Class (sched_ext).” Linux Kernel Documentation. https://docs.kernel.org/scheduler/sched-ext.html
- Huan Zhu. “mm: memcontrol: add BPF hooks for memory controller.” LWN.net, 2026-01-23. https://lwn.net/Articles/1055698/
- Tejun Heo. “Control Group v2.” Linux Kernel Documentation. https://docs.kernel.org/admin-guide/cgroup-v2.html
- Johannes Weiner. “PSI — Pressure Stall Information.” Linux Kernel Documentation. https://docs.kernel.org/accounting/psi.html
- Alexandru Agache et al. “Firecracker: Lightweight Virtualization for Serverless Applications.” USENIX NSDI, 2020. https://www.usenix.org/conference/nsdi20/presentation/agache
- gVisor. “Platform Guide.” https://gvisor.dev/docs/architecture_guide/platforms/