生成过剩的时代,核验才是稀缺能力
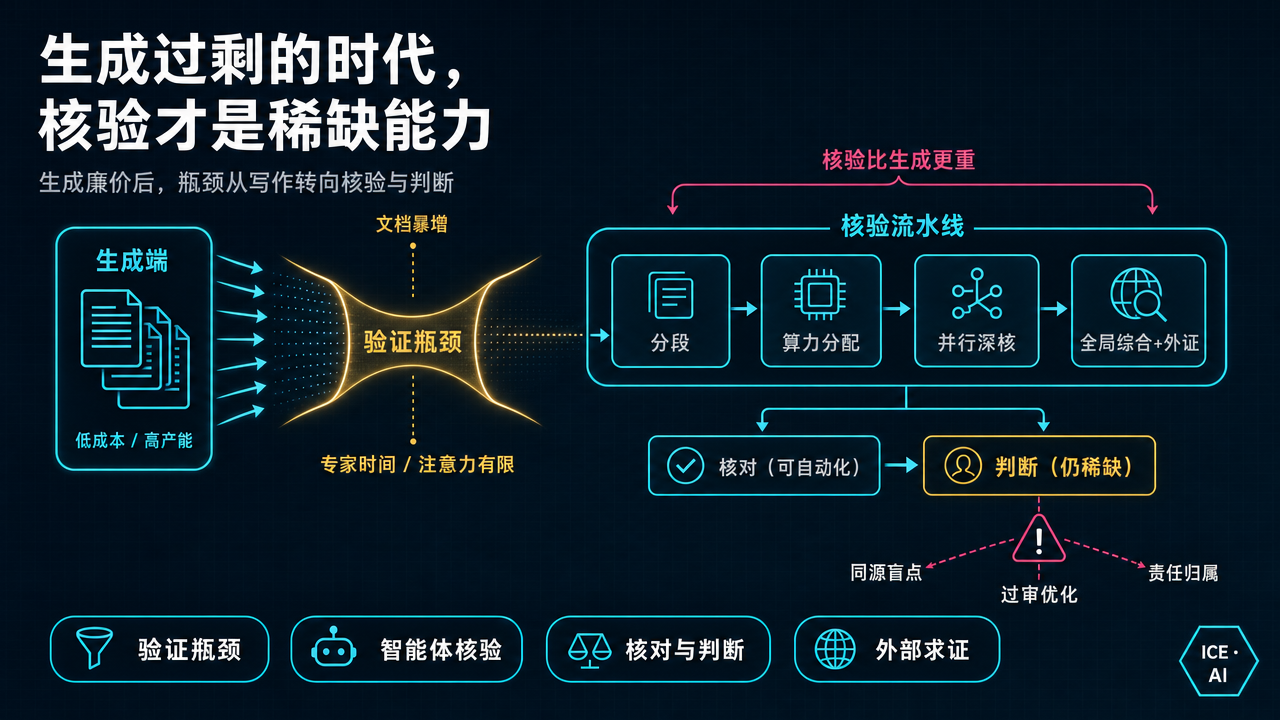
ICLR、NeurIPS 和 ICML 三大人工智能会议,2023 年合计收到约 2.3 万篇投稿。到 2026 年,这个数字超过了 7.4 万。
三年翻了三倍多。合格审稿人的数量,显然没有同步翻三倍。
10 月 14 日,谷歌公开发布了 Deep Review,一个用于审查复杂文档的智能体系统。谷歌在发布文章里给这个问题起了一个名字:验证瓶颈(validation bottleneck)。内容的生成速度,已经快过人类严格审查它的速度。
论文只是最显眼的例子。方案、报告、商业计划、合同和设计文档都在经历同样的变化:AI 可以迅速产出结构完整、语言流畅的初稿,但判断事实是否准确、推论是否成立、取舍是否合理,仍然需要懂行的人逐层审查。
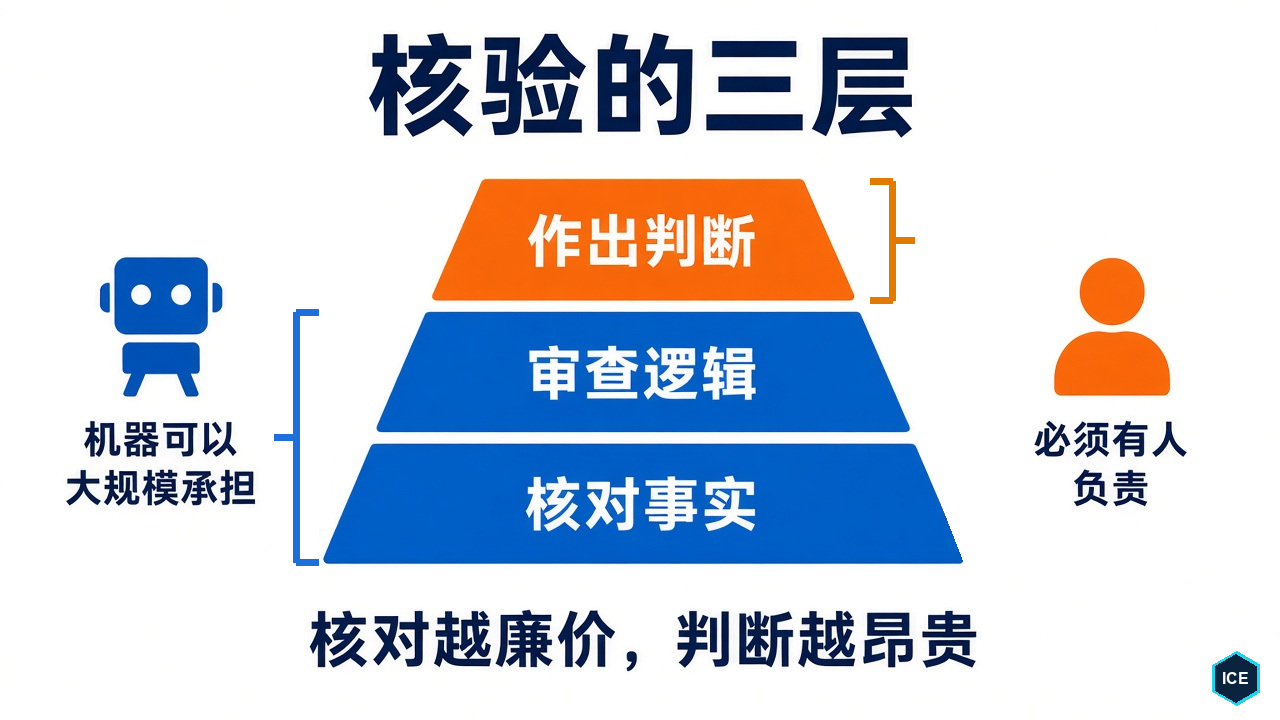
这里所说的“核验”,并不只是查错别字或核对一个数字。它至少包含三层:核对事实、审查逻辑、作出判断。 当生成变得廉价,稀缺的不再是写得快,而是知道哪句话站不住,以及为什么站不住。
瓶颈换了位置
过去,知识工作的主要瓶颈在“写”。一份方案要查资料、理思路、组织语言、反复修改,能够写出来,本身就筛掉了大量未经思考的内容。
AI 首先改造的正是这一端。现在,产出一份结构完整、措辞得体、看起来数据齐全的文档,成本大幅下降。问题在于,“看起来像样”和“经得起推敲”之间的距离,并没有因此缩短;流畅有时反而会遮住错误。
于是,瓶颈从内容生产转向了内容验证:
生成端的产能被放大了几倍、几十倍,核验端却仍然受限于专家的时间、知识和注意力。文档越容易生成,进入审阅队列的内容就越多;写作者节省下来的时间,可能只是转移成了审阅者的负担。
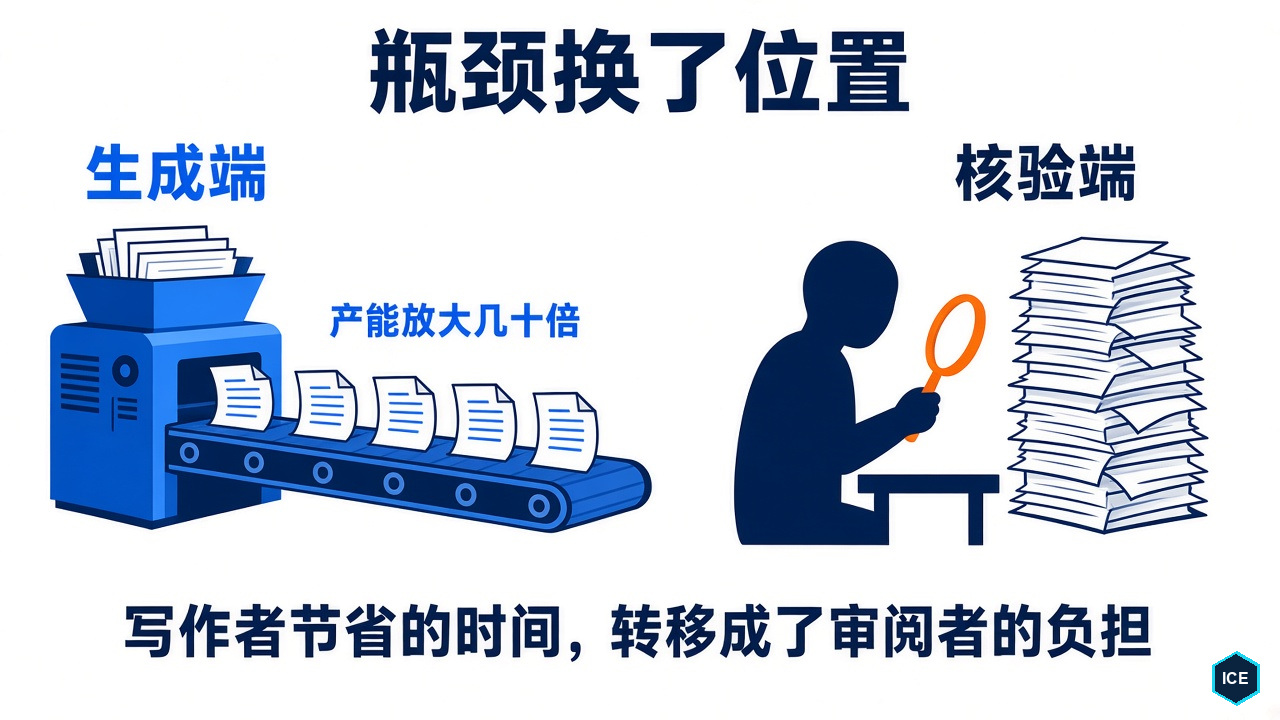
这种失衡并不陌生。人们常用“布兰多里尼定律”来形容它:驳斥一个错误所需的精力,远高于制造这个错误。过去,这句话常被用来形容网络谣言;现在,它正在进入论文评审、方案评审和每一间会议室。
核验,为什么比生成更重
直觉上,AI 既然能写,也应该能审。于是最简单的做法似乎是把全文交给模型,再问一句:“请找出问题。”
谷歌在介绍 Deep Review 时,专门解释了这种做法为什么不够。面对长而复杂的文档,单次模型调用可能耗尽推理预算,漏掉跨章节的依赖关系,也可能顺着作者的叙述一路读下去,接受那些听起来合理、实际没有被证明的论断。
它的解决办法,是一条四阶段的智能体流水线:
- 分段:先把文档拆成逻辑段落,比如引言、方法、实验;
- 按需分配算力:信息密度高的部分,比如数学证明,分配更多推理预算;
- 并行深度核验:多个推理智能体各自负责一段,但都能看到全文,以追踪前后引用;
- 全局综合与外部求证:汇总各段结论,检查章节之间是否一致,再调用外部工具核对事实,作为防止幻觉的最后一道关。
这条流水线本身就说明了问题:核验不是把生成过程倒放一遍,而是一项更重的工程。 生成可以顺着一条思路一路写下去;核验却要拆解论证、交叉比对、回头复查,还要把文中的说法放到外部证据里重新检验。
这个结论对人同样成立。写一页看似合理的分析很快,确认其中每个数字的来源、每个推论的前提、每个结论与前文是否矛盾,要慢得多。
机器能接手“核对”,接不走“判断”
Deep Review 的试点规模不小。过去一年,它以“论文助手”的名义,与 STOC、ICML、NeurIPS 和 ICLR 四个会议合作,为 1.6 万多篇自愿参与的稿件提供了投稿前反馈。需要说明的是,这些反馈与会议的正式同行评审相互独立;它帮助作者预先发现问题,并不代替审稿人决定论文是否录用。
但谷歌对它的定位很克制。按发布文章的说法,它负责检查逻辑一致性和数学陈述、提出改进建议、为事实找依据、与已有工作做比较,更高层面的判断留给人类。
这句话值得展开。文章开头所说的三层核验,可以归为两类工作:
- 可以被证明或证伪的核对:这个推导有没有错?数字与表格是否一致?引用是否存在?前文的假设到了后文有没有悄悄改变?事实核对与大部分逻辑审查有相对明确的标准,机器有机会大规模承担。
- 必须有人承担后果的判断:这个问题值不值得研究?方案的取舍是否合理?商业计划押注的方向对不对?这类问题没有唯一答案,依赖经验、语境和责任。
AI 核验工具真正改变的,是把人从大量重复核对中解放出来。它并不会让判断变得不重要。恰恰相反:当事实核对和一部分逻辑审查变得廉价,判断会成为核验中最昂贵、也最需要人负责的部分。
当核验也被自动化
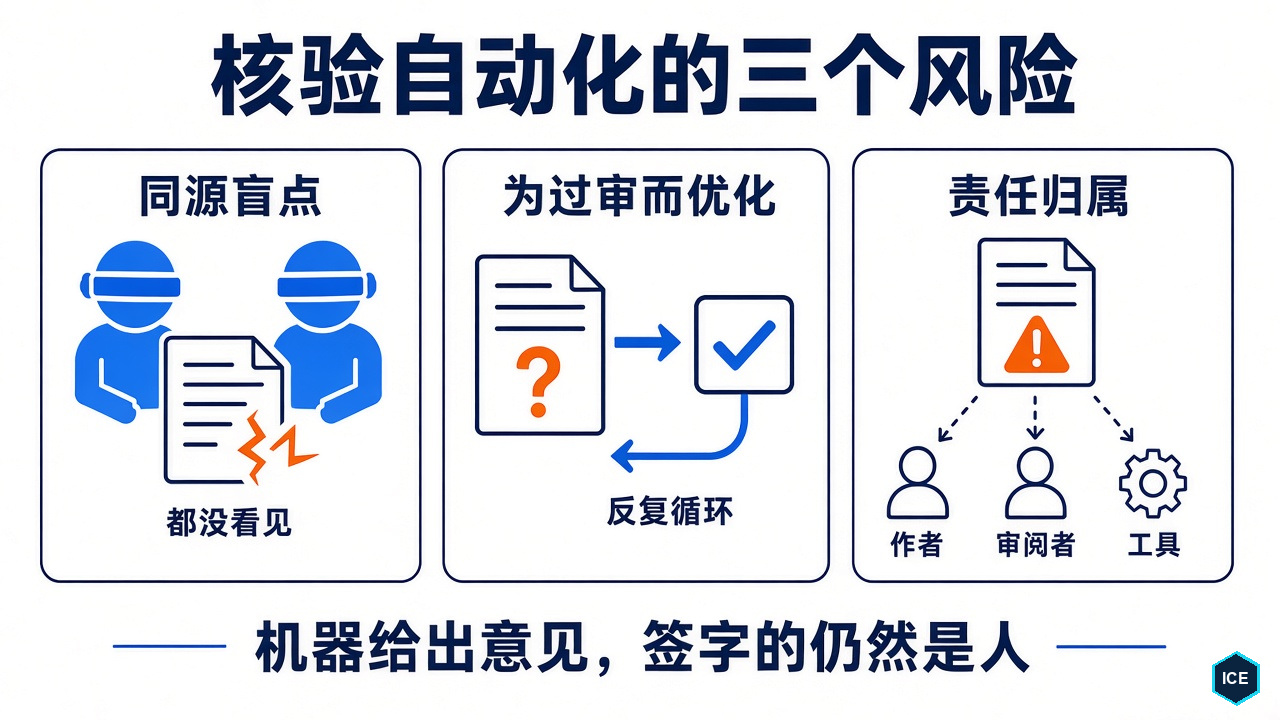
但把核对交给机器,并不意味着验证瓶颈从此消失。它只是把瓶颈继续向后移动,并带来三个新风险。
第一,同源盲点。 如果写文档和审文档的是同一类模型,它们可能共享知识缺口和推理偏差。一个模型深信不疑的错误,另一个模型未必能看出来。Deep Review 引入外部工具求证,正是为了打破这种自我循环;但这道防线能挡住多少,还取决于检索是否充分、证据是否可靠。
第二,为过审而优化。 谷歌给每位用户每周两次免费核验,还开放接口供高频工作流使用。这当然降低了核验门槛,但也意味着作者可以反复修改,直到系统不再报错。所谓古德哈特定律提醒我们:一个指标一旦变成目标,就可能失去原来的意义。“AI 挑不出毛病”与“真的没有问题”之间,始终有距离。
第三,责任归属。 一份文档经过 AI 核验后仍然出了问题,应该由谁负责?是作者没有把关,审阅者过度依赖工具,还是工具漏检?核验越自动化,越要提前说清楚:机器可以给出证据和意见,但最终采纳什么、签字确认什么,责任仍然属于人。
对个人和组织意味着什么
对个人来说,能力的衡量方式在变。 写得快已经不再稀缺,更值钱的是两种能力:一是写出经得起核验的东西,让数字有来源、推论有前提、假设被明确说出;二是发现内容里站不住的地方,尤其是那些语言流畅、逻辑却悄悄跳步的段落。
对组织来说,要重新分配核验预算。 很多团队用 AI 提升了写作效率,却没有同步改造审阅流程,结果是文档越来越多,错误更容易藏在流畅的表达里。更合理的做法,是像软件工程里的代码检查一样,把核验前置并嵌入工作流:先让机器筛出明显矛盾和硬伤,再把专家的时间留给真正需要判断的问题。
对评价体系来说,要奖励“被挑出错并改正”,而不是产出数量。 如果考核仍然看交付了多少份文档、写了多少页,AI 只会放大数量,而不会提升质量。真正值得鼓励的,是主动接受核验、暴露问题、修正错误的过程。
结语
AI 让每个人都拥有了一支写得很快的笔,却没有自动配上一双看得很准的眼睛。
核验智能体可以成为这双眼睛的一部分:替我们核对事实、追踪前后矛盾、寻找外部证据。但它不能替人决定什么值得相信,更不能替人承担判断错误的后果。
接下来几年,最有价值的知识工作者,也许不是产出最多的人,而是那些能在一份流畅、完整、看起来无懈可击的文档里,准确指出“这里不对”,并说清楚为什么不对的人。
你最近读到的方案和报告里,有多少你真正逐句核验过?
参考资料
- Google Research,《Analyzing technical documents with Deep Review》,2026-10-14 — https://research.google/blog/analyzing-technical-documents-with-deep-review/
本文部分内容由 AI 辅助生成,经人工审校和补充后发布。