论文解读|OmniTable:把 PB 级语料准备从流水线编排变成声明式资产
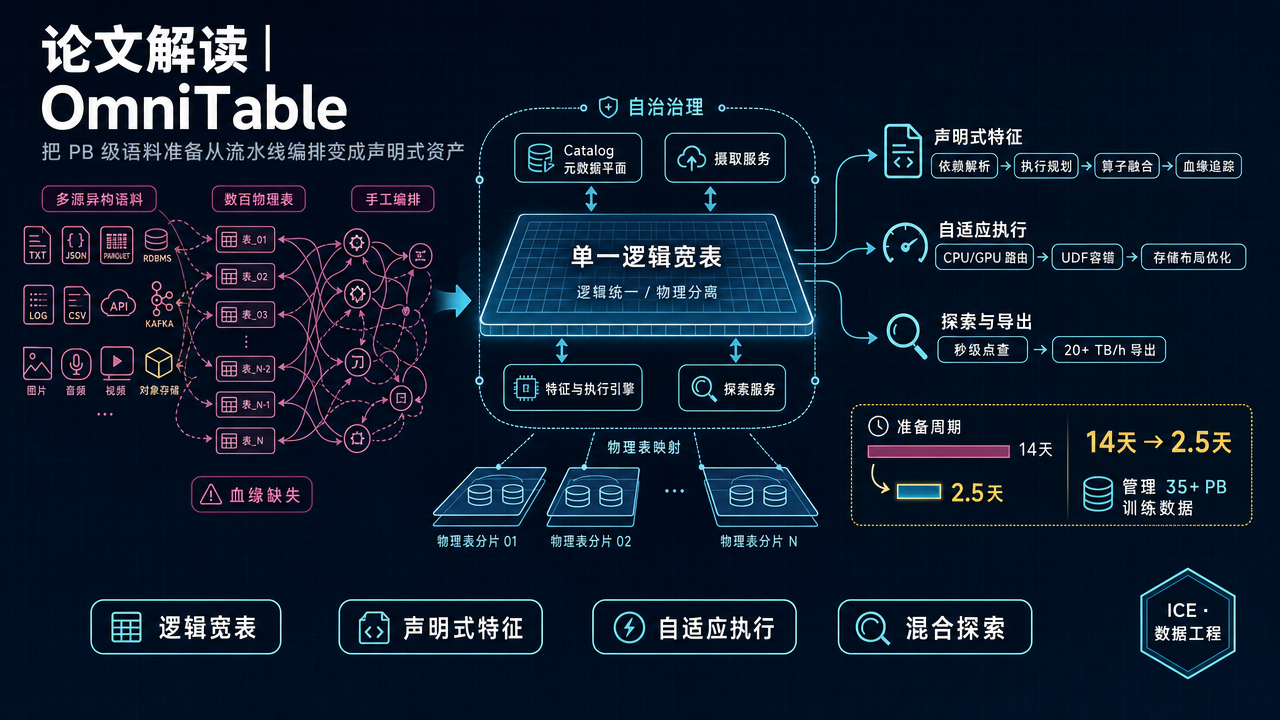
模型越来越会吃数据,真正卡住训练节奏的却常常不是“语料不够”,而是人编排不完流水线。
蚂蚁集团的 OmniTable 正面处理了这个问题。它把 Web、代码、PDF、SFT(监督微调,即用标注好的指令数据继续训练模型)等数据组织成逻辑宽表:工程师只声明要增加什么特征,系统负责解析依赖、选择 CPU 或 GPU、回填结果并记录血缘。生产环境中,它管理着超过 35 PB、3050 亿条以上记录;在一项真实 SFT 数据准备任务中,需要人工参与的周期从约 14 天缩短到 2.5 天(5.6×)。
论文信息
- 标题:OmniTable: A Unified Wide-Table System for Petabyte-Scale LLM Data Curation and Exploration
- 作者:傅禹卓、王相春、黄超等(通讯作者周俊)/蚂蚁集团
- 时间:arXiv 2026-09-10;PVLDB 19(12): 4276–4289, 2026
- 奖项:VLDB 2026 工业赛道最佳论文
- 链接:arXiv:2609.11148|DOI:10.14778/3827998.3828032
多数语料工程的工作讲的是某一步怎么洗得更干净。这篇讲的是另一件事:当清洗算子已经够用,为什么准备一批训练数据还是要花两周。
读它只需抓住一条主线:让 LLM 数据平台的一等公民从“表和任务”变成“样本和特征”。
一、问题:为什么会走进流水线迷宫
工业级语料准备通常是一条漏斗:解析、清洗、去重、打分、分词、组样本。但来源是网页抓取、内部日志、外购语料、PDF 和代码仓库,格式与引擎都不统一——CPU 上跑 Spark / MaxCompute SQL,GPU 上跑困惑度和质量模型,每轮实验再落一批一次性结果表。
作者称这种状态为 pipeline maze(流水线迷宫),并给了一个很具体的例子:为了增加一个特征,工程师要“在任务画布上拖入 106 张表”。问题不在特征多复杂,而在于特征只有一个,编排单位却是 106 张物理表。
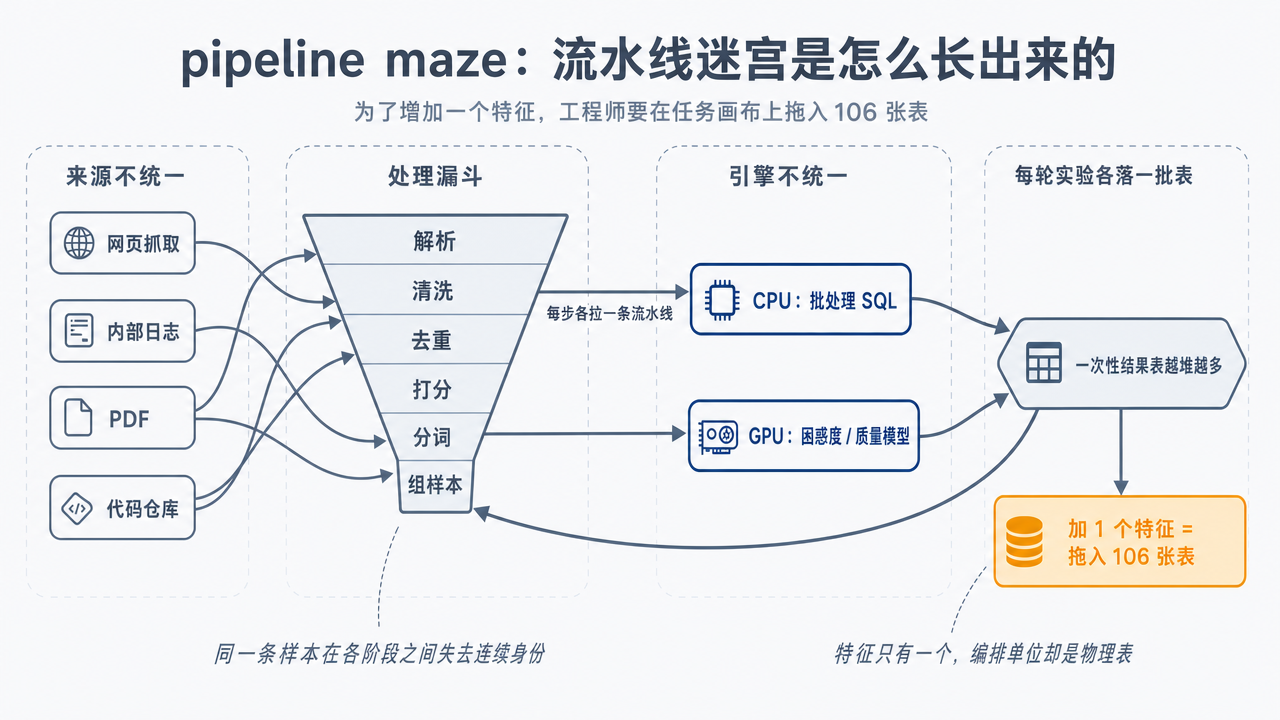
来源、阶段、引擎、实验轮次这四件事各自乘一遍,物理表数量就失控了。由此收敛出四条设计约束:
第一,同一条样本要能被看成一个整体。 缺少统一抽象时,每个来源、每个引擎都要单拉一条流水线,样本在原始、清洗、可训练阶段之间失去连续身份。
第二,物理规模不能拖垮交互。 系统既要承受持续写入和上千逻辑列,又要提供秒级点查和每小时至少 20 TB 的过滤导出;小文件、分区膨胀和超宽 schema 会同时伤害这两类负载。
第三,改一个特征不能重接一遍管线。 研究人员几乎每天都要更换过滤策略和特征集合做消融实验。旧工作流以“表 + 任务”为迭代单元,成本随受影响的数据集数量线性甚至超线性增长。
第四,任何结果都必须能追溯。 特征逻辑散落在不同代码库、缺少统一版本,数据血缘(lineage,即某列由哪些输入、哪版逻辑算出)随之断裂,训练完成后很难回答“这批数据用了哪一版清洗规则和质量分”。
Iceberg、Delta 这类湖仓格式提供了 ACID 和 schema 演进,但作者的判断很直接:它们仍是 table-centric(表中心) 的。LLM 场景里,列由 UDF(用户自定义函数)依赖 DAG 算出,还要在 CPU / GPU 之间选路。缺的不是又一张开放表,而是一层 feature-centric(特征中心) 的生命周期。
二、怎么做:逻辑统一,物理持续演进
核心原则是 Logical Unification, Physical Separation:用户始终操作一张稳定的逻辑宽表,系统则在不改变语义的前提下持续调整底层物理布局。
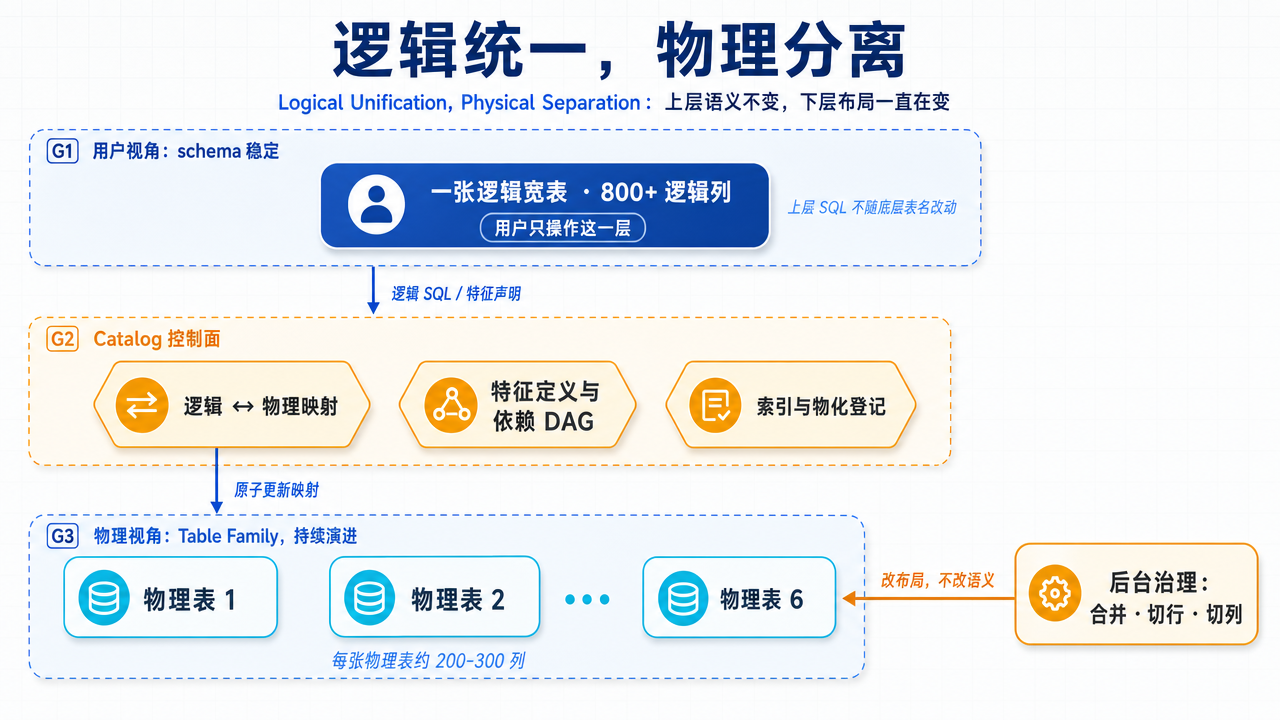
上面一层永不变,下面一层一直在变,中间靠 Catalog 隔离——本节要讲的就是这三件事。
逻辑宽表是一份契约,不是一张巨表
论文 Listing 1 给出的逻辑结构如下,字段名保留原文,省略号也是原文的一部分:
CREATE TABLE OmniTable (
  -- 全局主键,也是血缘锚点
  _ai_unique_id_  STRING NOT NULL,

  -- 接入批次 / 数据来源标签
  _ai_append_name_ STRING NOT NULL,

  -- 按处理阶段组织的核心数据
  RawData       STRUCT<...>,
  ProcessedData STRUCT<...>,
  TrainableData STRUCT<...>,

  -- 持续增加的派生特征
  Feature_1 <Type1>,
  ...
  Feature_N <TypeN>
);
可以按“两个系统字段、三个阶段容器、N 个特征列”来记:
| 结构 | 作用 | 论文中的用法 |
|---|---|---|
_ai_unique_id_ | 对齐同一样本的原文、中间态和特征 | 默认取 raw_data 的 MD5;不需要内容去重时改用 UUID |
_ai_append_name_ | 标记来源、批次和版本 | 用于批次裁剪、增量回填和审计回溯 |
RawData | 原始载荷 | 接入时可把来源字段 body_text 映射为 raw_data |
ProcessedData | 解析、清洗后的中间结果 | 可用 ProcessedData_v2 保留新版本,不覆盖旧口径 |
TrainableData | 可送入训练的形态 | 位于清洗、过滤之后 |
Feature_1...N | 质量、语言、合规、去重等派生值 | 每列都有定义、依赖、版本和计算状态 |
这份 DDL 是逻辑契约,不要求存储引擎真的塞进一张无限宽的表。MaxCompute 单表约有 1200 列上限,而 Web 宽表虽有 800 多个逻辑列,底层实际拆在 4–6 张物理表中,每张约 200–300 列;列继续增加时,后台按访问频率迁移冷列,用户看到的 schema 不变。
Catalog 是真正的控制面
支撑“物理可变”的是 Catalog。它维护逻辑 schema、逻辑到物理的映射、特征定义与依赖 DAG,以及索引和物化视图登记;前台的接入、回填、查询与后台的拆表、合并、物化都经它协调。映射被拆成五层:
| 元数据对象 | 表示什么 |
|---|---|
LogicalTable | 用户看到的完整宽表,例如 aidata://tables/web |
LogicalColumn | 带名称、类型和语义说明的逻辑列 |
PhysicalTableGroup | 按功能或批次组织的一组物理表 |
PhysicalTable | MaxCompute 或 OSS 上真实存在的表或文件 |
PhysicalColumn | 物理列,通过双向引用关联到逻辑列 |
因此后台切列、合并小分区或构建物化视图时,只需原子更新映射关系,上层 SQL 和特征定义不必跟着底层表名改动。
四类动作:加行、加列、读表、改布局
接入是加行。 omni-cli submit 做字段映射,生成主键和批次标签,写完再提交元数据。默认用原文内容的确定性哈希当 ID,接入时自然完成内容去重;不需要内容去重的场景(论文以 SFT 为例)可改用随机 UUID。Web 宽表已接入超过 25 PB、200 多个批次。
特征是加列。 用户注册特征定义,再提交回填计划,系统随后按 DAG 补齐未算过的祖先特征、生成物理计划并做算子融合、按拓扑调度并提供 UDF 级容错,最后把状态、物理位置和血缘写回 Catalog。生产中约 70% 特征走 CPU,约 20%(fastText / BERT 一类)按模型大小和资源动态放置,约 10%(例如 Qwen 的困惑度)固定走 GPU——用户不必自己挑集群。
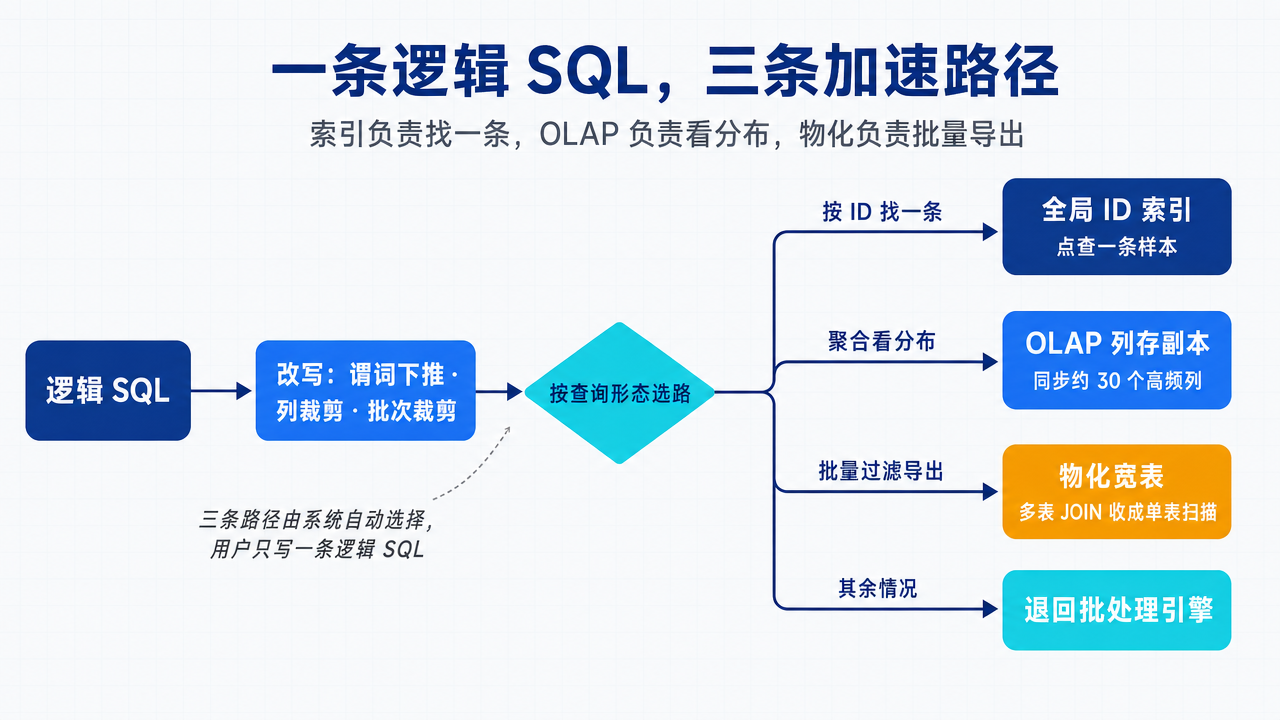
探索是查和导。 逻辑 SQL 被翻译成对物理表族的计划,在谓词下推、列裁剪和批次裁剪之后自动选三条加速路:HBase 上的全局 ID 索引做点查,高频特征列同步到 ClickHouse 做聚合,后台按列共现物化宽表,把过滤导出从多表 JOIN 收成单表扫描。
治理是后台长跑。 小文件合并、按哈希切行、按频率切列都走 Prepare–Execute–Commit,前端读取到的是查询开始时的元数据快照。代价写在明处:物化热点列组约多占 8–15% 存储,合并约吃掉集群 5–8% 资源。
“声明式资产”长什么样:以 quality_score 为例
旧工作流里,工程师要先找到所有相关数据表,为每张表配置 BERT 评分任务,决定 Spark 参数和结果表,失败后还要排查、删除异常记录、重新提交。特征只有一个,需要维护的却是一组脚本、任务节点和临时表。
OmniTable 里,工程师描述的是“我要什么”。按论文 Listing 2 的 schema,quality_score 的定义大致如下(示意,非论文公开的生产代码):
FeatureDefinition {
  inputColumns: [parsed_text, detected_lang],
  outputColumns: [{
    name: quality_score,
    type: FLOAT,
    analysisType: quality,
    comment: "文本质量评分"
  }],
  defaultFeatExpression: bert_quality_score(...),
  computeEngine: <engine_preference>,
  tablePath: aidata://tables/web
}
原文的完整字段还包括并行度、运行时 hints 和过滤条件。关键在于,注册之后 quality_score 不再只是某个仓库里的一段 UDF,而成为 Catalog 能管理的资产:系统知道它依赖哪些列、由哪一版逻辑算出、哪些批次已经回填,也能在结果异常时沿血缘追到具体特征版本和输入批次。
所以声明式资产的含义是:工程师声明特征的定义、依赖和目标,系统负责执行、存储、追踪与复用。 变化不在于少写几行代码,而在于系统第一次能回答“它是什么、从哪来、算到哪、谁用过”。
一条样本怎么穿过这套结构
论文未披露真实语料内容,但给出了字段映射、批次名和特征依赖。据此拼出的一条 Web 记录形态如下(尖括号内为示意值):
{
  "_ai_unique_id_": "md5(<raw_data>)",
  "_ai_append_name_": "cc",
  "RawData":       { "raw_data": "<来源字段 body_text 映射而来>" },
  "ProcessedData": { "parsed_text": "<html_parser 的输出>" },
  "TrainableData": null,
  "detected_lang": "en",
  "text_length": 1287,
  "quality_score": 0.83,
  "math_recall": 0.21
}
接入时,服务把来源字段 body_text 映射成 raw_data,生成全局 ID,并登记到批次 cc。此后若只要求在 cc 上回填 math_recall,系统不会直接执行最后一个 UDF,而是沿论文 Figure 3 的真实依赖子图向上展开:
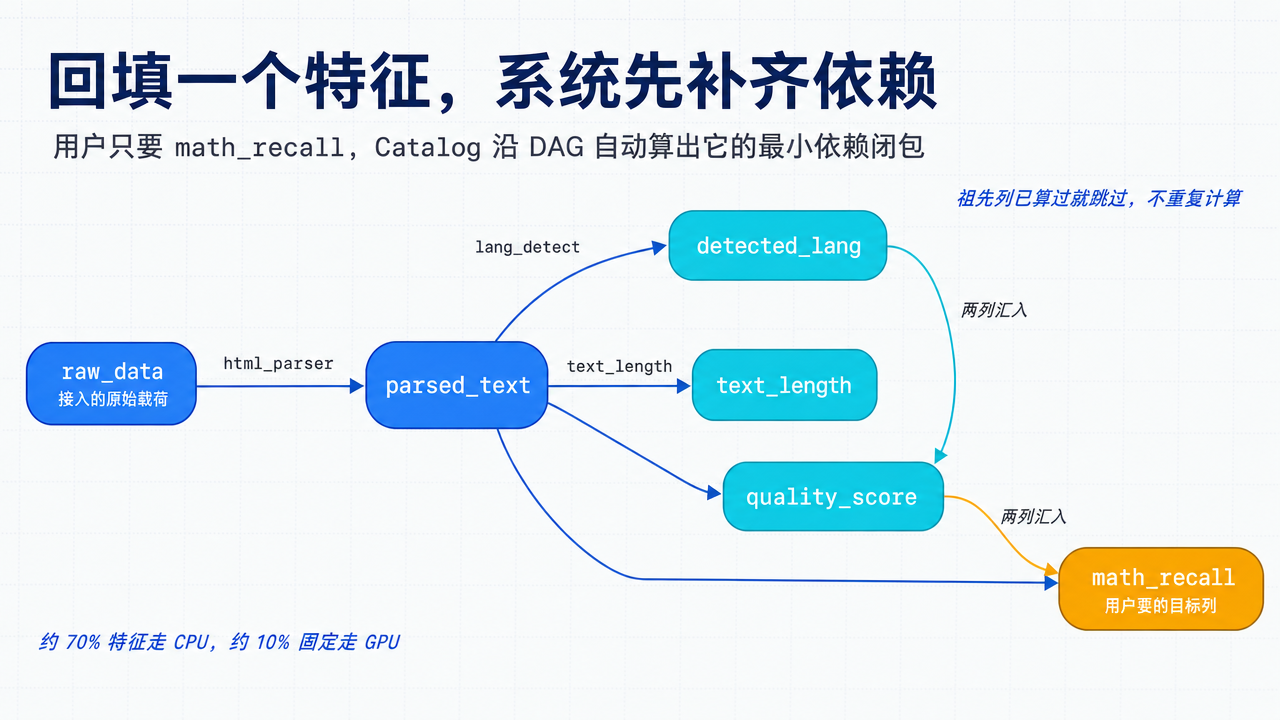
Catalog 检查哪些祖先列尚未计算,只补齐最小依赖闭包;而查询 WHERE _ai_append_name_ = 'cc' 时,又能直接裁掉其他批次的物理表。一个例子就把四件事串起来了:样本靠 ID 对齐,接入靠批次管理,特征靠 DAG 演进,物理表由 Catalog 定位。
它不替代湖仓、算子库或特征商店
Data-Juicer、Dolma、RedPajama 一类工具解决“这一步怎么洗”,OmniTable 解决“洗完登记成哪一列、依赖谁、放在哪里、以后怎么复用”;Feast、Tecton 一类特征商店面向结构化特征的低延迟在线服务,OmniTable 面向的是原始非结构化文本上的 PB 级 UDF 回填。它位于更上层,把已有算子接进统一生命周期,而不是重新发明每一种清洗算法。
三、实验与结果
这是工业论文,主证据不是公开榜单排名,而是同一项生产任务在旧流程与 OmniTable 下的成本差异。因此全文最醒目的 5.6× 是端到端流程收益:既含计算优化,也含少找表、少接线、少排障、少重提任务省下的协调成本。后续三组系统实验再把这个总数拆开。
实验跑在什么规模上
| 逻辑宽表 | 记录数 | 体量 | 逻辑列 | 物理表 | 批次 |
|---|---|---|---|---|---|
| web | 3000 亿+ | 25 PB | 800+ | 6 | 200+ |
| code | 34 亿 | 3.8 PB | 350 | 4 | 85 |
| 18 亿 | 5.2 PB | 280 | 3 | 62 | |
| post_sft | 2.1 亿 | 0.8 PB | 120 | 3 | 45 |
| 合计 | 3050 亿+ | 35 PB | — | 16 | 392+ |
硬件也不是实验室小集群:CPU 侧约 12,000 个节点(每节点 64 核、256 GB 内存),GPU 侧约 300 张 NVIDIA L20。所有时间取三次运行的中位数。
5.6×:主要省在特征回填
端到端场景是一项真实 SFT 数据准备任务:从 8 个来源接入数据,计算 12 个特征(9 个 CPU UDF、3 个 GPU 推理),覆盖质量、安全和领域分类,最后导出高质量子集。两种方案使用相同输入批次和过滤阈值。
旧流程约需 14 天:接入 2 天,特征回填 9.5 天,过滤导出 2.5 天。回填最慢,因为 12 个特征要跨 8 张表手工编排,画布上约有 96 个节点;导出还要手写多路 JOIN。OmniTable 约需 2.5 天:8 条接入命令 0.5 天,一份回填计划 1.7 天,一条逻辑 SQL 完成导出 0.3 天。手工步骤从 45 降到 12(减少 73.3%),独立管线或脚本从 24 降到 10(减少 58.3%)。
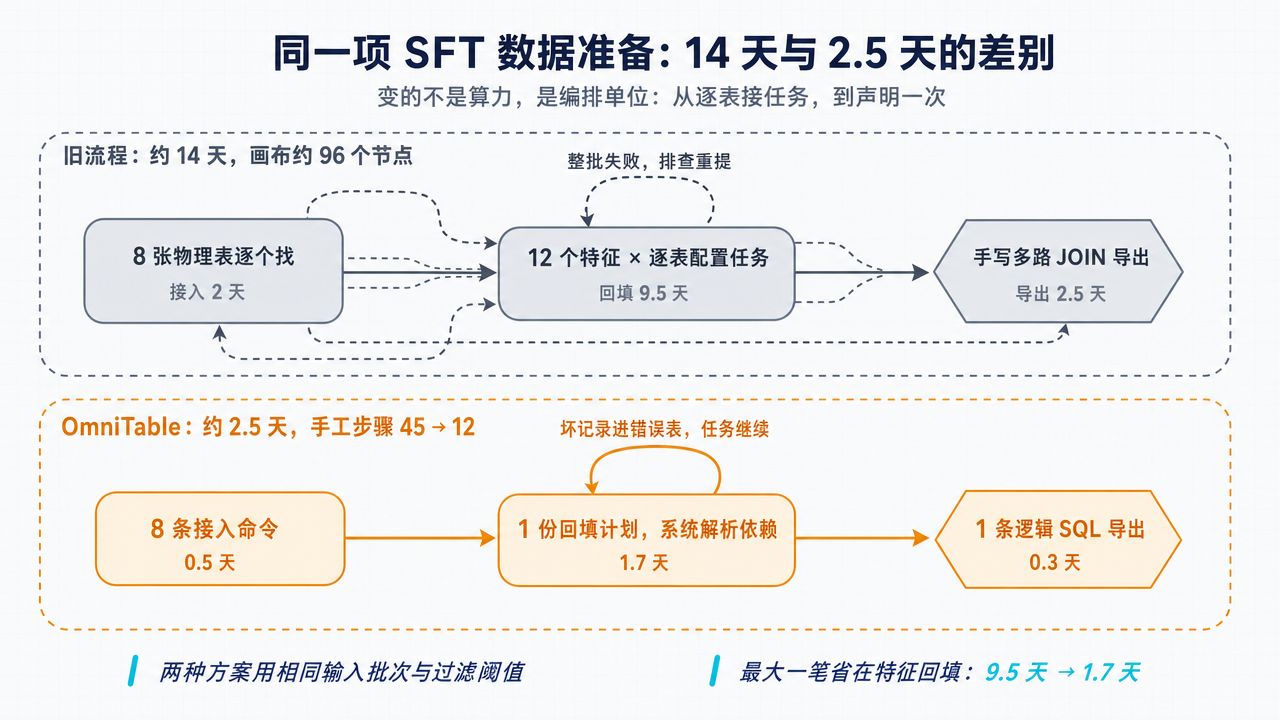
省掉的主要是人等任务、查错误、重接管线的时间,而不是底层算力快了 5.6 倍。
三组系统实验:这些时间从哪里省出来
规模:没有后台治理,宽表迟早会坏。 固定 15 列过滤导出,数据量从 1 TB 增至 25 PB,OmniTable 吞吐维持在 18–23 TB/h;关闭小文件合并、行切分和列切分后,1 PB 以上开始下降,25 PB 时只剩约 5 TB/h,旧流程则约 2 TB/h。列宽实验结论一致:约 2 PB 数据上逻辑列从 200 增至 2500,P95 延迟仅从约 25 秒升至 38 秒;关闭治理后 1500 列时已升至约 110 秒,继续增加还会因超过引擎列数上限而失败。逻辑统一能否成立,取决于物理布局能否持续自我调整。
执行:收益来自少扫描、少失败。 8 个共享 parsed_text 的 CPU 特征在约 2.5 PB 的 Common Crawl 批次上,算子融合把 8 次扫描合并成 1 次,CPU Hours 从 42K 降至 18.5K(减少 55.9%),端到端从 38 小时降至 14 小时(2.7×)。容错实验更说明 PB 级任务为何难做:500 GB、约 6 亿条记录中仅 0.005% 的异常数据(31,247 条)就足以让整批任务失败;启用 UDF 级隔离后,异常被写入错误表,其余数据一遍跑完,约 6.2 小时且无人工介入,而旧流程需要三轮排查重提、约 52 小时。自适应调参还把新手首次提交成功率从约 60% 提到 90% 以上。
探索:不同查询走不同加速路径。 3000 亿条记录上,全局 ID 索引把单条点查 P50 从 184 秒降到 8.3 秒,P99 从 612 秒以上降到 14.7 秒;聚合查询卸载到 ClickHouse 后获得 94–154× 加速,均在 10 秒内完成。过滤导出依赖物化视图:查询 15 列、跨 4 张物理表时,不用物化只有约 4.8 TB/h,物化后升至 20.1 TB/h(4.2×),刚好跨过论文设定的目标线。三条路径各管一类问题——索引负责找一条,OLAP 负责看分布,物化负责批量导出。
四、三条工程教训
实验说明系统有效,第 6 节的复盘则解释了团队为何做成这样。
记录级容错不是边角优化。 它增加约 3–5% 的执行开销,却替代了过去 30–40% 用于排障的工程时间。在几十亿条数据里,“坏记录很少”不等于“影响很小”:只要失败粒度还是整项任务,极低异常率也会产生极高人工成本。
后台治理不是可选项。 团队起初也把合并和拆表当成“以后再做”的优化;三个月内小文件就让查询慢了 3–5×,列数也开始触碰引擎上限。
采纳速度比能力清单更重要。 算法工程师习惯直接写 SQL,若新系统要求先放弃原有工作方式,最可能的结果是被绕开。因此 OmniTable 仍让用户查询逻辑宽表、用模板注册特征,并把血缘做成可 SELECT 的表——先让痛点消失,自动依赖解析和异构路由才有机会发挥作用。
五、证据边界
主对照是蚂蚁自己的旧生产流程,而非其他开源算子库或湖仓引擎的单算子性能。若对照系统本来就高度自动化,5.6× 不会原样成立。
物理栈也绑得很深:MaxCompute / Spark、OSS、HBase、ClickHouse,以及约一万两千节点的 CPU 池。可搬走的是“逻辑契约 + 声明式回填 + 记录级容错 + 布局持续演进”这套设计,不是把 Table Family 原样抄到另一朵云。
加速手段同样有账要算:热点列组带来 8–15% 额外存储;索引覆盖 3000 亿条记录后点查仍是数秒而非毫秒;ClickHouse 只同步约 30 个高频列,其余查询会退回批处理引擎。论文也没有提供跨公司可复现的公开基准,作者的理由是与特征商店直接比较会混淆问题定义——解释合理,但也意味着外部团队无法在自己集群上跑同一套实验。至于智能推荐、批流一体和合成数据血缘,目前仍是未来工作,不是已交付的能力。
ICE 观察
🔧 技术视角
湖仓管的是“表怎么存、怎么演进”,OmniTable 往前一步管“列怎么成为可治理资产”。对数据平台来说,这意味着特征定义、版本、回填状态和血缘都应该进入 Catalog,而不是继续散落在 Airflow 图和笔记本里。
更值得注意的是,Catalog 在这里还接管了调度决策:同一个特征该走 CPU 还是 GPU,由它按算子特征和资源状况决定,而不是由写 UDF 的人在提交脚本里写死。特征一旦成为元数据对象,引擎选择就不再是使用者的负担。
🏢 落地视角
可落地的不是“我们也做一张 800 列的宽表”,而是用三个问题审计现有工作流:增加一个特征,是否要按数据集数量重新接任务?0.005% 的坏样本,是否会让整批 TB 级任务失败?物理布局三个月不维护,查询性能是否会持续恶化?
记录级隔离、自适应调参和后台拆合分别对应这三问。代价也很明确:额外存储、后台集群资源,以及一个必须长期维护的 Catalog。没有能力维护元数据控制面的团队,逻辑宽表最终只会变成另一张难查的大表。
🇨🇳 本土视角
这篇论文少见地公开了国内大模型数据工厂的生产细节:四张领域逻辑表、35 PB 数据、画布时代一次要拖 106 张表,以及如何用映射层绕过 MaxCompute 的列数上限。
技术栈带着明显的蚂蚁痕迹,但问题并不只属于蚂蚁——任何用 Data-Juicer 一类工具处理多来源语料的团队,都会在特征增多、实验频繁、结果需要复现时撞上同一面墙。更值得借鉴的是它的采纳策略:先保留 SQL 这个熟悉入口,再把流水线编排逐步藏到系统后面。
结论
- 瓶颈已经换层。 当语料和特征持续增长,主要矛盾从“算子够不够用”变成“人能不能编排、追溯和复用”。OmniTable 让样本与特征成为工作单元,物理表和作业退居实现层。
- 5.6× 衡量的是流程,不是算力。 14 天 → 2.5 天、45 步 → 12 步,来自依赖解析、算子融合、容错和物化共同减少的等待与排障。
- 逻辑统一必须由物理治理托底。 没有持续拆分、合并和物化,PB 级数据与上千列 schema 很快出现性能断崖。
- 真正可复制的是设计顺序。 先稳定逻辑语义,再让物理布局按负载演进;把特征登记成资产,把血缘做成可查询数据。这比复制一套 12,000 节点的机房更重要。
如果你也在养训练语料,不妨先问一句:
你现在加一个质量分,是改一列,还是重新拖一遍画布?
参考资料
- Yuzhuo Fu, Xiangchun Wang, Chao Huang, et al. OmniTable: A Unified Wide-Table System for Petabyte-Scale LLM Data Curation and Exploration. PVLDB 19(12): 4276–4289, 2026. arXiv: 2609.11148
- Michael Armbrust et al. Delta Lake: High-Performance ACID Table Storage over Cloud Object Stores. PVLDB 13(12), 2020. https://doi.org/10.14778/3415478.3415560
- Apache Software Foundation. Apache Iceberg. https://iceberg.apache.org
- Daoyuan Chen et al. Data-Juicer: A One-Stop Data Processing System for Large Language Models. SIGMOD Companion, 2024. https://doi.org/10.1145/3626246.3653388
- Luca Soldaini et al. Dolma: An Open Corpus of Three Trillion Tokens for Language Model Pretraining Research. ACL, 2024. https://arxiv.org/abs/2402.01363
本文部分内容由 AI 辅助生成,经人工审校和补充后发布。