持续学习:AI 实验室的第一条护城河,长在你删不掉的那部分记忆里
8 月 7 日,Dwarkesh Patel 发了一篇没有嘉宾的独角戏,题目叫《持续学习时代的八个预测》。八条里有对齐范式的变化,有监管节奏的建议,有对模型心智多样性的判断。但真正值钱的是夹在中间讲护城河的那一条——他顺手回答了一个已经悬了三年的问题:AI 实验室到底靠什么赚钱。
这个问题一直没有好答案。模型能力在收敛,价格在跳水,谁也说不清为什么这门生意最后能有高毛利。Dwarkesh 给出的答案是:持续学习会造出实验室现在完全不具备的东西——切换成本。
他的论证很短,但结构很硬。而这篇文章想做的,是把他省略掉的那个前提补出来,再顺着这个前提往下算三笔账。因为一旦你把前提写清楚,会发现持续学习不是一个单纯的能力升级,它是一次关于你的上下文归谁的重新分配。
今天你能带走的那部分记忆,恰恰是今天不构成护城河的那部分记忆。这句话反过来也成立,而反过来的那一面,才是接下来两年真正的博弈。
一、他的论证:云的高毛利来自搬家太贵
先把 Dwarkesh 的原话摆出来。他说自己在播客上问过 Dario Amodei 这个问题,对方类比了云厂商——云也卖大量无差别的服务,照样有高利润率。Dwarkesh 认为这个类比恰恰漏掉了关键:
云的毛利之所以高,是因为从一家云搬到另一家云既费时又费钱。但目前换 AI 模型是没有切换成本的。没有任何东西能阻止我用 Codex 开一个代码仓库,再用 Claude Code 把它写完。
这句话在 2026 年 8 月是成立的。而持续学习会把它变成不成立。他描述的场景是:当模型在与你的逐次交互中真的变好,换供应商就不再是改一个 API endpoint,而是解雇一个已经积累了几个月组织上下文的员工,再招一个新人从头培训。锁定一旦成立,厂商就可以开始要价。
他还预判了企业的反应,以及实验室的反制。企业当然想躲开这种锁定,但选择会被摆成一道二选一:要么被锁定,要么放弃"模型会随着使用越来越懂你"这个特性。而实验室手上有胡萝卜也有大棒——补贴那些允许在自己会话上训练的用户和企业,尤其是经济价值高的硬活;同时可以规定,拒绝让模型从会话中学习的企业,拿不到最好的那一档模型。
这套推演本身没什么破绽。问题在于它有一个被跳过的技术前提:模型从你身上学到的东西,到底存在哪里。
二、今天所有能用的"记忆",都长在权重外面
要判断护城河能不能成立,得先看清现在的产品到底做到了哪一步。这一节的结论有点反直觉:市面上被称作"记忆"的功能,没有一个是 Dwarkesh 说的那种记忆。
ChatGPT 的记忆现在分三层:用户明确要求记住的 saved memories、对全部历史对话的自动召回、以及按项目隔离的记忆。OpenAI 在帮助文档里解释过为什么要改版——旧的手动保存机制容易过期,还会自相矛盾,比如同时存着"我在备战马拉松"和"我扭伤了脚踝"。新系统让模型自己判断什么重要并自动更新。但无论哪一层,机制都是同一个:事实存在后端数据库里,推理时作为上下文注入。
Claude 走得更远也更直白。它的记忆是文件——agent 往一个 /memories 目录里写,后续会话按需加载。用户能在设置里逐条读、逐条改、逐条删;敏感话题(健康、信仰)默认不写入;聊天和 Cowork 共用同一份记忆。Anthropic 在公告里强调的卖点是"文件很短,改一次一劳永逸:把公司的旧名字在一个文件里改掉,之后所有对话都对了"。
这里有个细节值得停一下。有欧洲的实践者指出,Claude 这种基于文件的跨会话记忆和 Gemini 的记忆功能,是目前少数在 GDPR 下能用的选项——而它能合规的原因,恰恰就是它是一个文件:可读、可导出、可逐条删除、删了就是真删了。
| 上下文注入 | 外部记忆文件 | 参数更新 | |
|---|---|---|---|
| 信息存在哪 | 会话窗口,用完即散 | 数据库或文件,独立于模型 | 模型权重内部 |
| 谁能读 | 用户和厂商都能看到原文 | 用户可逐条查看 | 无法直接读取,只能探测 |
| 能否删除 | 关掉会话即消失 | 删文件即删除 | 无理论保证的删除方法 |
| 换供应商时 | 无成本 | 可导出,重新灌给新模型 | 带不走 |
| 是否构成护城河 | 否 | 基本不构成 | 是 |
把这张表从左往右读,会看到一条很清晰的规律:记忆越容易删除,护城河越薄;护城河越厚,删除权越难落实。 这不是巧合,这是同一个物理性质的两面。文件之所以带不来锁定,就是因为它能被复制走;权重之所以能带来锁定,就是因为它复制不走,也删不掉。
洞见一:可携带性与护城河是同一个变量的两端
今天各家都在把记忆做成用户可控的文件或条目,既是合规选择,也说明它们还没能力做另一种。一旦某家做成了权重级的持续学习,它会同时获得护城河和一个合规上的硬问题,两者一起到货。
三、要形成护城河,记忆必须往权重里沉
学术界这两年的工作,方向出奇一致:都在想办法把"新信息"从上下文里挪到参数里,同时不破坏已有能力。
最常被引用的一支是给模型加一块专门的记忆参数。Titans 在推理时用"惊奇度"驱动的梯度信号更新一个专用记忆模块,关键设计是只改记忆参数,不动主干,这样预训练知识不受影响。MEMORYLLM 换了个思路,在各层之间嵌入一个固定大小的潜在记忆池,靠前向自更新刷新内容,连梯度都不需要。Nested Learning 更进一步,给不同参数子集配不同的更新频率,让它们在不同时间尺度上各自演化。
另一支直接改主干。ICLR 2026 那篇 In-Place Test-Time Training 的做法是把 MLP 块里最后那个投影矩阵征用为"快权重",在推理时更新它。它有两个工程上的讲究:一是把 TTT 通用的重建目标换成与下一 token 预测对齐的目标,二是用分块更新来保证能和上下文并行兼容。效果是一个 4B 模型在长达 128k 的上下文任务上取得了更好的表现,而且是不用从头重训的"即插即用"增强。
最有意思的是 SCoL(Self-Consolidating Language Models)。它让模型自己生成一段文本形式的更新指令,指定应该把当前上下文写进自己的哪几层。因为每次提交的更新都会改变那个"将来负责决定往哪写"的模型本身,训练只能用元强化学习来做。研究者事后分析学到的模式,发现模型选择的更新位置很稀疏,而且与高 Fisher 信息的层高度重合——它自己学会了把可塑性路由到对损失最敏感的区域,同时把干扰控制住。
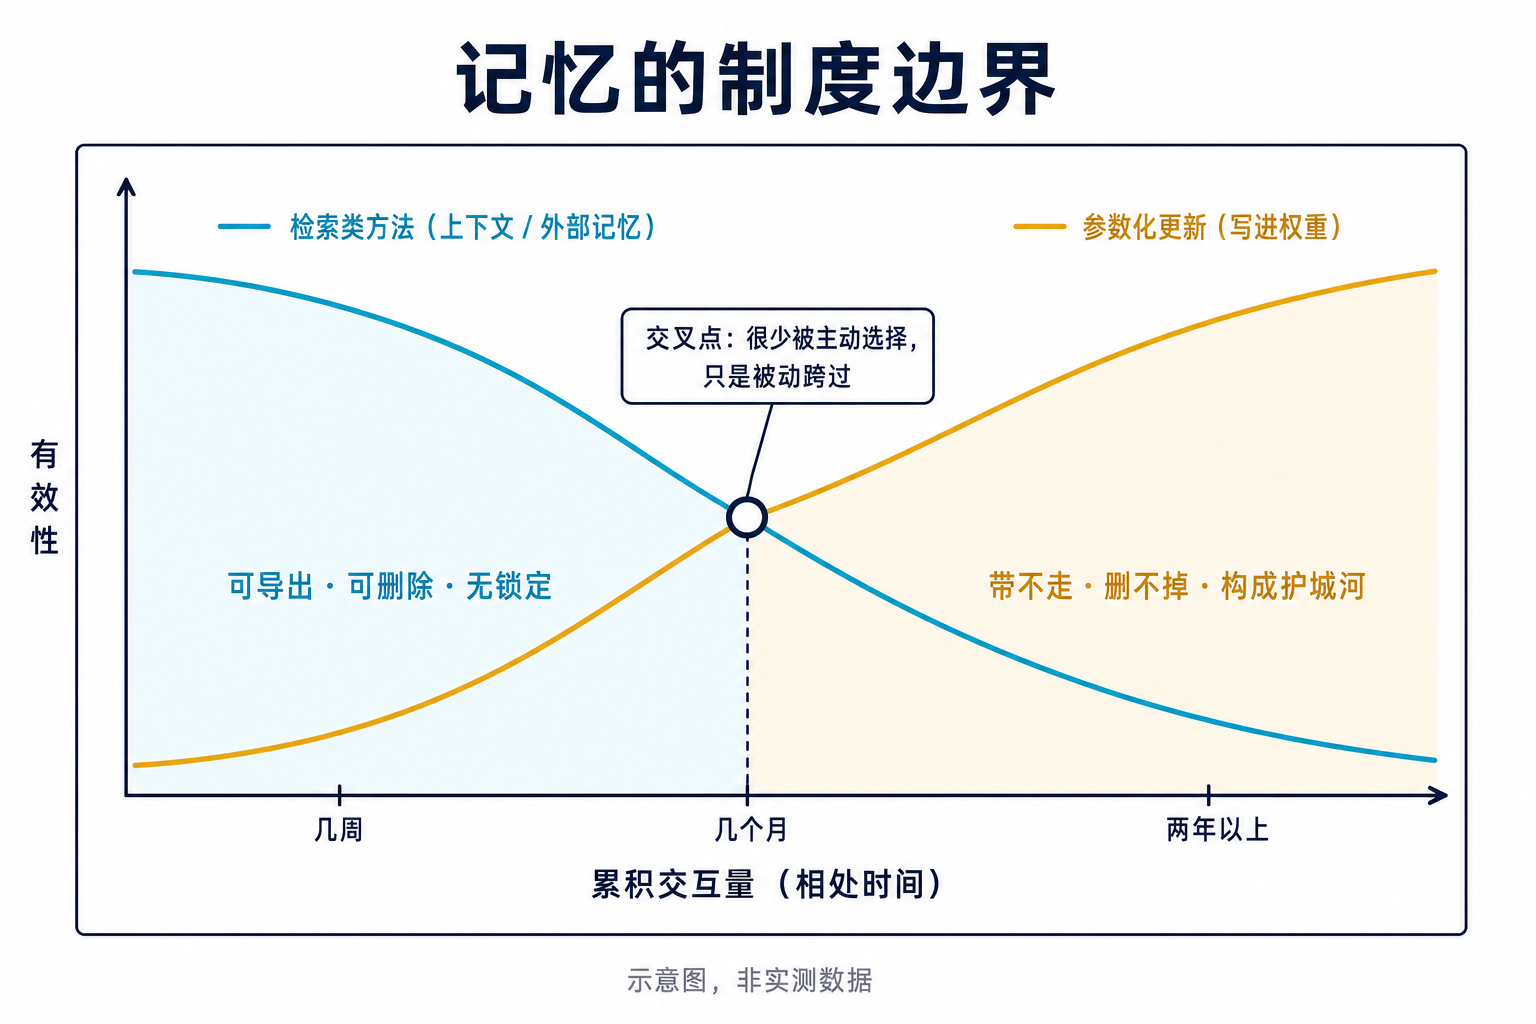
那么这条路走到哪一步了?有一份叫 IMPRINTBENCH 的工作给出了目前最有用的一个判断,它测出了一条制度边界:语料规模小的时候,检索类方法占优;语料大到一定程度之后,参数化更新反超。同一份工作也很坦率地承认局限——它的语料超出典型上下文窗口但没超出几个数量级,因此还没有真正压到"数月乃至数年积累"那个区间,而恰恰是在那个区间,上下文类方法会进一步吃亏、参数化方法可能全面占优。
这句话翻译成产品语言就是:持续学习不是一个开关,是一条随着你和模型相处时间变长而必然被跨过的线。 一个企业用某个模型用满两年之后积累的交互量,几乎注定落在参数化方法占优的那一侧。
四、第一笔账:写进权重之后,推理经济学只对大公司成立
假设这条线被跨过了,第一个后果不在合规,而在成本,而且这笔账算下来的方向可能和直觉相反。
八条预测里关于规模经济的那一条讲的就是这个。他的估算是,像 DeepSeek V3 这类稀疏模型,推理的最优批量在 2400 以上——也就是说,除非你的模型同时在生成这么多条序列,否则算力就没吃满。原因在他和 Reiner Pope 那期讲推理经济学的节目里有完整推导,这里只需要结论:一组权重只有在数千条序列同时对它解码时,才被服务得高效。
于是问题就来了。如果每家公司都有自己那一份被持续更新过的权重分叉,谁来把批量填满?
- 一家大企业,员工加上 agent 能自己产生数千并发流量,它那份专属权重可以被高效服务;
- 一个个人用户,按批量 1 给自己提供服务,会吃到 100 倍以上的算力效率惩罚。
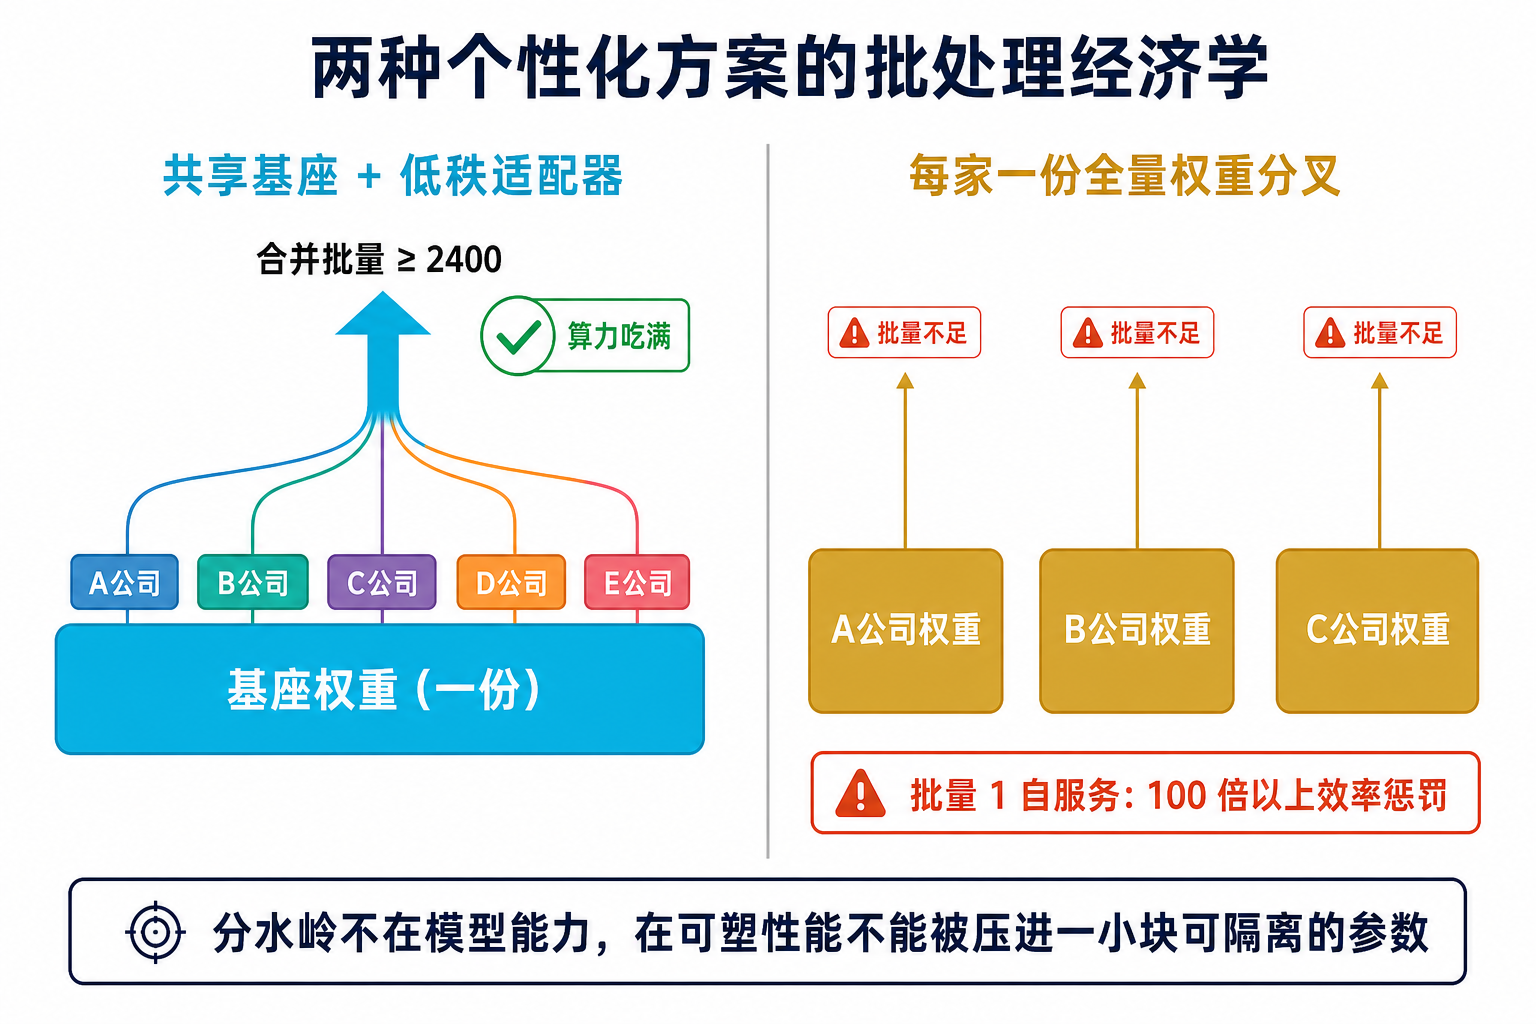
这中间的分水岭,是一个纯技术选择:每家公司的信息,是能装进低秩适配器,还是必须落到全量权重更新上。 如果能装进适配器,那么成百上千个适配器可以共享同一批基座权重一起批处理,经济学几乎不变;如果必须做全权重更新,每一个分叉都需要自己凑够批量。前一节那几条技术路线的分歧——Titans 只改记忆模块、In-Place TTT 只改一个投影矩阵、SCoL 稀疏地选几层——现在就有了成本上的意义:它们全都在努力把可塑性压缩进一小块可隔离的参数里,而这不只是为了防遗忘,也是为了让批处理还能成立。
洞见二:个性化权重的服务经济学,强烈偏向能自己产生并发的组织
这条结论和这个博客此前写过的收益集中是同一个方向的另一次显现。AI 的红利需要有能力接住它的载体,而"能不能把自己的批量填满",是一个非常具体、非常物理的门槛。中小企业和个人大概率会被推回共享权重那一侧——不是因为买不起订阅,而是因为专属权重对他们来说单位成本太高。
五、第二笔账:切换成本今天已经在积累,只是没人上报
Dwarkesh 说今天换模型没有切换成本。这句话在 API 层面是对的,在工程层面已经不对了。而这个偏差恰恰是最值得企业注意的地方。
先把几组调研数字放在一起看。
| 指标 | 数值 | 来源 |
|---|---|---|
| 生产环境运行五个以上模型的企业 | 37%(前一年 29%) | a16z,100 位企业 CIO |
| 预计依赖两家以上 LLM 提供商 | 81% | Dataiku 与 Harris Poll,600 位企业 CIO |
| 认为不同模型适合不同用例 | 93% | 同上 |
| 年度厂商切换率 | 11% | Menlo Ventures |
| 在现有厂商内部做版本升级 | 66% | 同上 |
| 担心对单一供应商过度依赖 | 81% | Zapier 调查 |
| 主要供应商下线会导致关键业务功能失灵 | 47% | 同上 |
| 浅层 API 迁移工作量 | 20—40 小时 | 行业统计 |
| 含微调与嵌入的深度集成迁移 | 80—120 小时 | 同上 |
| 切换成本占实施成本比例 | 19%—34% | 同上 |
| 某供应商倒闭后的实际迁移代价 | 40 条工作流、31.5 万美元、三个月 | 单一记录案例 |
上半张表和下半张表在讲两件相反的事。上半张说大家都在做多模型组合、都在防锁定;下半张说年度切换率只有 11%,而且三分之二的动作是在现有厂商内部做版本升级。
多模型是真的,切换是假的。 企业不是在保持随时可以走人的能力,而是在同时向好几家供应商各自积累依赖。而那个倒闭案例说明了真要走的时候是什么滋味:三个月里客户看到的功能处于降级或不可用状态,钱反而不是最疼的部分。
这些数字背后有一个判断,我认为是这一轮讨论里最准确的一句话:锁定不在 API,在 prompt。
真正让你走不掉的,不是接口格式,而是围绕某个模型调出来的提示词、护栏和评测集。而且这里有个绕不开的两难:一个能跨模型通用的 prompt,通常在每个模型上都不如针对该模型调优过的版本。也就是说,抽象层本身要交性能税,你越认真地防锁定,日常效果就越差一点,于是团队在一个个具体决策里总会选择不防。
拿 ERP 时代做对照会更清楚。当年的切换成本同样巨大,但它是可见的:多年期项目、明确的价签、需要董事会批准。今天的 AI 切换成本是通过一连串没人需要上报的日常工程决策累积起来的——调一版 prompt,加一条护栏,写一批针对某模型行为特点的评测用例。没有任何一笔需要审批,加总起来却构成了两年后你在谈判桌上的全部处境。而目前几乎没有企业有方法论去度量这个累积量。
洞见三:持续学习不创造切换成本,它只是把一笔已经存在的表外负债搬到表内,并交给供应商定价
这是这一节最要紧的结论。很多企业以为持续学习是一件"未来才需要考虑的事",因此可以等技术成熟了再评估。但成本积累是现在进行时,持续学习只是把它显性化、并把定价权交出去的那个时刻。
六、第三笔账:删除权,从一次性问题变成每天的问题
前两笔账是钱,这一笔是能不能合法运营。
法律上的起点很清楚。GDPR 第 17 条给了数据主体删除权。而技术上唯一有理论保证的机器遗忘方法,是精确遗忘——也就是全量重训。近似遗忘方法目前没有形成监管共识:如果数据仍然可以从权重中被统计地恢复出来,那么它就没有被删除,要证明"不可提取"需要正式的隐私审计,比如成员推断攻击测试。至于 SISA 这类分片隔离的架构,确实能让重训代价小得多,但它必须在初始训练时就设计进去,无法事后追加。
监管这边也已经把话说到位了。EU AI Act 第 10 条要求通用模型提供方记录训练中用到了哪些个人数据;如果从权重中完全删除在技术上不可行,这一点必须以残余风险评估的形式书面记录在案。换句话说,监管已经默认"删不掉"是常态,转而要求你把删不掉这件事说清楚。
国内的框架结论相似,路径不同。《生成式人工智能服务管理暂行办法》第七条要求训练数据处理涉及个人信息的须取得同意或符合其他法定情形,《个人信息保护法》第十三、十四条确立了知情同意的合法性框架。而学界已经在讨论如何让这条义务落地——有研究直接指出,已融入模型权重的数据影响"既难以精准定位,又难以彻底消除",因此主张从绝对删除义务转向相对删除义务,用事前的数据最小化、事中的隐私增强技术和事后的遗忘技术三段协同来替代一次性的彻底删除。还有一篇论文的标题把这件事说得特别干脆:《没有删除,只能遗忘》。
到这里为止,讲的都是训练阶段的老问题。持续学习真正改变的是它的时间结构。
过去,违规发生在训练的那一刻。它是一个点,你可以围绕这个点做文章:清洗语料、留存清单、做一次合规审查、出一份报告。而在持续学习之下,每一天的生产会话都是一次训练事件。你的客户数据不是"曾经被用于训练",而是"每天都在被写进权重"。那份残余风险评估要写成什么样子?它评估的对象每 24 小时就变一次。
这里也顺带回答了一个此前留下的问题。这个博客写过零数据留存的含义迁移——从"不保存"变成"我们看不见",可验证性从合同条款挪到了尚未公开的实现细节上。持续学习会让它再迁移一次,而且这一次更彻底:数据不在任何一个存储系统里,它在权重里。 你去查存储桶、查日志、查保留策略,全都是干净的。
还有一点比合规更难处理:opt-out 只能停止未来的更新,不能撤销已经发生的。 对于一个基于存储的数据处理协议,退出就意味着停止;对于一个基于权重更新的机制,退出之后模型仍然带着你过去十八个月的样子。这是一种在传统数据治理里没有对应物的不可逆性。
七、Dwarkesh 那条最可能落空的预测
八条预测里有一条,在文章发布一周后就被现实往反方向拽了,而这个反例比预测本身更有信息量。
他的第五条是:如果模型主要从部署中学习,实验室就会有压力更早地把最强模型发出去。他举的例子是 Anthropic 从二月起在内部使用 Mythos,六月才对公众发布,认为在持续学习的体制下,这四个月的内外差意味着白白让出四个月的部署学习;哪怕竞争对手发布当天的模型更差,它也能靠更多真实世界经验后来居上。
但 8 月 14 日,Anthropic 发布了第二份全公司风险报告,覆盖 2 月 24 日到 7 月 15 日。报告披露,截至覆盖日它手上有三个未公开发布的模型,其中 Model 2 的能力略强于已发布的 Mythos 5,内部能力指数上高出约 1.5 分。而报告对它的处置是:
我们目前没有对外发布这个模型的计划。
理由是它没有跑完全套发布前评估,因此公司对其能力估计的信心较低。同一份报告还把"高风险场景下失准导致灾难性危害"的风险评级从二月的"极低"上调到了"低"。同期,OpenAI 也因为对网络安全能力的顾虑放慢了 Astra 的发布节奏。
所以 2026 年 8 月的真实图景,是安全评估的滞后正在压过部署学习的竞争压力,方向和预测正好相反。
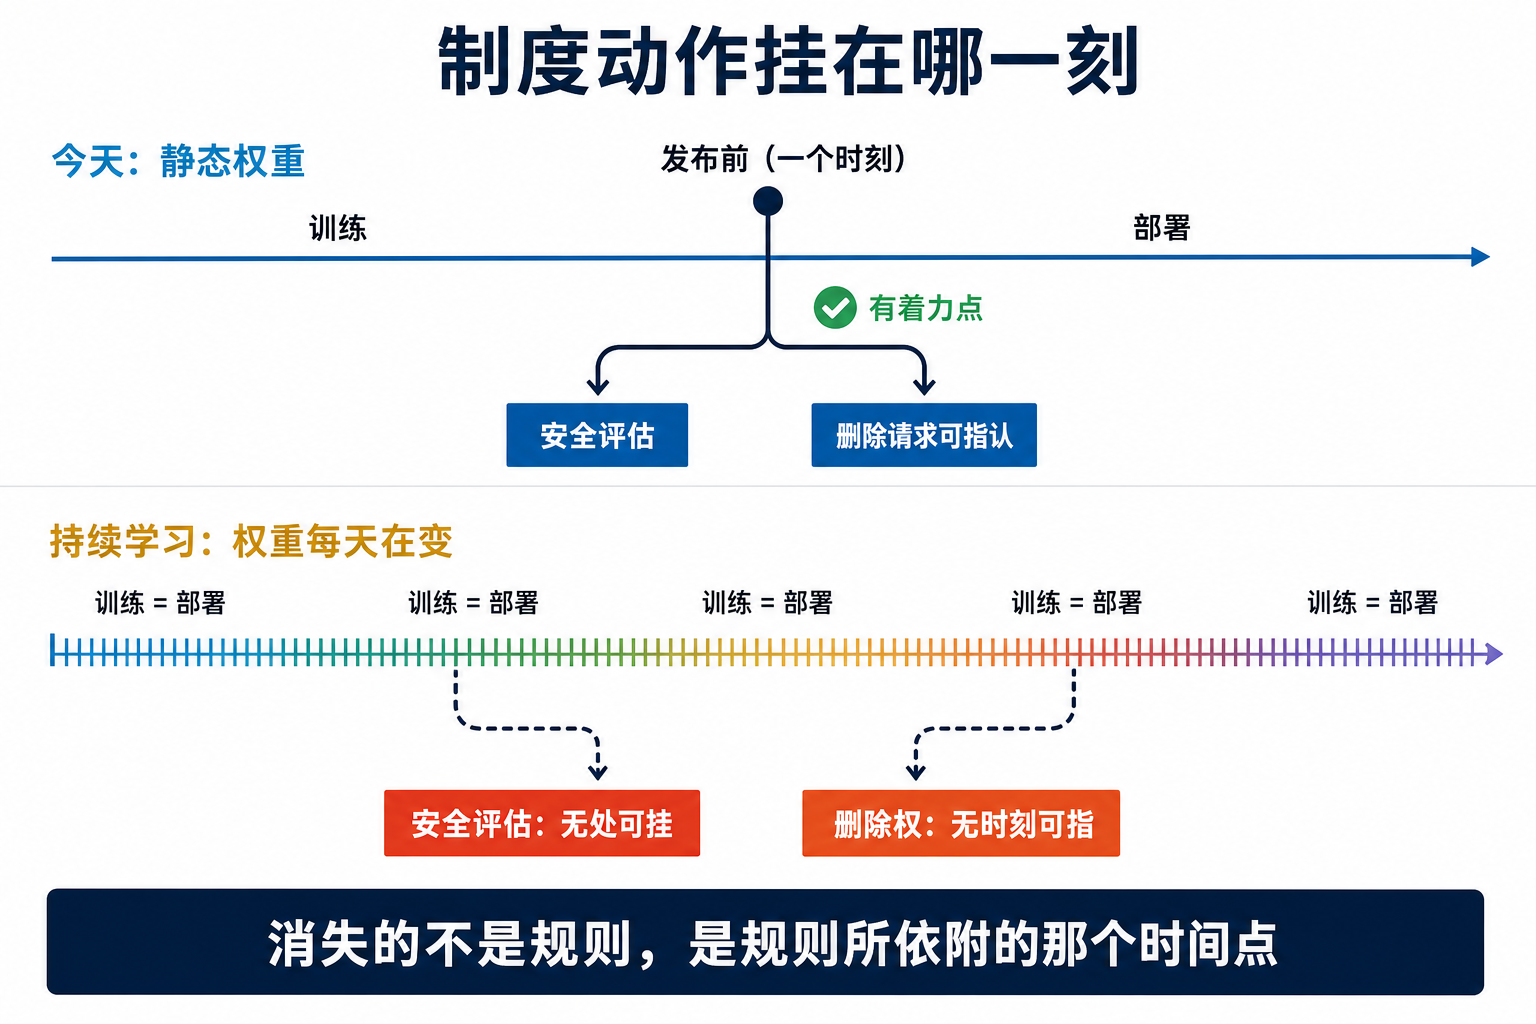
但这个反例恰恰印证了他的第一条。他在第一条里说,现在的监管提案普遍假设"先训练、后部署",因此只要在部署前做完检查就能兜住风险;而如果基座模型每天都在根据数百万次会话更新,这个假设就垮了,更合理的做法是改成月度或季度的风险巡检。把这两件事放在一起看,会得到一个有点凉的结论:
洞见四:当前这套安全治理之所以还能运转,正是因为持续学习还没做成
Anthropic 今天之所以能用"没跑完发布前评估"这个理由把一个更强的模型摁在内部,前提是这个模型的权重是静止的——存在一个明确的"发布前"。等到权重每天都在变,"发布前评估"就不再指向任何一个具体时刻,这个动作会连同它所依附的那套制度一起失去着力点。删除权失去的也是同一个东西:一个可以被指认的时刻。
八、企业现在该做的三件事
技术还没到,但决策窗口已经开了。这一节给三条现在就能执行的判断。
第一,把"记忆写在哪"写进采购条款,并且分开计价。 能导出的记忆和不能导出的记忆,是两种完全不同的商品,不应该用同一个价格买。合同里至少要能回答三个问题:模型从我们的会话中学到的东西以什么形态存在(上下文、外部文件、还是参数);终止合作时我们能带走哪一部分;不能带走的那部分,供应商是否承诺不将其用于服务其他客户。第三个问题现在几乎没有厂商正面回答过。
第二,开始度量你正在积累的切换成本,度量对象是 prompt、评测集和护栏的模型专属程度,而不是 API 抽象层。 大部分企业的防锁定动作都停在网关和统一 API 上,而那是问题里较小的一半。一个可操作的做法是给每一套生产提示词打一个标记:它是否依赖某个模型特有的行为?换模型后需要重调的比例是多少?把这个比例做成一个季度指标,它就是你两年后议价能力的先行指标。
第三,把"供应商是否用我们的会话做权重更新"从隐私问题升级为不可逆性问题。 这两者的处置方式不一样。隐私问题可以靠合同、审计和事后追责来管理;不可逆性问题只能靠事前拒绝来管理,因为一旦发生就没有回退路径。这意味着这个条款的谈判优先级,应该高于大多数常规的数据处理条款。
还有一个技术方向值得盯着,虽然它今天还在论文阶段。联邦式的持续学习——比如把线性注意力的记忆机制放进联邦学习框架,让客户端在本地做零样本的测试时适应,且推理内存保持恒定——试图回答的正是"不交出数据也能持续学习"这个问题。如果这条路能走通,前面三笔账的算法都会变。如果走不通,那么护城河、批量经济学和删除权这三件事,就会以现在推演的方式一起到来。
结论
读完可以带走四条:
持续学习的商业价值和它的合规难度,是同一个技术性质的两面。 记忆能被删除,就能被带走,也就不构成护城河;记忆构成护城河,就意味着它删不掉。今天所有能合规上市的记忆产品都站在前一侧,这本身就说明了后一侧还没做成。
真正的分水岭是低秩适配器还是全量权重更新。 这个纯技术选择同时决定了三件事:个性化权重的推理是否还能批处理(稀疏模型最优批量在 2400 以上,批量 1 要吃 100 倍以上的效率惩罚)、切换成本有多高、以及删除权还有没有一丝可能。评估任何一家厂商的持续学习方案,先问这个问题。
切换成本不是未来的风险,是正在积累的表外负债。 年度切换率只有 11%、而 37% 的企业同时跑五个以上模型,这两个数字放在一起说明的不是"大家很灵活",而是"大家在同时向多家供应商各自积累依赖"。锁定长在 prompt、护栏和评测集里,不在 API 里,而防锁定的抽象层本身要交性能税,所以团队在每一个具体决策上都倾向于不防。
别把安全治理今天还能运转,当成它明天也能运转。 Anthropic 能把一个更强的模型摁在内部不发,靠的是存在"发布前"这个时刻。删除权能被主张,靠的也是存在"训练时"这个时刻。持续学习取消的不是某一条规则,是这些规则共同依附的那个时间点。
最后留一个问题给正在做技术选型的人:如果你现在就去问你的模型供应商——"我们终止合作那天,你们从我们身上学到的东西,有多少能跟着我们走"——你觉得对方能给出一个写进合同的答案吗?如果不能,那笔资产现在记在谁的账上?
参考资料
- Dwarkesh Patel,《8 Predictions for the Era of Continual Learning》,2026 年 8 月 7 日。https://www.dwarkesh.com/p/era-of-continual-learning
- Dwarkesh Patel 与 Ryan Greenblatt,《What happens once AI can automate AI research?》,Dwarkesh Podcast,2026 年 8 月 11 日。https://www.dwarkesh.com/p/ryan-greenblatt
- Anthropic,《Redacted Risk Report August 2026》,2026 年 8 月 14 日。https://www.anthropic.com/aug-2026-risk-report
- Anthropic,《Claude's memory works everywhere, and you decide what's in it》。https://claude.com/blog/claudes-memory-works-everywhere-and-you-decide-whats-in-it
- OpenAI,《Memory FAQ: Memory in ChatGPT》,OpenAI Help Center。https://help.openai.com/en/articles/8590148-memory-in-chatgpt-remembering-what-you-chat-about
- 《In-Place Test-Time Training》,ICLR 2026 会议论文集。https://proceedings.iclr.cc/paper_files/paper/2026/file/ba6f5879d7f382241316f7dda7e6b8ac-Paper-Conference.pdf
- 《Self-Consolidating Language Models: Continual Knowledge Incorporation from Context》,arXiv:2605.07076。https://arxiv.org/html/2605.07076
- 《Federated Nested Learning: Collaborative Training of Self-Referential Memories for Test-Time Adaptation》,arXiv:2605.16350。https://arxiv.org/html/2605.16350
- 《Measuring the Limits of Continual Learning for LLMs》(IMPRINTBENCH),OpenReview。https://openreview.net/pdf?id=BlDEHKSGy9
- 《Memory for Large Language Models》(综述),arXiv:2607.25380。https://arxiv.org/html/2607.25380v1
- Artifipedia,《The lock-in is the prompts, not the API》。https://artifipedia.com/blog/vendor-lock-in
- Anthony West,《Enterprise LLM Vendor Selection and Consumption Models》。https://anthonywest.co.uk/research/enterprise-llm-vendor-selection
- Groundy,《Why Machine Unlearning Can't Certify GDPR Erasure》。https://groundy.com/articles/why-machine-unlearning-cant-certify-gdpr-erasure/
- sota.io,《Art.17 Right to Erasure: LLM Training Data Removal & RAG Vector Store Deletion 2026》。https://sota.io/blog/eu-ai-act-gdpr-art17-right-erasure-training-data-llm-2026
- 人民论坛网,《开源人工智能训练数据的合规治理》,2026 年 4 月 1 日。https://www.rmlt.com.cn/2026/0401/748659.shtml
- 陆杰、郭玥瑶,《从绝对到相对:生成式人工智能个人信息删除义务的制度再造》,2025 年。
- Unite.AI,《Anthropic Raises Misalignment Risk to Low and Shelves Internal Model 2》,2026 年 8 月。https://www.unite.ai/anthropic-raises-misalignment-risk-to-low-and-shelves-internal-model-2/
本文部分内容由 AI 辅助生成,经人工审校和补充后发布。