什么结构都不建的记忆系统,为什么赢了知识图谱
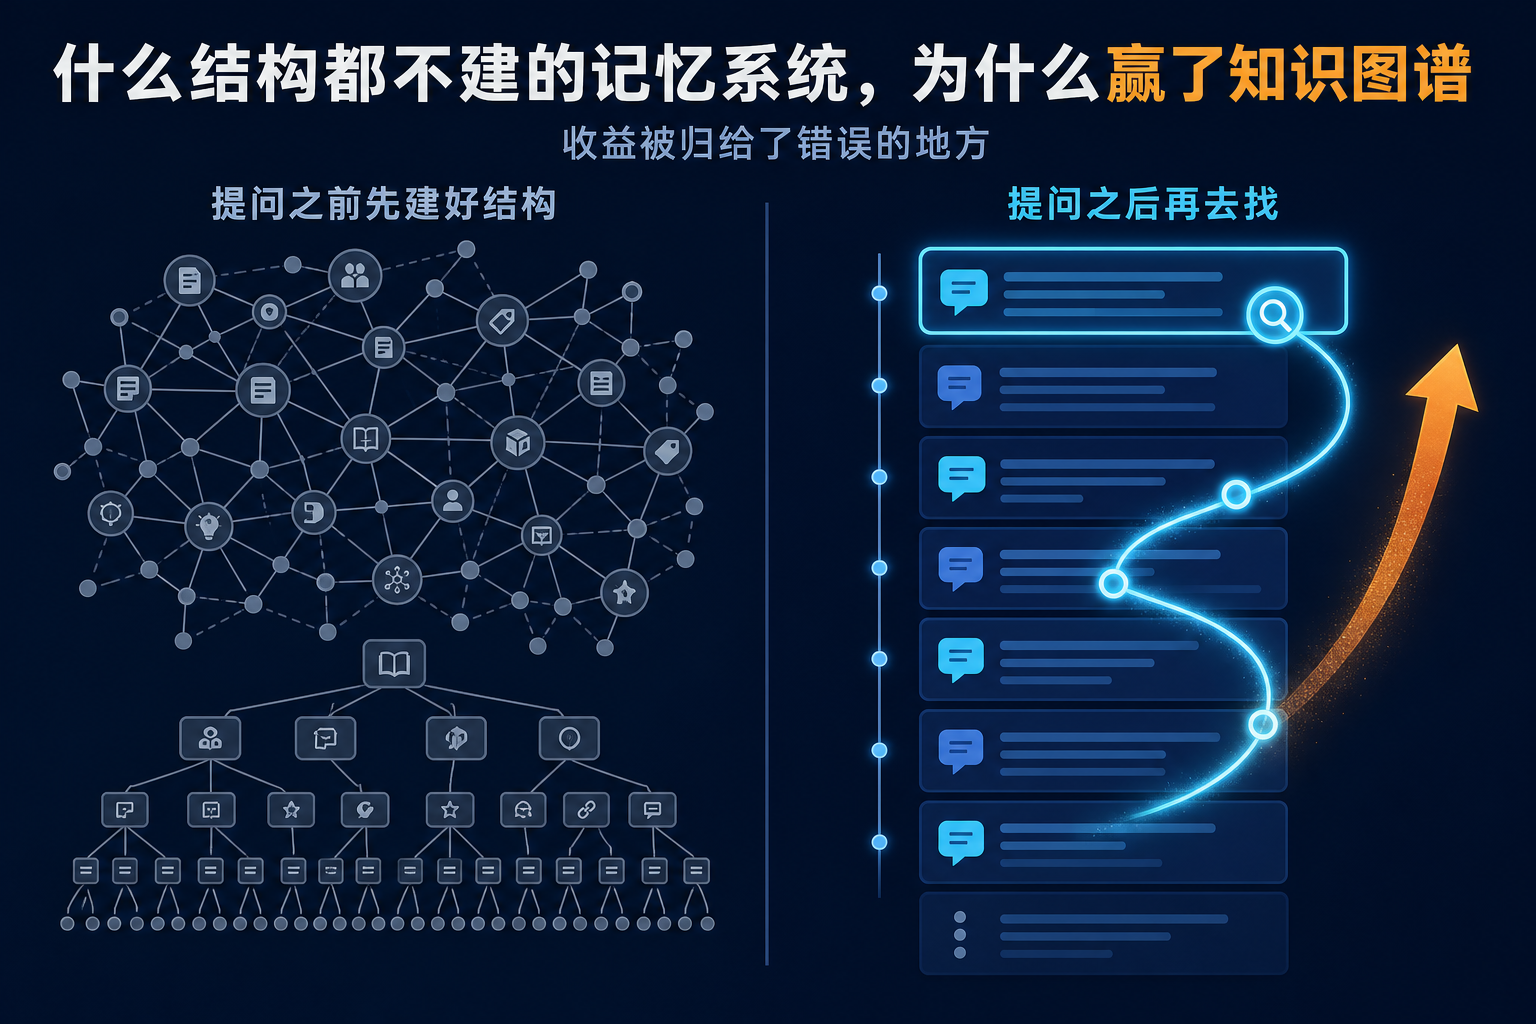
过去两年,agent 记忆系统的主流做法是往里加结构。
把聊天记录压成摘要,抽成实体,连成知识图谱,或者递归总结成一棵树,再写进向量库。这些工作全都发生在用户提问之前——系统必须先决定什么该保留、什么该丢掉、以什么形式保留。
8 月 16 日的一篇论文(arXiv:2608.12888)对这套做法提了一个很直接的问题:这些结构带来的收益,有多少真的来自结构本身,又有多少只是因为你终于有了一个能用的检索方式?
作者的验证方式是走到另一个极端——什么结构都不建,把聊天记录原样留着,只做一个词法索引,然后让 agent 自己多轮搜索。
结果它赢了。
这篇文章想说清楚的判断是:记忆系统的收益被记错了账。它大部分不来自提问之前建好的那个结构,而来自提问之后能不能可控地检索。 但这句话有个很容易被误读的地方,那也是全文最重要的部分——赢的并不是“用 BM25 就够了”。
一、结构化记忆的成绩表,比想象中难看
先看数字。评测用的是 MemoryAgentBench 的增量多轮设置,六个基准共约 2,800 道题,所有系统统一用 GPT-4o-mini 作为骨干模型。
六个基准分属两类能力:单跳问答、多跳问答、LongMemEval 和事件排序考的是精确检索,即从很长的历史里定位一个具体事实;单跳和多跳事实整合考的是事实更新追踪,即一个事实被后来的信息覆盖之后,能不能返回最新那一版。
下表按总平均排序,最后一列是与单轮 BM25 的差值——这条线是整节的参照物。
| 系统 | 类别 | 精确检索 (4 项均分) | 事实更新 (2 项均分) | 六项平均 | 相对 BM25 |
|---|---|---|---|---|---|
| ReFind | 无结构 + agent 控制 | 69.4 | 35.8 | 58.2 | +9.4 |
| HippoRAG 2 | 结构化记忆 | 65.1 | 29.5 | 53.2 | +4.4 |
| BM25-RAG | 单轮检索(基准线) | 60.5 | 25.5 | 48.8 | — |
| text-embedding-3-large | 单轮检索 | 54.6 | 16.0 | 41.7 | −7.1 |
| GPT-4o-mini | 长上下文,不检索 | 49.2 | 25.0 | 41.1 | −7.7 |
| MIRIX | Agentic 记忆 | 47.5 | 8.0 | 34.4 | −14.4 |
| GraphRAG | 结构化记忆 | 40.9 | 8.0 | 29.9 | −18.9 |
| MemGPT | Agentic 记忆 | 34.3 | 15.5 | 28.0 | −20.8 |
| MemoRAG | 结构化记忆 | 34.5 | 14.0 | 27.7 | −21.1 |
| RAPTOR | 结构化记忆 | 36.8 | 7.5 | 27.0 | −21.8 |
| Zep | 结构化记忆 | 37.5 | 5.0 | 26.6 | −22.2 |
| Mem0 | 结构化记忆 | 32.6 | 10.0 | 25.1 | −23.7 |
ReFind 领先最强的结构化系统 5 个点,这不算特别惊人。
真正难看的是基准线以下那一片。除 HippoRAG 2 之外,所有结构化记忆系统都输给了单轮 BM25,落后幅度在 19 到 24 分之间,而且全都输给了“什么都不建、直接把历史塞进长上下文”。 递归摘要树 RAPTOR、知识图谱 GraphRAG、记忆卡片 Mem0、时序图谱 Zep——这些系统在预处理阶段消耗了大量模型调用,成绩却只有直接检索原文的一半左右。
拆开两栏看,塌得更厉害的是右边那一栏。事实更新追踪上,长上下文这个不做任何处理的基线拿到 25.0,而六个结构化系统里只有 HippoRAG 2(29.5)超过它,其余全在 15 分以下,Zep 只有 5.0。也就是说,在“一个事实被改过之后返回最新版本”这件事上,先把历史加工成记忆表示,比原样留着还差。
原因论文说得很清楚:每一次预处理,都是在还不知道问题是什么的时候下的一个注。摘要决定丢掉哪些细节,实体抽取决定什么算实体,图谱决定哪些东西之间有关系。赌对了很省事,赌错了那个细节就再也找不回来了。 而精确检索类的问题,恰恰问的就是那些容易被判定为“不重要”的细节。
换一个更强的骨干模型,差距还会拉大。在 LongMemEval 的 S/M 两个子集上用 GPT-5-mini 重跑,ReFind 拿到 93.2 和 89.3,而 GraphRAG 是 84.0 和 66.7,HippoRAG 2 是 80.0 和 66.7。在更长的 M 子集上,图结构系统落后了二十多分。
二、“不建结构”到底是什么意思
需要先把这个说法界定清楚,否则容易理解成“回到最原始的关键词搜索”。
ReFind 用了聊天记录里本来就有的组织方式:轮次边界、会话标识、时间戳、原始文本。它在轮次粒度上建了一个 BM25 倒排索引。这个索引不需要任何模型调用,新消息写进来就立刻可搜,不用重建也不用增量维护。
它没做的是:不写摘要,不抽实体,不连图,不生成记忆卡片,不做任何由大模型生成的记忆表示。
区别不在于有没有索引,而在于什么时候决定“怎么表示这段历史”。 结构化系统在看到问题之前就把这个决定做完了;ReFind 把它推迟到查询时,那时 agent 已经知道自己要找什么。
具体运行方式是两段式。第一段检索,一个 ReAct 循环让模型自己决定搜什么词、限定什么时间范围,最多四轮,把有用的片段存成笔记;第二段推理,把笔记按会话分组、按时间排序,交给模型作答。
检索工具本身带四个针对对话结构设计的控制:
- 上下文窗口扩展:命中一轮后,连带返回前后各两轮,因为代词和省略的含义往往在邻近轮次里;
- 会话级重排融合:同一个会话里多轮命中,说明整个会话很可能相关,用 RRF 把轮次排名和会话聚合排名融在一起;
- 时间过滤:问题里出现“上个月”这类线索时,agent 可以自己给出日期范围;
- 已看会话去重:之前返回过的会话不再返回,避免在有限的轮次预算里反复读同一段。
这四个控制是这套系统真正的工程内容,下一节会看到它们的分量。
三、赢的不是 BM25
这是全文最容易被跳过、但对工程决策最关键的一节。
如果结论是“结构没用,换成 BM25 就行”,那么把 ReFind 的四个对话控制去掉、只保留多轮搜索循环,成绩应该不会怎么变。论文做了这个对照,结果不是这样。
| 变体 | LongMemEval-S | LongMemEval-M |
|---|---|---|
| 完整方法 | 93.2 | 89.3 |
| 只保留多轮循环,去掉四个对话控制 | 78.7(−14.5) | 82.2(−7.1) |
| 保留四个对话控制,但只搜一次 | 84.7(−8.5) | 68.9(−20.4) |
| 去掉上下文窗口扩展 | 84.0(−9.2) | 84.4(−4.9) |
| 去掉已看会话去重 | 92.0(−1.2) | 80.0(−9.3) |
| 去掉会话级重排融合 | 89.3(−3.9) | 84.4(−4.9) |
| 去掉时间过滤 | 91.3(−1.9) | 84.4(−4.9) |
两行对照分别排除了两个偷懒的解释。
去掉四个对话控制、只留多轮循环,掉 14.5 分,说明“让 agent 反复搜”这件事本身不足以解释成绩。保留四个控制但只搜一次,在长历史的 M 子集上掉 20.4 分,说明一个写得好的首次查询也不够——必须能看到返回结果之后再调整。
收益来自这两者的交互:多轮控制,加上一个懂对话结构的检索接口。缺任何一半都掉分。
还有第三个对照排除了“是不是换个更好的检索后端就行”。在 agent、提示词、预算全部固定的前提下只换后端,BM25 拿到 93.2 / 89.3,稠密向量 91.3 / 82.2,四路混合 91.3 / 86.7——加语义信号并没有提升。论文的解释是,语义适配这件事已经由 agent 的查询改写完成了,检索层因此可以保持精确、可解释、可增量维护。
所以准确的说法不是“记忆工程白做了”,而是:
工程量没有白花,是花错了时间点。花在“提问之前构建语义结构”上的那部分大多打了水漂,花在“提问之后可控检索”上的那部分才是有效的。
四、算力没有消失,只是换了花的时间点
这套方案的代价也应该讲清楚,因为它不是免费的。
ReFind 的索引构建接近零成本,但每次提问要花钱:平均 2.5 到 2.6 次搜索、约 5 次模型调用、每道题 7 万到 10 万 token。作为对比,同样的问题走单轮检索只要约 1 万 token。单次查询的开销大约是七到十倍。
预建结构则是反过来。论文引用了 GraphRAG 原文的一组数字:在一个约 100 万 token 的语料上,它抽出 8,564 个实体和 20,691 条关系,在回答任何一个问题之前,先消耗了 281 分钟的 GPT-4-turbo 时间。
两种花法的差别不在总量,在于算力是绑定在归档更新上,还是绑定在真实提问上。
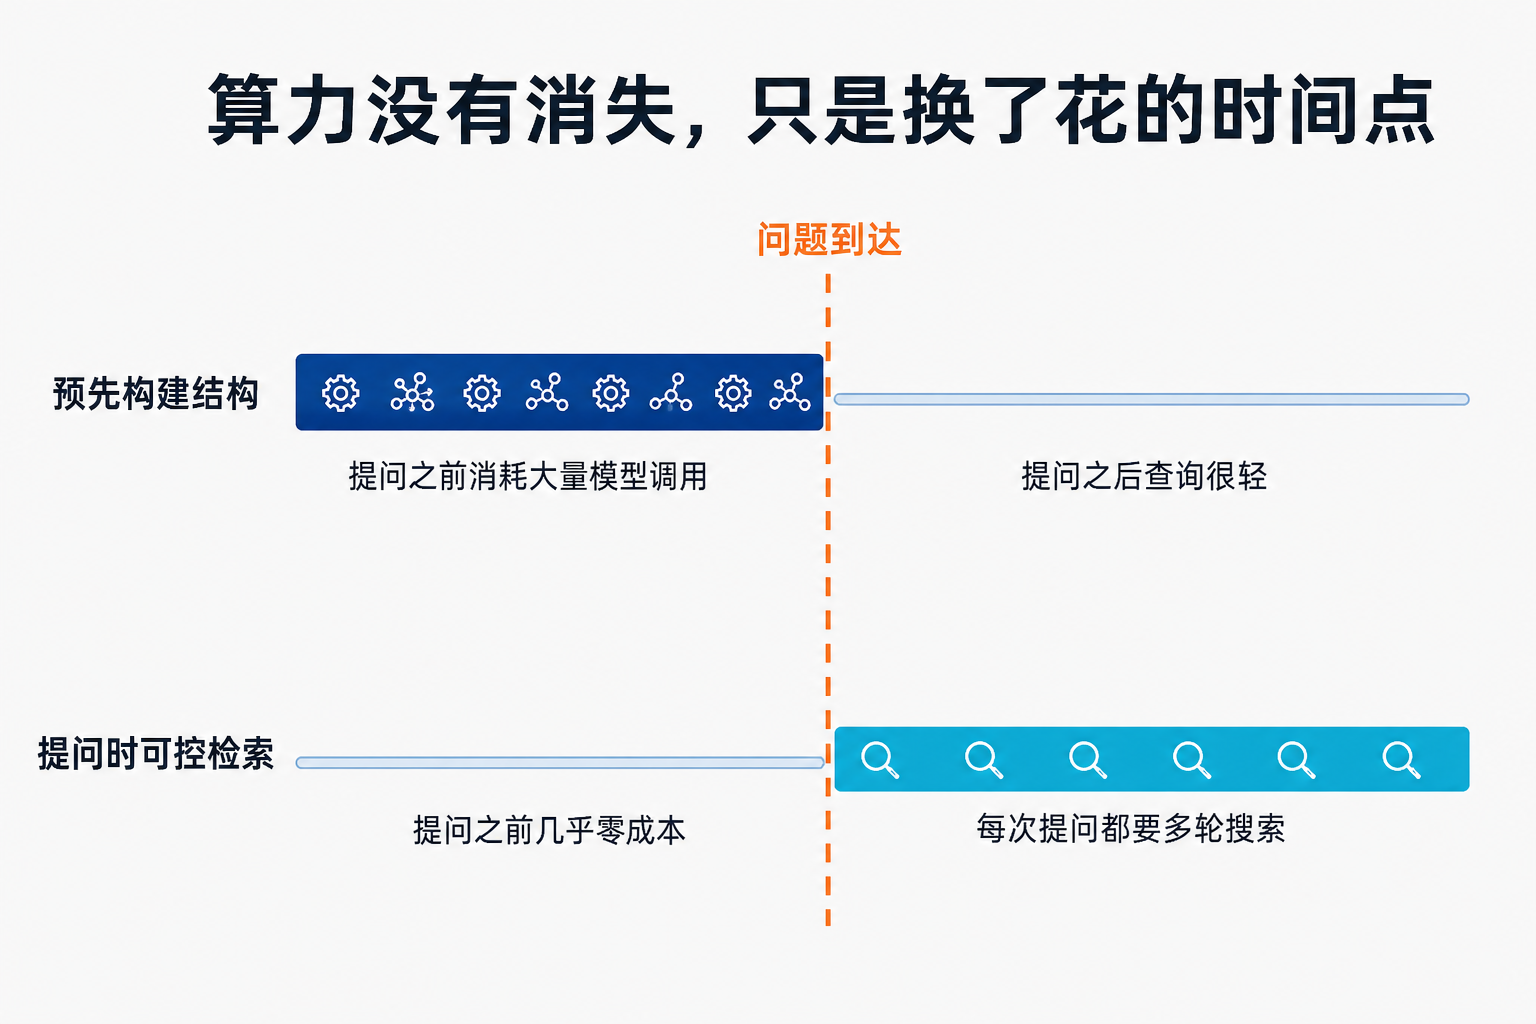
如果你的历史库一直在增长而查询稀疏,预建结构的成本会随着数据量线性增长,其中大部分永远不会被用到;如果查询密集而历史相对稳定,预建索引摊薄得很快,反而是每问 10 万 token 更贵。
这不是一个“哪个更好”的问题,而是一个需要按自己的读写比算一遍的问题。顺带一提,原始记录保留完整还有一个不体现在分数里的好处:答案可以对照逐字原文核验,而不是对照一个已经被模型改写过的记忆状态。
五、同一个归因错误,第二次出现
八月初写过《DeepSWE 从 7.3 到 54.4:这 7 倍里,有多少是模型的》,讲的是 agent 跑分归因:一个分数由“模型 + 运行时”共同产生,榜单却只署模型的名字。受控实验显示,换 harness 造成的分数波动是换模型的 7.80 倍。
这篇论文问的是同一类问题,连提问方式都几乎一样——这些收益里,有多少是结构的?
两次的答案也是同构的:收益被记在了更显眼、更像“内容”的那个组件上(模型、语义结构),而实际起作用的是更工程化、更不起眼的那个(运行时、检索接口)。
由此得到的工程建议也是同一条:先把不起眼的那一半做对,再考虑换显眼的那一半。 agent 效果不好先查运行时;记忆系统效果不好先查检索接口,而不是急着上知识图谱。
边界
这篇论文的适用范围,作者自己划得比较清楚,不宜外推。
它验证的是精确检索和事实更新追踪——从长历史里定位一个具体事实,或者在一个事实被多次覆盖后返回最新版本。对于需要语义抽象的任务(比如“总结这个用户半年来的性格变化”),以及对延迟敏感、不能容忍每问五次模型调用的场景,论文明确说结构化记忆仍然是互补的。
几个数据上的保留也值得注意:LongMemEval-M 子集只有 15 道题,一个判定翻转就是 6.7 个百分点;表里的基线成绩多数是从其他论文复用的,并没有全部在统一的控制器和工具调用预算下重跑;自动评判也没有做人类一致性检验。
还有一个所有系统共同的坏消息:多跳事实整合这一项,全场最高分是 ReFind 的 8.8。在“多个事实互相覆盖、需要交叉推理出当前状态”这类任务上,现有记忆系统基本都不工作。 这跟建不建结构无关。
结论
结构化记忆不是没有价值,但它的价值被记在了错误的账上。
行业默认的因果是“因为建了图谱/树/摘要,所以检索效果好”。ReFind 的对照实验把这个因果拆开了:同一批题目上,什么结构都不建,只要检索接口懂对话的组织方式、并且允许 agent 看到结果后再调整,成绩反而更高。而多数结构化系统连单轮 BM25 都没打过。
更值得记住的是它的反面。去掉四个对话控制掉 14.5 分,只搜一次掉 20.4 分——这套方案的成绩不是“因为简单所以赢”,而是把工程量从提问之前挪到了提问之后。
一个系统的收益由两个组件共同产生时,功劳总是记给看起来在生产内容的那一个,而不是记给决定内容怎么被找到、怎么被使用的那一个。后者不起眼,但成绩常常由它决定。
参考资料
- Ruizhe Li、Licheng Zhang、Benfeng Xu、Mingxuan Du、Zheren Fu、Weidong Chen(中国科学技术大学 / MetaStone Technology),《When Your Agent Opens the Chat App: Agent-Controlled Search over Raw Chat Logs Rivals Structured Memory》,arXiv:2608.12888,2026 年 8 月 16 日。https://arxiv.org/abs/2608.12888
- Yuanzhe Hu、Yu Wang、Julian McAuley,《Evaluating Memory in LLM Agents via Incremental Multi-Turn Interactions》(MemoryAgentBench),arXiv:2507.05257。https://arxiv.org/abs/2507.05257
- Di Wu 等,《LongMemEval: Benchmarking Chat Assistants on Long-Term Interactive Memory》,arXiv:2410.10813。https://arxiv.org/abs/2410.10813
- Darren Edge 等,《From Local to Global: A GraphRAG Approach to Query-Focused Summarization》,arXiv:2404.16130。https://arxiv.org/abs/2404.16130
- Bernal Jiménez Gutiérrez 等,《From RAG to Memory: Non-Parametric Continual Learning for Large Language Models》(HippoRAG 2),arXiv:2502.14802。https://arxiv.org/abs/2502.14802
- Pengyu Wang 等,《BM25 Wins at Scale: A Scaling Study of Retrieval-Augmented Generation Paradigms》,arXiv:2607.26497。https://arxiv.org/abs/2607.26497
- ICE 数字实验室,《DeepSWE 从 7.3 到 54.4:这 7 倍里,有多少是模型的》,2026 年 8 月 2 日。
本文部分内容由 AI 辅助生成,经人工审校和补充后发布。