索引重建后,80% 的查询证据集发生变化:Agent 检索的可复现性问题
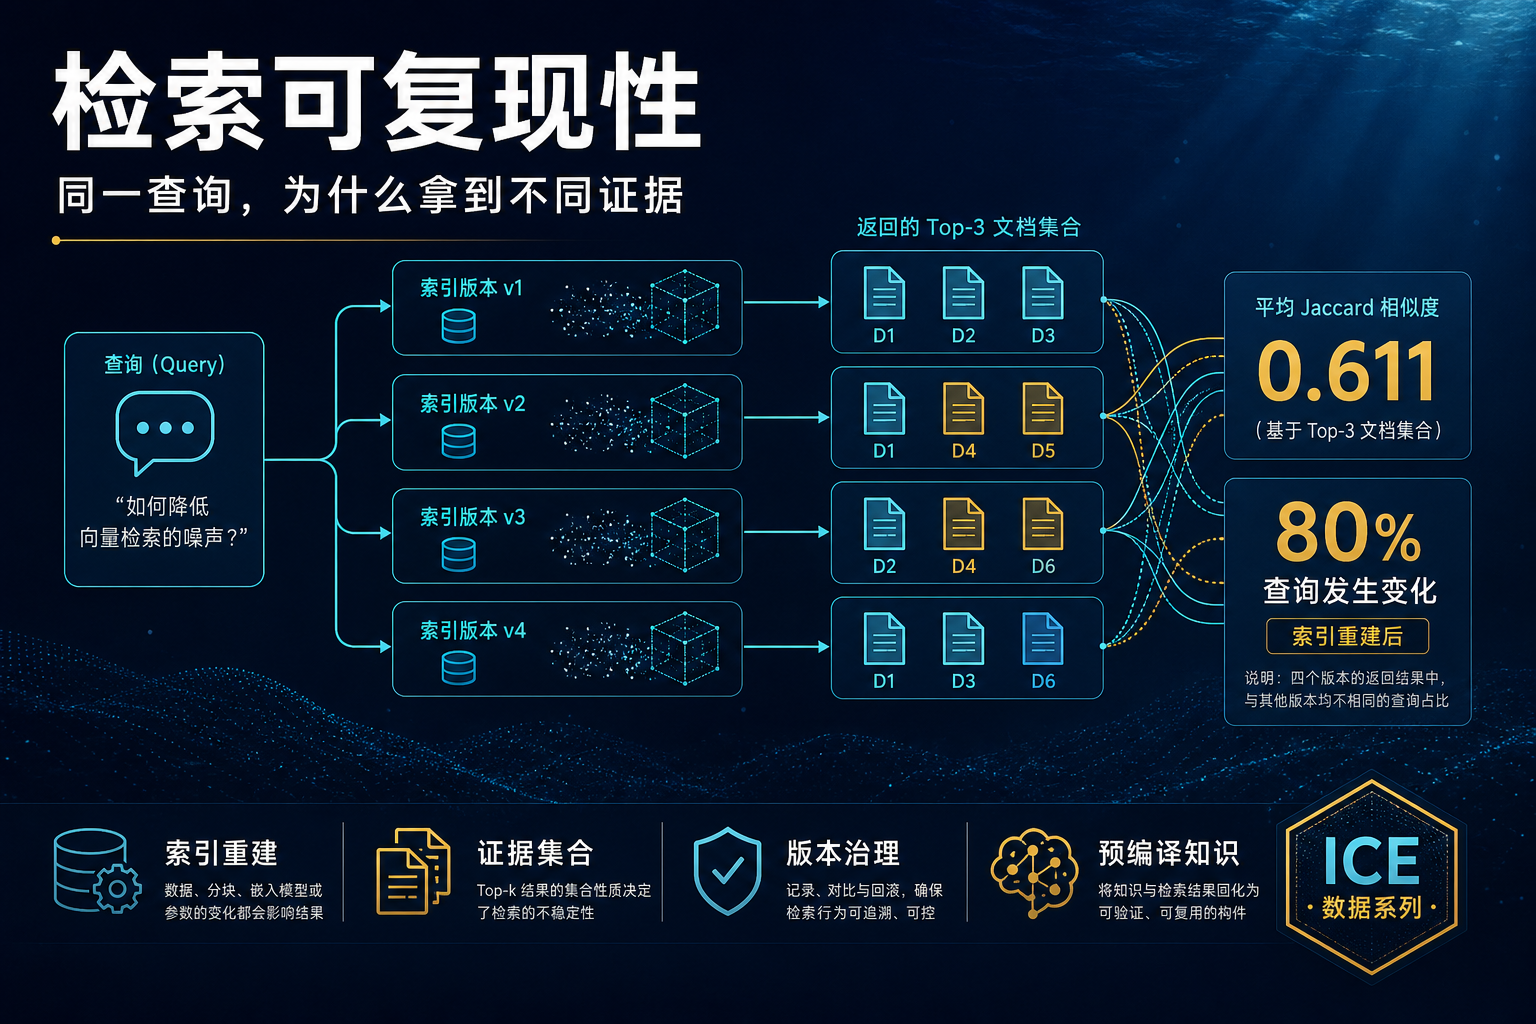
同一个问题重复查询,Agent 获得的证据是否相同?
ContextNest 论文 v2 用 1060 篇合成文档、50 个查询和三种检索方式测试了这个问题。确定性选择器和 BM25 的结果集合保持不变;dense embedding 加 HNSW 的方案中,40 个查询的 top-3 文档集合发生变化,占 80%,平均 Jaccard 为 0.611,最差 0.210。
这个数字需要附带实验条件:研究者不是在同一个冻结索引上连续查询 20 次,而是每 5 次重建一次 HNSW 索引,改变文档插入顺序,再在多个索引版本间轮换。它测量的是索引重建后的部署级可复现性,不能写成“向量数据库每次查询都会随机返回不同结果”。
同一周,Pinecone Nexus 在 8 月 6 日正式上线。它把一部分知识组织工作从查询时前移到预编译阶段:先依据 Manifest 生成带类型、来源和关系的 Artifacts,查询时再通过 KnowQL 返回结构化答案与字段级引用。
两项材料指向的是同一个工程问题:Agent 不只需要找到相关内容,还需要知道使用的是哪一版证据、结果能否复现,以及事故发生后能否还原当时读取了什么。
一、ContextNest 实验到底测了什么
ContextNest 是一份面向 Agent 知识库治理的开放规范与参考实现。它在检索之下增加版本、来源、完整性和审计信息,让系统能够判断哪些文档在某个时间点有资格被 Agent 使用。
论文的可复现性实验使用以下协议:
| 项目 | 设置 |
|---|---|
| 文档规模 | 10 类模板 × 106 个服务,共 1060 篇 |
| 查询数量 | 50 个 |
| 每种方法重复次数 | 每个查询 20 次 |
| 结果集合 | top-3 文档 |
| 稳定性指标 | 20 次结果的平均两两 Jaccard |
| dense 模型 | bge-small-en-v1.5 |
| 向量索引 | FAISS HNSW,M=16,efConstruction=40,efSearch=4 |
| 索引变化 | 每 5 次重建,改变插入顺序 |
Jaccard 衡量两个集合有多少重合。top-3 结果完全一致时是 1.0;完全不重合时是 0。
实验结果如下:
| 检索方式 | 平均 Jaccard | 最低 Jaccard | 完全稳定查询 |
|---|---|---|---|
| 确定性 selector | 1.000 | 1.000 | 50/50 |
| BM25 | 1.000 | 1.000 | 50/50 |
| dense + HNSW | 0.611 | 0.210 | 10/50 |
这里的 selector 不是模型检索。它根据文档预先标注的类型、标签和版本状态,用确定性集合运算筛选文档。BM25 在相同语料和参数下也产生了稳定结果。
HNSW 是近似最近邻索引。它通过图结构减少搜索成本,建图过程会受插入顺序影响。独立研究同样发现,改变 HNSW 插入顺序可以带来最高约 12.8 个百分点的 recall 差异,并可能改变 embedding 模型的排行榜顺序。
因此,这项实验支持的结论是:相同语料、查询和参数,在 HNSW 重建及插入顺序变化后,不一定恢复出相同的 top-k 证据集合。
它没有证明固定索引内的查询本身具有随机性,也没有比较不同方案的相关性和答案准确率。
二、稳定不等于正确
检索系统常把几个不同指标混在一起。ContextNest 的实验主要测第一个:
| 指标 | 具体问题 |
|---|---|
| 检索稳定性 | 同一索引和条件下,重复查询是否返回同一集合 |
| 部署可复现性 | 索引重建、分片或环境变化后,能否恢复同一集合 |
| 相关性 | 返回文档是否与问题有关 |
| 完整性 | 回答所需证据是否全部被取回 |
| 版本资格 | 文档是否为当前、获批、权限允许的版本 |
| 答案稳定性 | 证据相同后,生成模型是否给出一致答案 |
确定性 selector 可以稳定地选错;BM25 可以每次返回同一组文档,却漏掉语义相关内容;dense retrieval 的 top-3 可以变化,但正确文档始终包含在结果中。
因此,Jaccard 1.0 只表示结果集合一致,不表示答案正确。Jaccard 0.611 也不直接等于 38.9% 的准确率损失。
对生产 Agent 来说,可复现性主要影响评测、回归测试和审计。如果同一个版本在索引重建后使用了不同证据,系统分数变化时就难以区分是模型变化、检索变化还是数据版本变化。
三、旧版本实验测量了什么
论文还构造了一组 stale-version attack,用来测试旧文档混入检索结果后的影响。
实验为 6 篇当前文档各加入一个归档旧版本。每个旧版本包含 5 项与当前版本冲突的事实,共生成 30 个查询。回答模型使用 Claude Sonnet 4.6,评审使用 Claude Opus 4.7。
| 方法 | 可访问的版本 | 平均输入 Token | 通过率 |
|---|---|---|---|
| 确定性 selector | 只选当前且获批版本 | 215 | 97% |
| BM25 leaky | 当前版本 + 旧版本 | 655 | 93% |
| BM25 clean | 只含当前版本 | 725 | 90% |
selector 的平均输入量约为两个 BM25 方案的三分之一。但这组数据不能全部归因于“版本治理”。
selector 同时获得了两项优势:它排除了旧版本,也通过人工结构化标签直接定位文档。BM25 clean 本身不含旧版本,失败主要来自检索遗漏。因此,97% 对 90% 同时反映了版本筛选和结构化定位,不能视为通用 RAG 排行榜。
论文也列出了限制:语料为合成数据;查询被刻意设计为新旧版本冲突;只比较 sparse retrieval;评审依赖单一 LLM judge,没有人类校准。
四、Pinecone Nexus 把知识组织前移
Pinecone Nexus 选择了另一条路线。传统 RAG 通常在每次查询时完成切分召回、阅读、再次检索和答案综合;Nexus 在查询前增加 Context Compiler,根据 Manifest 把原始文档编译成可复用的 Artifacts。
Artifact 包含:
- type 与 kind:知识对象的类型;
- scope:适用范围;
- provenance:指向原始文档片段的来源;
- typed edges:与其他 Artifact 的有向关系。
跨文档 Artifacts 和关系边可以构成知识图。查询端使用 KnowQL,提交 scope、ask 和可选的输出 shape,获得结构化答案与字段级引用。
这改变了查询时的工作分配。计数、枚举、实体关系和跨文档汇总可以优先读取已生成的 Artifact,不必每次从原始 chunks 重新组织全部上下文。
但 Nexus 仍然保留检索:
- 源文档继续被切分和 embedding;
- 底层继续使用 Pinecone 向量索引;
- 文档层保留语义搜索与关键词搜索;
- 一个 KnowQL 请求内部可以执行多轮搜索、SQL、图遍历和答案综合。
因此,Pinecone 将 Nexus 描述为“Not RAG”属于产品类别定义。按技术流程,它更接近预编译知识层加 Agentic Retrieval Runtime,并没有取消 retrieval-augmented generation。
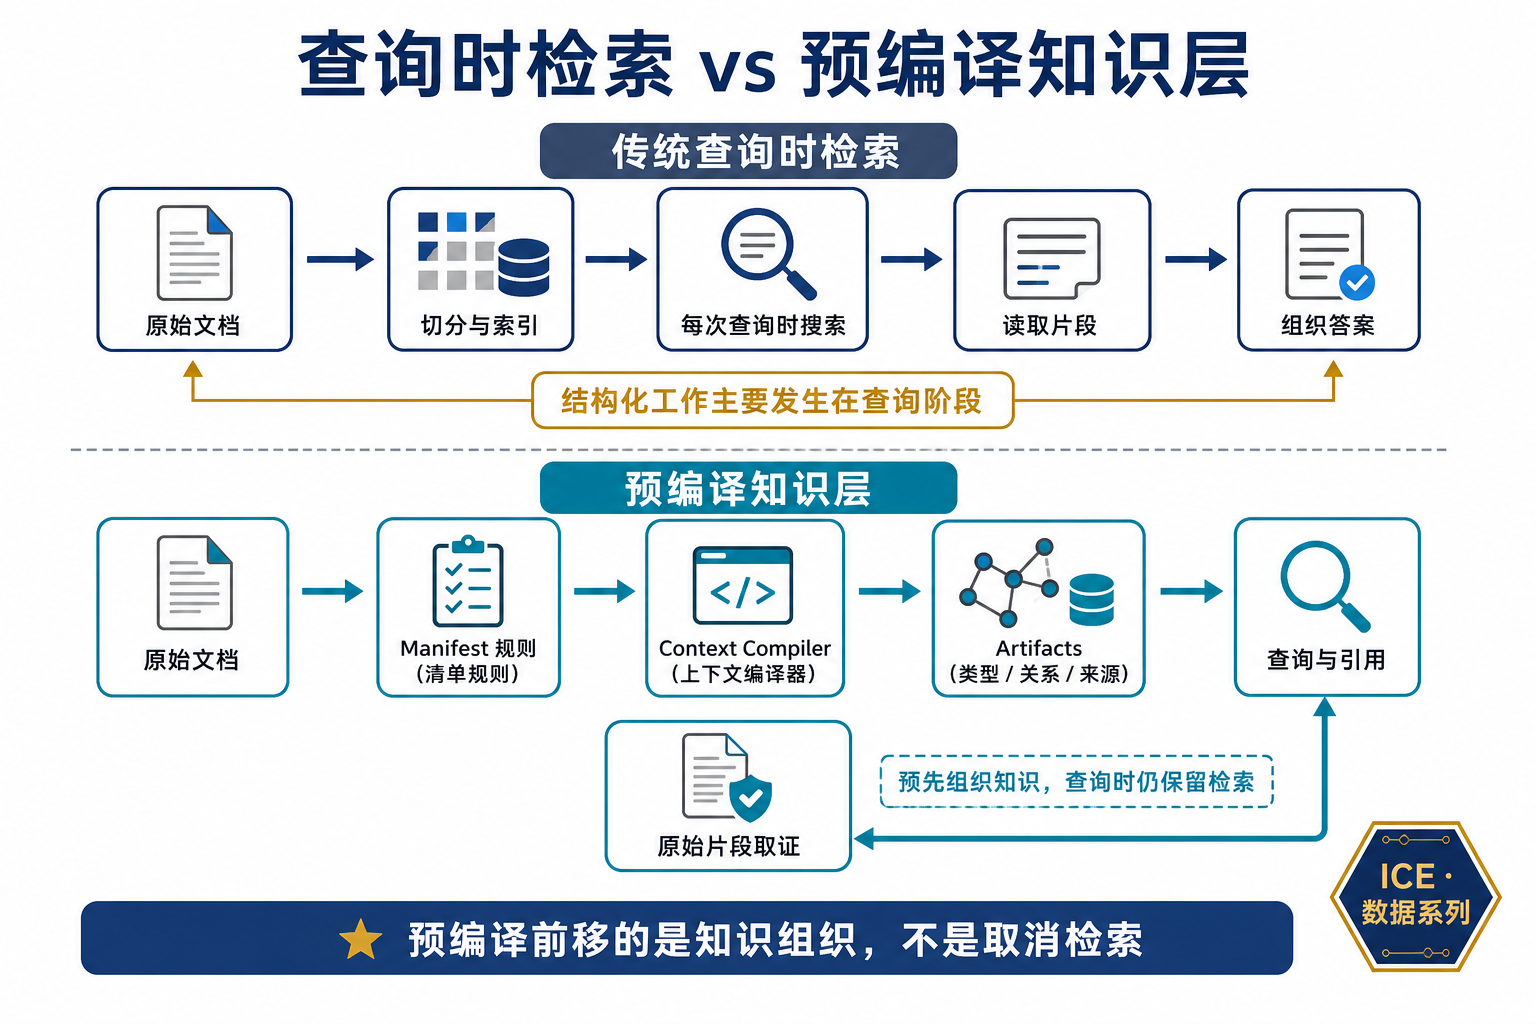
图 1:预编译知识层把部分结构化工作移到查询之前,但查询时仍保留检索和答案综合。
五、官方性能数字需要分开看
Pinecone 的 GA 公告给出三个产品级数字:Token 成本降低 90% 以上、最快 30 倍、任务准确率超过 90%。公开材料中的具体评测并没有在同一个实验里同时复现这三项结果。
KRAFTBench 使用 150 道 10-K 问题比较 Nexus 和 Agentic RAG:
| 指标 | Nexus | Agentic RAG |
|---|---|---|
| Completion | 100% | 98.7% |
| Accuracy | 68.0% | 41.3% |
| 平均耗时 | 22.7 秒 | 37.9 秒 |
| 平均 Token | 6733 | 49103 |
该组数据对应约 86% Token 降幅和 1.67 倍速度提升。
GA 公告给出的另一组 τ-Knowledge 数据中,GPT-5.5 + Nexus 的通过率为 47.4%,GPT-5.5 基线为 46.4%,每任务成本降低 74%。
因此,90%+、30 倍和 90%+ 准确率来自不同客户、任务或评测汇总,不能把它们合并成一套统一实验结果。目前的公开数字均由厂商发布,还没有独立复现。
六、语义层是知识治理的一项输入
8 月 7 日,Fivetran 与 dbt Labs 发布的文章把 context engineering 拆成四部分:语义与来源、质量与状态、治理与生命周期、发现与交付。
其中两项工作与文档检索形成互补:
- Apache Ossie 用 JSON/YAML 交换指标、维度、实体和关系定义,降低语义定义被单一工具锁定的风险;
- Agents Schema 在 warehouse 或 lake 中用固定 SQL schema 发布模型、指标、lineage、owner 和 freshness 等信息。
它们解决的是业务语义、数据状态和发现接口的标准化,不直接解决 HNSW 重建后的结果可复现性,也不负责像 Nexus 一样生成面向任务的跨文档 Artifacts。
这与语义层文章的区别也在这里:语义层回答“营收、客户、订单在企业里如何定义”;检索治理回答“Agent 当时读到了哪份证据、该证据是否当前、同一环境能否复现”。
结论
现有材料支持以下几项结论:
- ContextNest 报告的 80% 不稳定发生在 HNSW 索引重建并改变插入顺序的条件下,不是固定索引内每次查询随机变化。
- 确定性、相关性、版本资格和答案稳定性是不同指标;稳定结果不一定正确。
- 旧版本实验中,selector 的 97% 通过率同时受益于版本筛选与结构化定位,不能全部归因于治理机制。
- Pinecone Nexus 把部分知识组织前移到编译阶段,但查询运行时仍使用向量检索、关键词检索和多轮 Agent 操作。
- Pinecone 公布的 90%+ Token 降幅、30 倍速度和 90%+ 准确率不是来自同一套公开实验,独立复现仍然缺失。
对于 Agent 知识系统,证据是否相关只是一个维度。证据集合能否复现、版本是否有效、来源能否追溯,已经成为独立的工程指标。
参考资料
- ContextNest 项目,《ContextNest: Verifiable Context Governance for Autonomous AI Agents》,arXiv:2607.02116v2,2026 年 7 月。https://arxiv.org/html/2607.02116v2
- Pinecone,《General availability of Pinecone Nexus proves knowledge drives real outcomes for agentic AI》,2026 年 8 月 6 日。https://www.pinecone.io/newsroom/general-availability-of-pinecone-nexus-proves-knowledge-drives-real-outcomes-for-agentic-ai/
- Pinecone,《Context design: Manifest, information stack, artifacts and edges》。https://docs.pinecone.io/guides/nexus/context-design
- Pinecone,《How Nexus queries work》。https://docs.pinecone.io/guides/nexus/how-queries-work
- Fivetran,《Open Data Infrastructure needs context engineering to unify data use cases》,2026 年 8 月 7 日。https://www.fivetran.com/blog/open-data-infrastructure-needs-context-engineering-to-unify-data-use-cases
- Elliott Coleman 等,《The Impact of Data Ordering on HNSW Recall》,arXiv:2405.17813v1。https://arxiv.org/html/2405.17813v1
本文部分内容由 AI 辅助生成,经人工审校和补充后发布。