批量向量检索,不是一百万次请求,而是一次 Join
假设你手上有两张表:一张是一亿笔交易,一张是一亿四千万个商户,两张表都已经有嵌入列。任务是给每笔交易找出最像的 5 个商户,用来做实体解析。
过去的做法通常是这样:把商户嵌入导出,写进一套专门的向量库;再写一个脚本,把交易一行一行发过去查询;然后处理限流、超时和重试,跑上一整夜。商户表一更新,还要重新同步一次。
2026 年 10 月 5 日,Databricks 公开了另一种做法。同样的任务,现在可以写成一条 SQL:
SELECT q.txn_id, t.merchant_id
FROM transactions q
INNER JOIN merchants t
  APPROX NEAREST 5 BY SIMILARITY
  vector_cosine_similarity(q.embedding, t.embedding);
这就是 NEAREST BY:对左表的每一行,按相似度或距离在右表里找出最近的 k 行。它背后的判断很简单——批量向量检索不是一百万次小搜索,而是一次 Join。
这个判断沿着三层向下展开:在 SQL 层,把“每行取最近的 k 条”定义成一种连接;在执行层,把逐对打分改造成可以复用数据的矩阵计算;在存储层,把近似索引做成一张按簇排列的普通表。三层解决的是同一个问题:既然数据已经在湖仓里,为什么还要把它复制出去,交给另一套系统逐条查询?
批量检索本来就是一次 Join
向量检索最熟悉的形态是在线查询:聊天机器人或搜索框收到一条输入,系统要在几十毫秒内返回最相似的几条文档。专用向量库围绕这个场景优化,追求的是单次查询延迟。
但实体解析、去重、语义打标、批量推荐刷新不是在线查询。它们通常按日程运行:几百万甚至上亿条查询,对几百万到几十亿条向量。衡量标准也不是某一次查询用了多少毫秒,而是整批作业能否在时限内、以合理成本跑完。
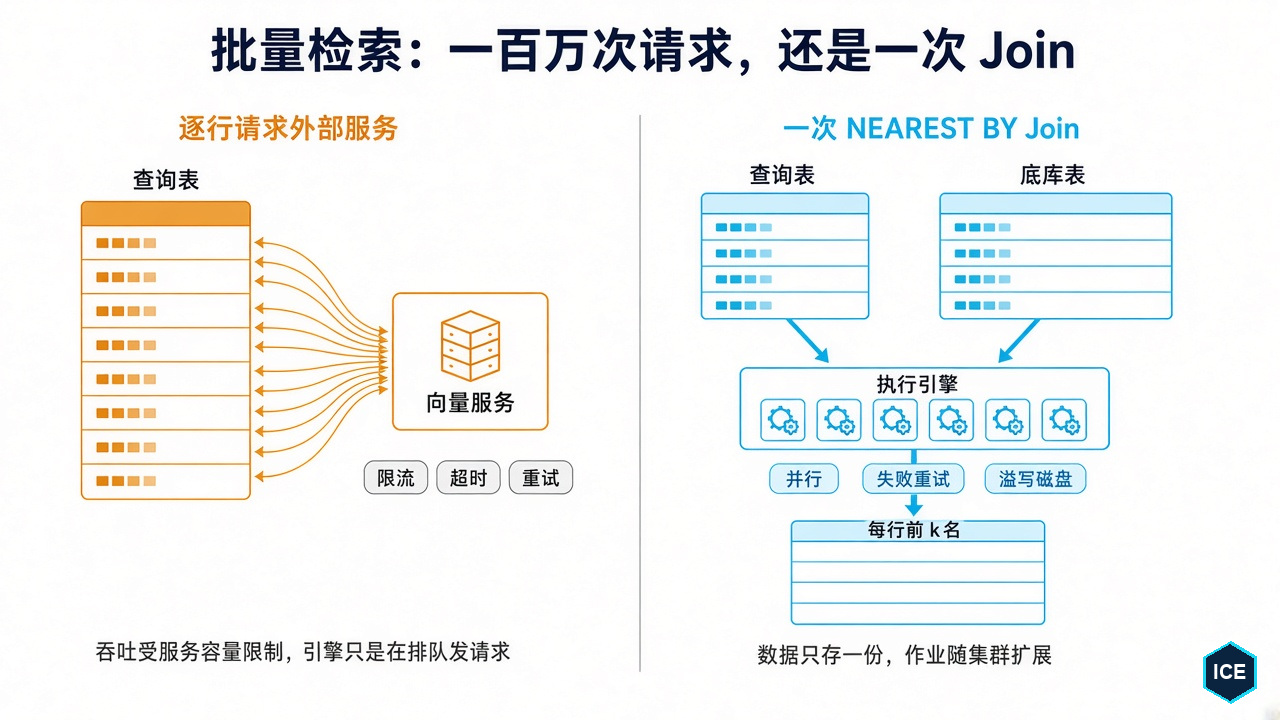
Databricks 的第一版 VECTOR_SEARCH 函数却仍然沿用在线服务的思路:查询表每读一行,就向外部向量检索服务发一次请求。这样能完成任务,却把批处理拆成了一串远程调用。
直接后果是,吞吐受外部服务容量限制。运行作业的集群再大,也只是更快地排队发请求,计算引擎退化成了调度器。
更根本的问题是,它看错了查询的形状。一百万条查询并不是一百万个互不相关的小任务,而是一次两表操作:左表每一行,在右表中取最接近的 k 行。这在关系代数里就是一次 Top-K 排名连接(top-k ranking join)。
一旦按 Join 表达,任务就能回到数据所在的引擎:嵌入只保存在原表里,不需要第二套向量库和同步管道;作业也自然继承分布式并行、任务重试和磁盘溢写。这些能力很难靠一个在线服务外加客户端脚本补齐。
一条语法,也是一份结果合同
认出查询形状之后,下一步是把它稳定地表达出来。其他系统也能做向量检索,但接口往往把“这是一次 Join”的结构藏了起来。
Postgres 配合 pgvector、Snowflake 的常见写法是 ORDER BY 距离 LIMIT k。单条查询没问题,批量时就要给每一行再套一层 LATERAL 子查询。优化器要从这种写法里猜出“这是最近邻检索”,猜不准时快路径就会悄悄失效。BigQuery 用表值函数,批量是一等能力,但列名以字符串传入,解析器无法提前校验。
NEAREST BY 直接把结构写进语法:
- 左表驱动,右表被检索。 每条查询行最多返回 k 行匹配,k 默认是 1,最大到 100,000。
- 排序方向写明。
BY SIMILARITY取值越大越近,BY DISTANCE取值越小越近。 - 可以保留无匹配行。
LEFT OUTER JOIN会保留找不到候选的查询行,右侧列填 NULL。 - 打分表达式可替换。 只要是同时引用两边列、可排序的标量表达式都可以,目前内置内积、余弦相似度和 L2 距离。
最值得注意的是 EXACT 和 APPROX。EXACT 保证返回真正的前 k 名;APPROX 才允许优化器使用近似索引等更快的方法。这意味着,索引是否存在,不会悄悄改变精确查询的语义。只有明确写下 APPROX,查询才授权优化器用近似结果换取速度。
这个子句也已经出现在 Apache Spark 4.2 的 JOIN 文档中,只支持 INNER 和 LEFT OUTER。不过,定义一种语义不等于已经有了高效实现。文档中的开源实现仍走交叉连接加有界 Top-K 的路径;Databricks 运行时又向下做了融合算子和近似索引。
慢的不是计算,而是反复搬运
先看不使用近似索引的精确路径。优化器可以把 NEAREST BY 改写成三个普通关系操作:
- 给每条查询行生成一个 id;
- 对每一对“查询 × 底库”计算相似度或距离;
- 按查询 id 分组,只保留每组前 k 名。
第三步不需要把每组结果完整排序。max_by / min_by 增加 K 参数后,每组只维护一个大小为 k 的堆:新分数和堆顶比较一次,就知道该留下还是丢掉。无论底库有十万行还是十亿行,每条查询都只占用 k 个位置。各分区先产出局部前 k 名,再合并这些短名单;全局前 k 名一定包含在局部前 k 名的并集中,所以结果仍然精确。
这套改写解决了“如何正确执行”,却没有解决“如何高效执行”。大批量下,瓶颈不在乘加本身,而在数据的使用方式。
朴素计划每次读取一条底库向量和一条查询向量,算出一个分数,然后处理下一对。相同的向量会被反复从内存读取,CPU 大部分时间都在等数据,而不是做乘加。Databricks 用屋顶线模型(roofline model)量化了这一点:每从内存读 1 字节,只能做 0.25 次浮点运算;在参考机器上,大约只能用到 CPU 峰值算力的 0.8%。
这不是计算量太少,而是没有复用。假设一百万条查询匹配十亿条底库,虽然要产生 10¹⁵ 个分数,不同的输入向量却只有一百万加十亿条。每条底库向量都要和大量查询比较,没有必要每比较一次就重新读取一次。
融合算子(fused operator)正是用空间换复用:把较小的一侧缓存在内存中,让另一侧分批流过,再用分块矩阵乘法(GEMM)一次计算一整块“查询 × 底库”的分数。一条底库向量读进来后,会先和缓存中的整批查询完成比较,然后才被替换。
于是,查询批次越大,同一份数据被复用的次数越多。参考机器上,批次达到 64 条时,瓶颈就从内存带宽转向 CPU 算力;生产批处理通常远大于这个规模。
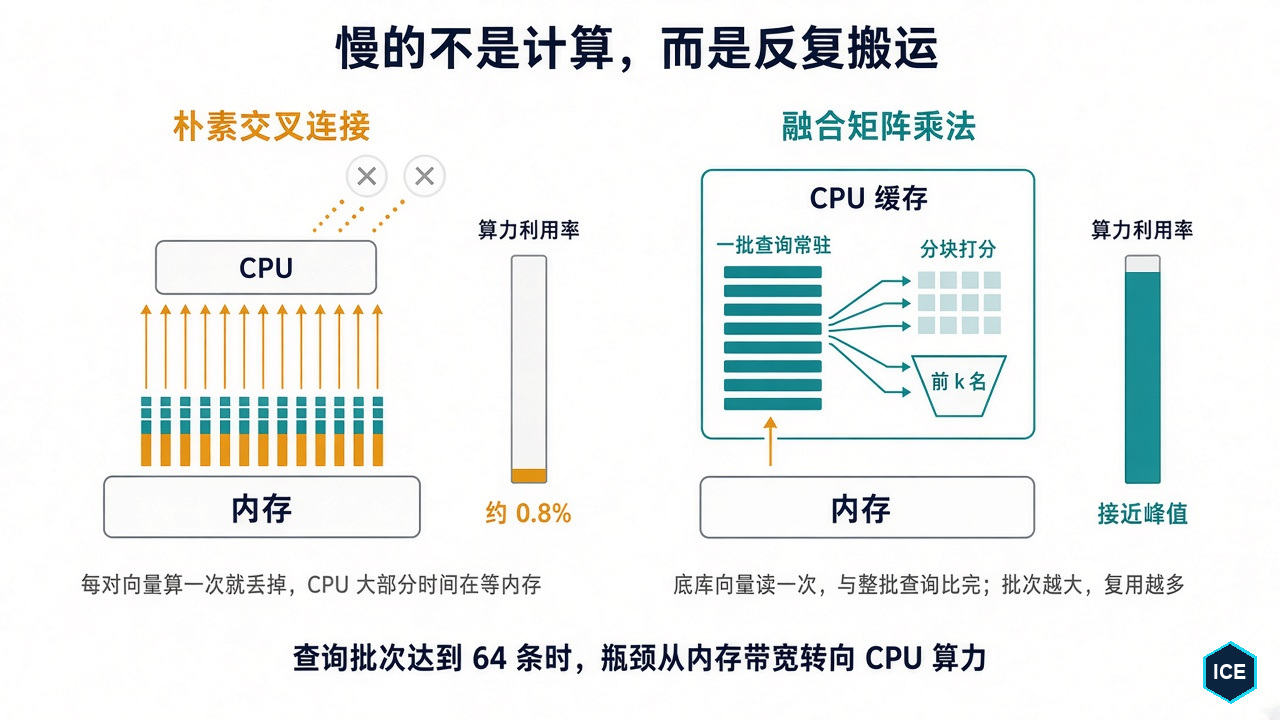
融合不只减少输入读取,也避免输出膨胀。完整的“查询数 × 底库数”分数矩阵不会写回内存;每算完一个小块,就在 CPU 缓存里更新各查询的前 k 名,只有可能入选的结果才继续向下游传。若 k 很大、选择状态占用过多内存,算子才退回为只做矩阵乘法,再把分数交给普通 Top-K 聚合。
这解释了为什么不能只靠增加机器。水平扩展只是把单核效率乘以核数;若每个核都在等待内存,加机器只是复制瓶颈。先提高单核的数据复用,再扩到几十台机器、上千个核,水平扩展才真正有效。
近似索引,是一张按簇排好的表
融合算子解决了“每次比较如何更快”,却没有减少比较次数。精确检索的计算量仍然是“查询数 × 底库数”:一百万条查询对十亿条底库,就是 10¹⁵ 次点积。APPROX 和向量索引要解决的是下一层问题——如何让绝大多数比较根本不发生。
Databricks 选择的是倒排文件索引(IVF)。建索引时,先在样本数据上做 k-means,得到一批簇中心(质心),再把每条底库向量分到最近的簇。查询时,先找出离查询最近的几个质心,只在对应簇内计算分数。原文称,到十亿规模时,每条查询探测的底库可以降到不超过 0.1%。
选择 IVF 而不是 HNSW 这类图索引,考虑的不是单次查询谁更快,而是谁更适合批处理。IVF 的各个簇可以独立扫描,容易分布到不同执行器,也天然适合列式存储;图索引的查询则依赖连续的邻居跳转,更难转成大规模并行扫描。
最关键的不是 IVF 算法本身,而是它的物理形态:索引不是一套独立服务,而是一张普通的 Delta 表。 每行保存一条向量和它所属的簇 id,整张表按簇 id 做液体聚簇,让同一簇的数据集中在连续文件中。查询没有命中的簇,对应文件在读取前就会被跳过;索引刷新也能沿用表的事务和增量更新能力。
一条 APPROX 查询因此形成一条完整路径:先用 NEAREST BY 找到每条查询最近的几个质心;再按簇 id 与索引表做等值连接,只读取命中的簇;接着在簇内复用同一个矩阵乘法内核打分、取前 k 名;最后合并各簇的结果。
如果索引上次刷新后又写入了新数据,这些新文件会走一条暴力补偿路径,结果并入同一次合并。所以,索引过期只会让跳过的文件变少,不会让结果漏掉新数据。
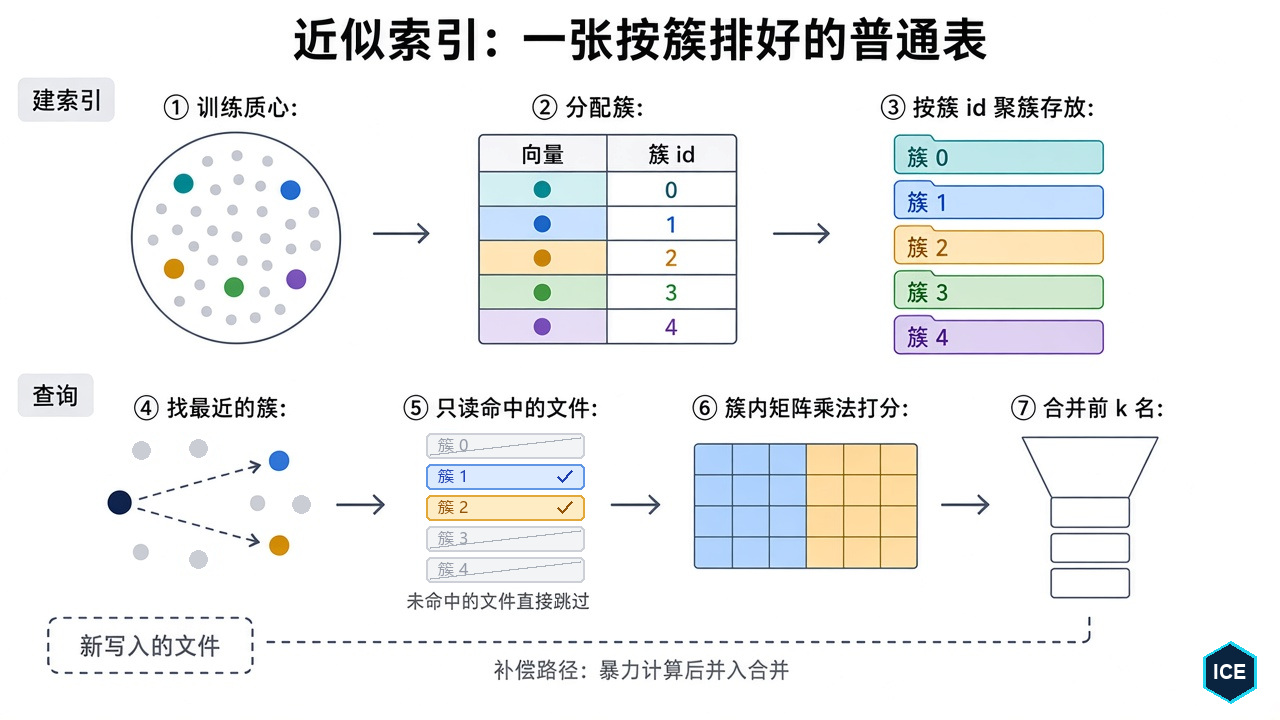
查询表和索引表都很大时,这种布局的收益最明显。系统只需要把查询按命中的簇 id 分发到对应分区;索引侧已经按同一个 id 聚簇,可以直接读取相应文件,不必把整张索引重新分发一遍。
这其实是湖仓里一条老原则的新用法:数据按什么列集中存放,查询就能按什么列跳过文件。过去常用的是日期、租户、类别;NEAREST BY 把它用在了簇 id 上。表格式这次跳过的不是“不属于某个租户的文件”,而是“这条查询不可能命中的向量邻域”。
它适合什么,又不替代什么
到这里可以划清 NEAREST BY 的适用边界。Databricks 在若干批量作业形状上做了测试:底库从十万到五十亿,查询批次最高一千万,近似检索的召回率目标不低于 96%。结果包括:
- 一千万行表自连接做语义去重,几分钟完成;
- 一千万条查询对十万条带标签向量做分类,不到一分钟;
- 一百万条查询对一千万条商品向量刷新推荐候选,几分钟完成;
- 一百万条查询对十亿条参考向量做实体解析,也在几分钟内完成。
这些结果没有公布对照基线和完整硬件配置,因此只能说明它覆盖了哪些作业规模,不能直接拿来做系统间的性能比较。
它适合的是已经存放在湖仓表里的嵌入,按批次、按日程做大规模匹配。它不替代在线检索:聊天机器人和搜索框仍然需要几十毫秒的单次响应,那条路径依然需要面向在线请求的服务层。
对批量作业,改变的是系统账本。过去要维护一份向量副本、一条同步管道和一套在线服务容量;现在,数据仍是一份,检索变成一条 SQL,计算资源可以随作业启动和释放。结果语义也不再由服务端配置隐式决定,而由查询明确选择 EXACT 或 APPROX。
因此,这套设计的价值不在于发明了新的距离函数或索引算法,而在于把各层接通:一个 Join 子句定义语义,一个聚合与融合算子负责执行,一张聚簇表承载近似索引。数据重分发、溢写、权限治理和弹性伸缩,则继续复用执行引擎已有的能力。
小结
- 在语义层,批量向量检索是 Join,不是一连串 RPC。 左表每一行在右表中取前 k 名,
EXACT与APPROX明确结果合同。 - 在执行层,关键不是少做乘法,而是少搬数据。 融合矩阵乘法让一条底库向量被整批查询复用,再在缓存中直接保留前 k 名。
- 在存储层,近似索引可以只是一张表。 按簇 id 聚簇的 IVF 表让绝大多数比较不再发生,同时复用湖仓已有的事务与文件裁剪。
- 在产品边界上,它优化的是批量作业,不取代在线服务。 两者衡量标准不同:前者看整批吞吐与成本,后者看单次延迟。
向量检索的终局,未必是一种新的数据库;对批量作业来说,它更可能是数据库学会了一种新的 Join。
本文部分内容由 AI 辅助生成,经人工审校和补充后发布。
参考资料
- Zero Qu, Alexis Schlomer, Akash Nayar, Yingyi Bu, Sergei Tsarev. “NEAREST BY Join: Scaling Vector Search in Databricks Runtime.” Databricks Blog, 2026-10-05. https://www.databricks.com/blog/nearest-join-scaling-vector-search-databricks-runtime
- Databricks. “NEAREST BY clause.” Databricks SQL Language Reference. https://docs.databricks.com/aws/en/sql/language-manual/sql-ref-syntax-qry-select-nearest-by
- Apache Spark. “JOIN.” Spark 4.2.0 SQL Reference. https://spark.apache.org/docs/latest/sql-ref-syntax-qry-select-join.html