单价跌一半,账单涨五倍:token 从来不是计量单位
先看两个数。
Jefferies 引研究机构 Silicon Data 的口径,8 月 6 到 8 日推理均价落在 1.16 至 1.18 美元每百万 token,今年最低;5 月 31 日是 2.04,7 月底是 1.45。ARK 的另一组口径是从 2.07 跌到 1.02,腰斩。
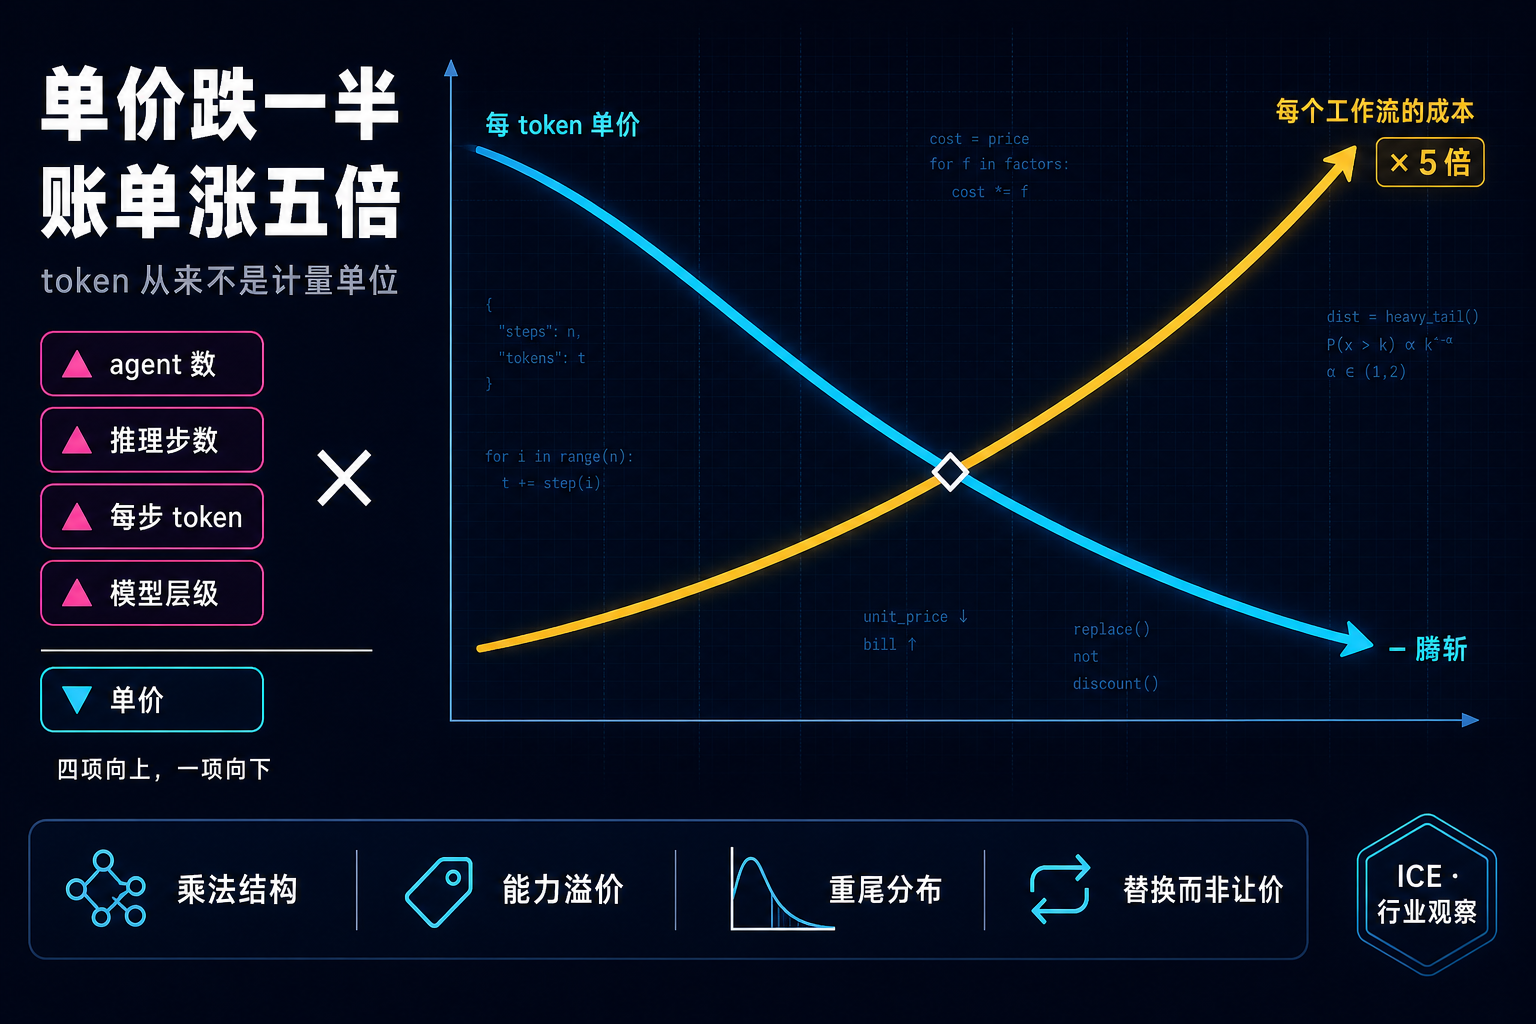
同一个月,8 月 17 日,Gartner 发布了一个方向相反的预测:到 2028 年,单个 agent 工作流的推理成本会涨五倍以上。同一家机构 3 月的预测是,到 2030 年在万亿参数模型上做推理的成本会下降九成以上。Gartner 管这个组合叫「推理悖论」。
两件事同时成立,而且不需要任何一方犯错。因为你买的不是 token,是一个完成的工作流——而一个工作流要花多少钱,取决于五项相乘:参与的 agent 数、每个 agent 的推理步数、每步喂进去的 token 数、模型层级的价格倍率,最后才乘上每 token 的单价。前四项都在涨,只有最后一项在跌。
单价是供应商定的,前面那四项是你自己的架构定的。「等价格再降一点就划算了」,等的是五项里唯一一项不归你管的。
而这只是最上面的一层。往下还有两层,越往下越不是调配置能解决的。第二层是通缩只作用于昨天的能力:达到固定水平的价格每年掉一个数量级,但前沿那一档的价格在每次发布时都重置回顶部。第三层是随机性:同一个任务跑两遍,花掉的钱可能差 30 倍,而模型对自己要花多少并不知情。
前三节按这个顺序往下走,后面几节讲它们的后果,以及市场实际给出的回应——那个回应和多数人以为的不一样。
一、工作流才是商品:四个乘数向上,一个除数向下
这个乘法结构里最容易被低估的是量级。Gartner 的预测建在一个跑了十二种模型原型的 Tokenomics 模型上,给出的区间是:agent 完成等效任务比聊天机器人多用 5 到 30 倍 token;规划类工作是基础工作流的 8 到 10 倍;推理型 agent 在单个任务上可达聊天机器人的 150 倍。分析师 Will Sommer 的说法是,把一个任务路由到 agentic 推理模型,推理成本至少涨五倍,任务越复杂涨得越多。
问题是一手测量普遍超出这个区间的上界。
| 来源 | 测量对象 | 相对聊天的倍数 |
|---|---|---|
| Gartner(工作区间) | agent 完成等效任务 | 5–30 倍 |
| Gartner | 规划类工作 | 8–10 倍(相对基础工作流) |
| Gartner | 推理型 agent 单任务 | 至多 150 倍 |
| Anthropic(自家数据) | 单 agent | 约 4 倍 |
| Anthropic(自家数据) | 多 agent 系统 | 约 15 倍 |
| 微软 / 斯坦福(SWE-bench Verified) | agentic 编码 | 约 1000 倍(相对代码问答与代码推理) |
Anthropic 那两个数来自它自己的多 agent 研究系统:单 agent 约 4 倍,多 agent 约 15 倍。微软研究院与斯坦福等机构那篇论文用 OpenHands 框架在 SWE-bench Verified 上跑了八个前沿模型,得到的是约一千倍。
洞见一:这不是一个价格问题,是一个架构问题
四个向上的乘数没有一个由供应商决定。agent 数量由编排框架决定,步数由规划和验证循环决定,每步 token 数由上下文长度和检索量决定,层级倍率由路由习惯决定。供应商只控制那个唯一向下的项。 所以「等价格再降一点就划算了」这个想法在结构上就不成立——你在等的那一项确实在动,而且单独看动得比其余任何一项都快,但它要对抗的是另外四项的乘积。
二、通缩只作用于昨天的能力
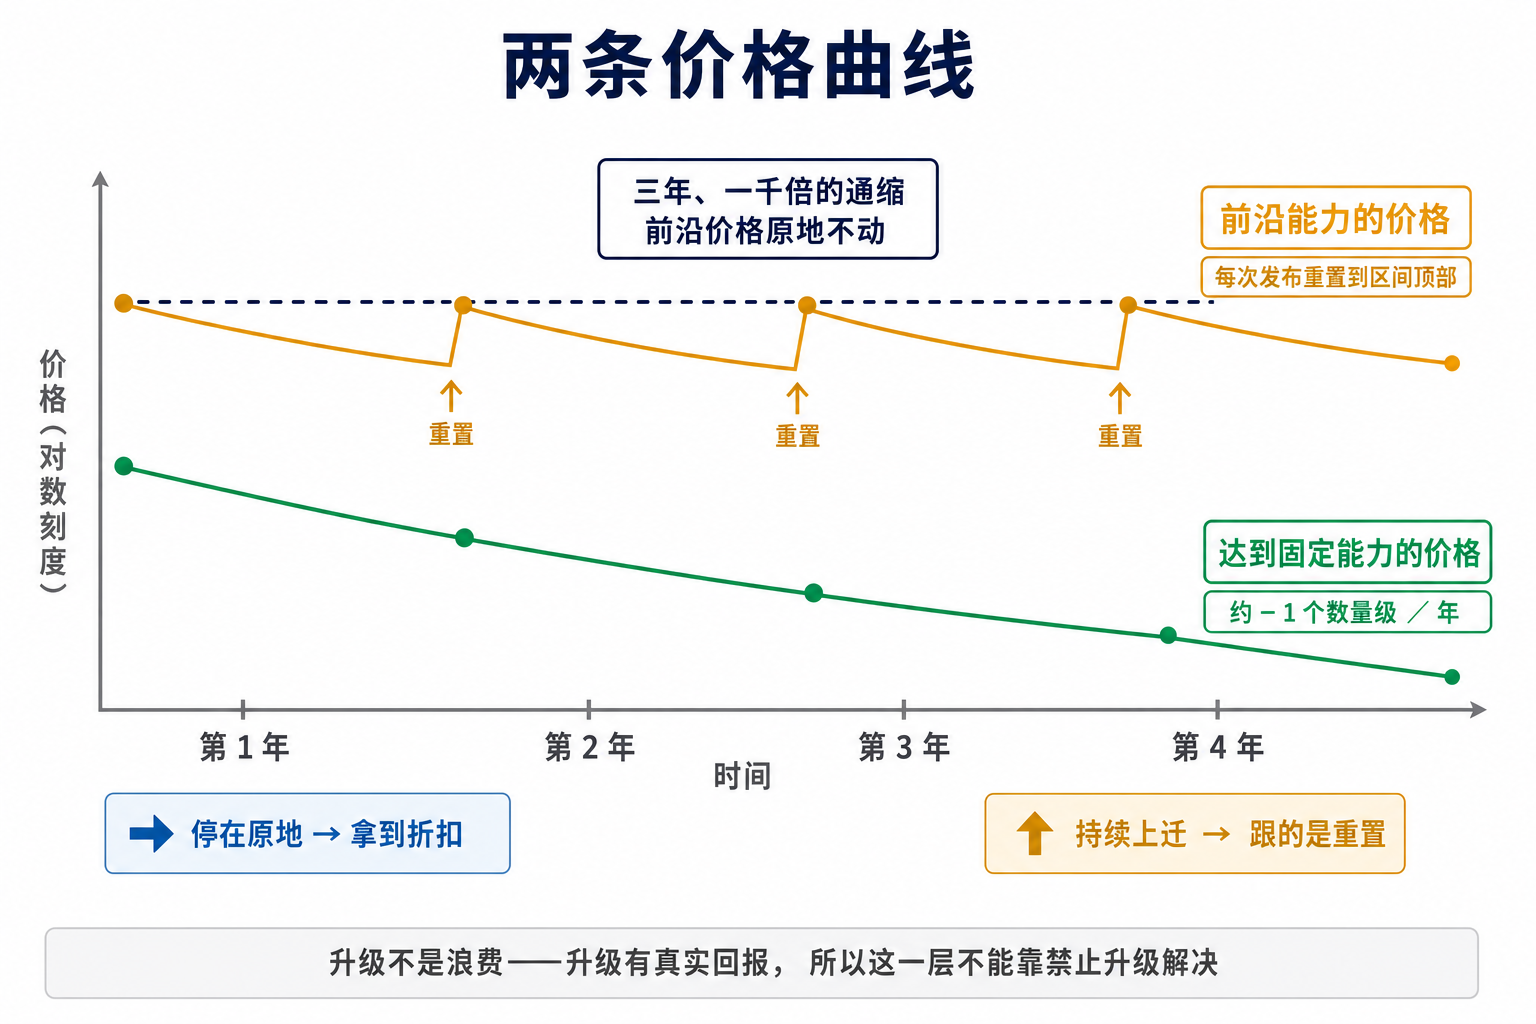
通缩本身是真的,而且比 Gartner 说的更快。a16z 的测算是,达到同等性能的成本每年下降约 10 倍:GPT-3 在 2021 年底的价格是每百万 token 60 美元(MMLU 42 分),到 2024 年底达到同等水平的模型只要 0.06 美元,三年一千倍。Epoch AI 按六个基准跟踪「达到固定能力的价格」,得到每年 9 倍到 900 倍不等的降幅;在 FrontierMath 上达到约 27% 准确率,2025 年 4 月的 o4-mini 需要约 4300 万输出 token,2025 年 12 月的 GPT-5.2 只需约 500 万。Epoch 对总体趋势的判断是每年 5 到 10 倍。
但 a16z 在同一篇里放了另一个数,这个数才是关键:o1 上市时的输出价格是每百万 token 60 美元——和 2021 年 GPT-3 上市时的价格一模一样。
三年、一千倍的通缩,前沿那一档的价格原地不动。
洞见二:存在两条价格曲线,你在哪条上取决于工作流是否持续上迁
一条是「固定能力的价格」,每年掉一个数量级;另一条是「前沿能力的价格」,每次发布重置到区间顶部。省钱的前提是停在原地不动——继续用去年的能力,享受今年的价格。而实际发生的是工作流不断往上迁,因为 test-time scaling 是真的:更多推理算力可靠地换到更好输出,OpenAI 在 o1 的说明里写明了这一点,Snell 等人的论文把它形式化成了扩展律。
于是这一层比第一层难修:升级不是浪费,升级有回报。 你不是在纠正一个错误,你是在为一个真实收益付一个上升的价格。而在没有平台层强制约束的情况下,路由的默认方向只有一个。
三、第三层:你不知道要花多少,模型自己也不知道,而且它猜低
微软研究院与斯坦福等机构那篇论文的价值不在那个一千倍,在后面四条发现。
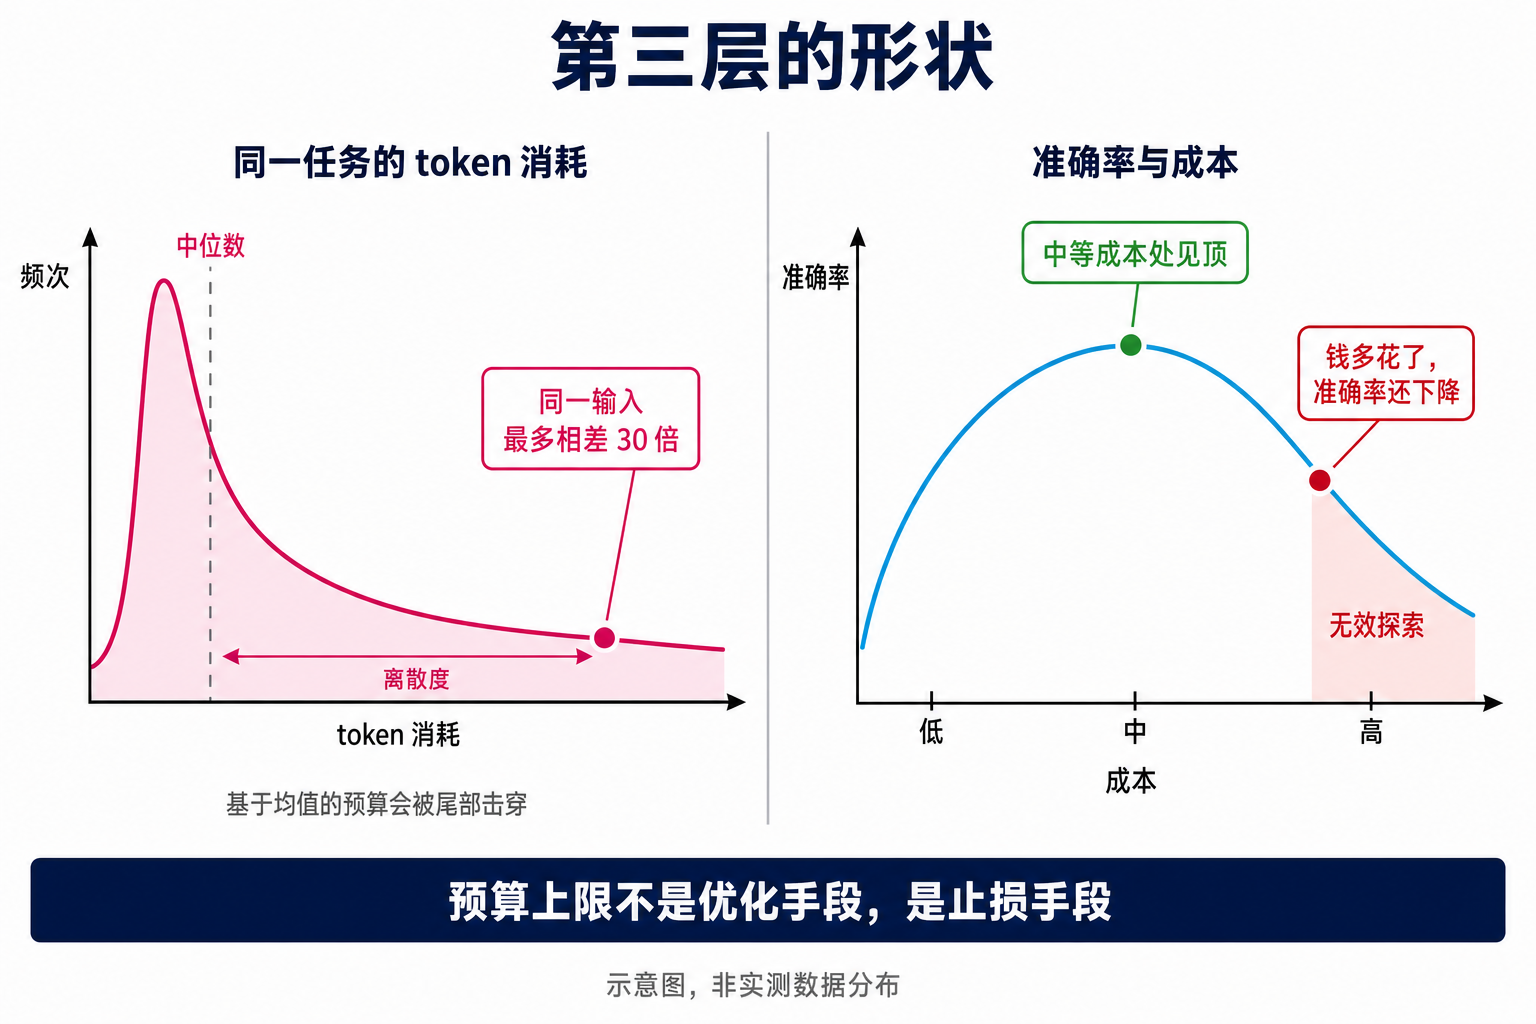
同一个任务,不同 run 的 token 消耗差最多 30 倍。 输入相同,消耗差一个多数量级。论文的措辞是 token 用量「高度可变且本质上是随机的」。
花更多 token 不带来更高准确率。 准确率在中等成本处见顶,在最高成本档下降。论文的解释是,超出中位的支出「更多反映的是无效探索,而不是更深的推理」。
模型之间的 token 效率差异很大,而且与任务无关。 同一批任务上,Kimi-K2 和 Claude Sonnet-4.5 平均比 GPT-5 多消耗超过 150 万 token。把范围限制到所有模型都能解出的简单子集,这个差距依然成立——所以它来自模型自身的行为习惯,不是任务难度。
模型无法预测自己的开销。 让前沿模型在执行前估计自己会用多少 token,相关性只有弱到中等(最高 0.39),并且系统性低估真实成本。另外,人类专家评定的任务难度与实际 token 成本也只是弱相关。
洞见三:agent 成本不是一个可预算的科目,它是一个重尾分布
前两层是均值问题,可以靠架构和路由把均值压下去。第三层是方差问题:同一份输入 30 倍的离散度,意味着任何基于均值的预算都会被尾部击穿;而模型对自己开销的估计不仅不准,还偏低,意味着运行时的自我节流是不可靠的。
推论很直接:预算上限不是优化手段,是止损手段。它的作用不是让你花得更少,是让你在尾部事件里不至于花掉一个不可接受的数。而准确率在中等成本见顶这条更反直觉——它说明存在一个支出水平,越过它之后你既多花了钱又降低了正确率。这是全篇唯一一处「省钱和变好方向一致」的地方。
| 层次 | 表现 | 性质 | 能不能修 | 靠什么 |
|---|---|---|---|---|
| 第一层 | 工作流 = 四个乘数 × 单价 | 配置问题 | 能 | 路由规则、层级纪律、步数与 agent 数上限 |
| 第二层 | 通缩只覆盖旧能力,前沿价格重置 | 结构问题 | 部分能 | 明确哪些工作流允许上迁;但上迁有真实回报 |
| 第三层 | 同一输入 30 倍离散,模型低估自身开销 | 随机性 | 不能 | 只能设硬上限止损,无法预算 |
四、成本在 input,不在 output
同一篇论文里还有一条容易被跳过的发现:在 agentic 编码里,主导总成本的是 input token,不是 output token,即使开启了缓存。
这一条与所有人的优化直觉相反,因为几乎所有定价表都把 output 定得比 input 贵 3 到 5 倍。于是大家优化的方向是「让模型少说话」。
但 agent 的成本结构是反的。agent 每走一步都要重读一遍它的全部上下文:系统指令、工具定义、此前的推理链、此前所有工具返回的结果。步数增加时,被重复计费的是输入。这也是为什么某些多 agent 框架的默认上下文处理方式会让成本随轮次数的平方增长——每加一个 agent,整段对话被重发给每一个同伴。
洞见四:agentic 工作流的成本随任务长度可能是超线性的,而计费单价掩盖了这一点
看单价你会以为成本随 token 线性增长。实际上在一个循环里,上下文是被反复计费的,长度增加会同时推高步数和每步的输入量。这不是「让模型少输出」能解决的问题,要动的是上下文的作用域:每个 agent 携带多少记忆、工具定义要不要全量下发、中间结果要不要压缩后再传。
五、更多 token 买不到更好结果,更好的模型可以
把两组一手数据并在一起,会得到一个比任何一方单独说的都更有用的结论。
Anthropic 的测算是:在 BrowseComp 评测上,三个因素解释了 95% 的性能方差,其中 token 用量单独解释 80%,另两个是工具调用次数和模型选择。它对自己架构的总结相当直白:
多 agent 系统之所以有效,主要是因为它们帮助花掉了足够多的 token 来解决问题。
这看起来是在说「多花钱就行」。但同一篇里紧接着有一句:升级到 Claude Sonnet 4 带来的性能提升,大于在 Claude Sonnet 3.7 上把 token 预算翻倍。
而微软那篇说的是更多 token 不带来更高准确率。三条放在一起并不矛盾:token 是必要条件——不给够预算,任务根本完不成,这解释了那 80% 的方差;但它不是充分条件——给超了,多出来的部分买的是无效探索。
洞见五:同等支出下,模型能力是比 token 数量更强的杠杆
这与流行的直觉相反。「用便宜模型多跑几步」听起来是省钱的办法,但两组数据都指向另一边:换一个更强的模型,比在弱模型上加预算更划算,因为强模型的 token 效率本身就是一个乘数——微软那篇量到的 150 万 token 差距就是这个乘数的价格。所以第一层的「层级纪律」不能简单理解成「一律降级」,正确的说法是把任务路由到能一次做对的最便宜的那一档,而不是最便宜的那一档。
六、买方的真实回答不是优化,是替换
前五节讲的都是买方能在自己架构里做的事。但市场给出的答案更直接。
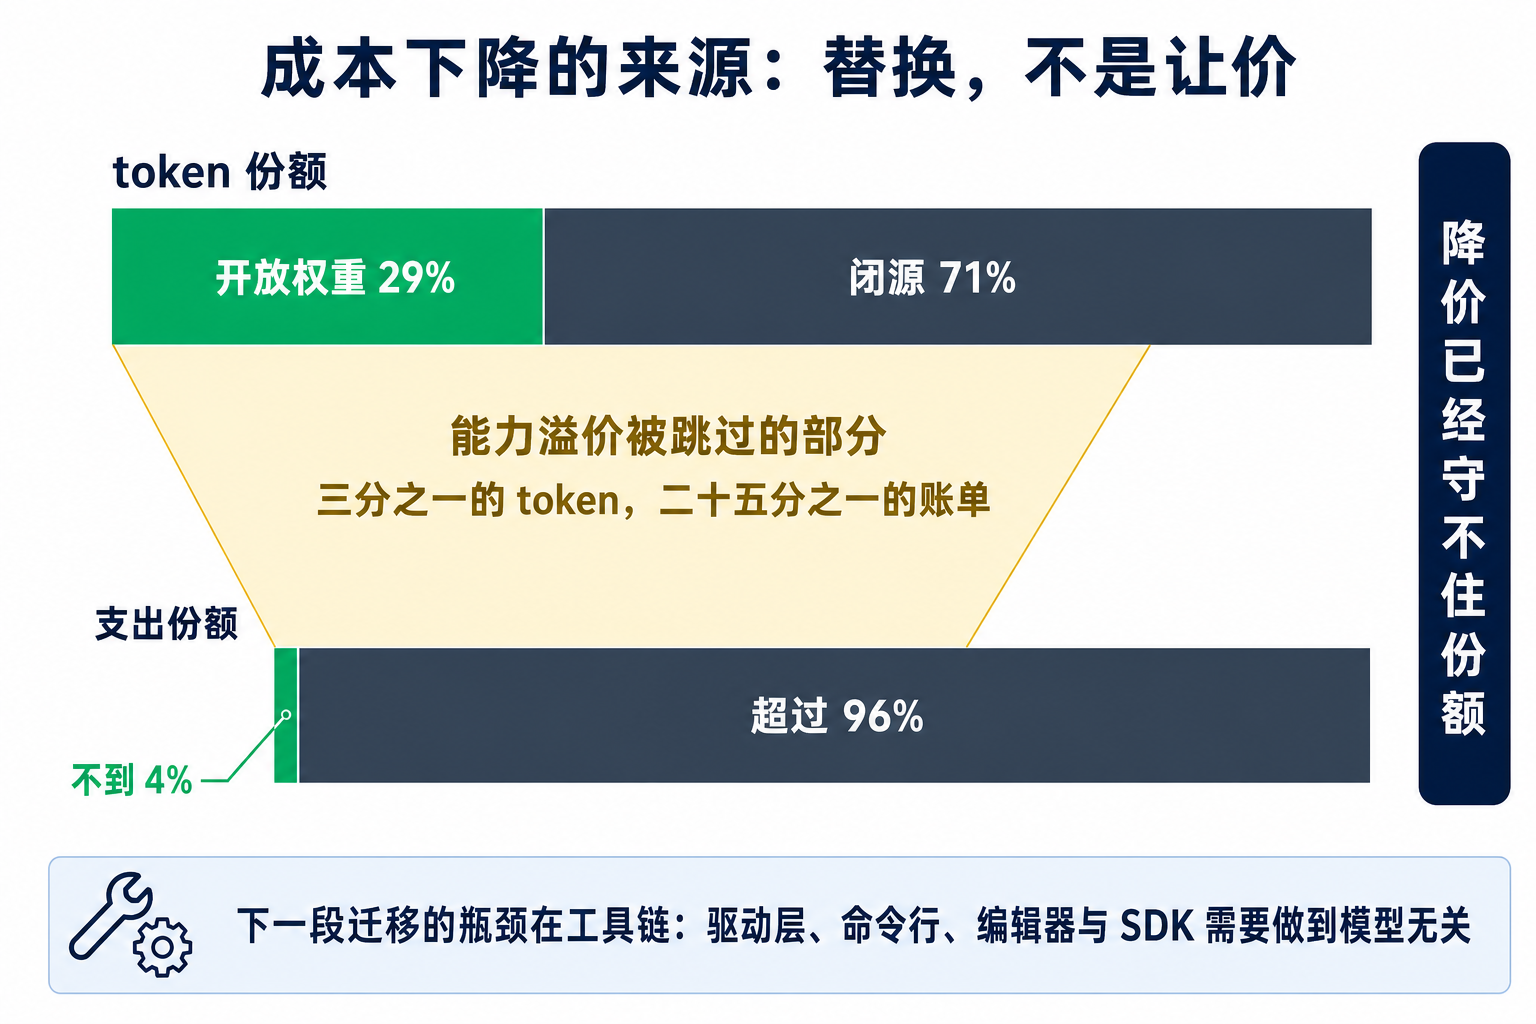
Vercel 的 AI Gateway 每月路由数十万亿 token,它的生产指数给了一组时间序列:开放权重模型的 token 份额,4 月是 11%,6 月是 29%。而这 29% 的 token 只花掉了不到 4% 的支出。
近三分之一的 token,二十五分之一的账单。
| 时点 | 开放权重 token 份额 | 备注 |
|---|---|---|
| 2026 年 4 月 | 11% | |
| 2026 年 6 月 | 29% | 仅占不到 4% 的支出 |
| 6 月 24 日 | 28.4% | |
| 8 月 22 日 | 62% | 该网关历史记录 |
| 8 月 25 日 | 54% | 首次稳定超过闭源的 46% |
6 月的构成里,DeepSeek 以 22.6% 的 token 量排第三,距第二不到两个百分点,同期 Google 的份额回落到 24%。一个更能说明迁移速度的例子是 Z.ai 的 GLM 5.2:采用 MIT 许可、面向长程 agentic 工作、定价约为对标闭源旗舰的五分之一;从 6 月 16 日开放 API 到月底,日 token 量涨了约 50 倍,两周内拿下同系列 6 月 token 的 76%——比此前最快的同系列迁移还要快一个月。到 8 月 25 日,该网关 token 量前五里有四个是中国开放权重模型。
另一个中立路由平台 OpenRouter 上的曲线更陡。据 OpenRouter 与 a16z 联合分析的超过 100 万亿 token 匿名用量数据,中国开放权重模型的份额一年内从 1.2% 涨到近 30%;另一组测算显示,美国三家主要闭源厂商在该平台的 token 份额从 2025 年 6 月的约 70% 掉到 2026 年 6 月的约 30%,转折点是 2026 年 2 月 9 至 15 日那一周。
洞见六:三分之一的 token 对应二十五分之一的账单,说明降价和份额已经脱钩
如果份额是靠价格竞争决定的,那么闭源厂商降价就应该守住 token 份额。实际发生的是份额在价格下跌的同时崩塌。原因在那个 4% 里:闭源那一档卖的不是 token,是能力溢价,而能力溢价对多数工作流是过剩的。一个只需要搜收件箱的任务不需要前沿推理,但很多企业照着前沿推理付钱。
所以这一轮成本下降的主要来源不是供应商让价,是买方换掉了供应商。而下一段迁移的瓶颈也已经很清楚——Vercel 的 CEO 说企业采用还处在早期,因为 harness、CLI、IDE 和 SDK 还需要被改造成模型无关的。瓶颈现在在工具链,不在模型质量。
七、取消率的真正机制不是成本高,是成本不可预测
失败特征已经在调查数据里了。
Gartner 2025 年 6 月的预测是,到 2027 年底超过 40% 的 agentic AI 项目会被取消,给出的三个理由是成本攀升、业务价值不清、风险控制不足。S&P Global 调查了超过一千家企业,发现在投产前放弃大部分 AI 计划的企业占比一年内从 17% 涨到 42%,另有 46% 的概念验证在推广前被砍掉。MIT NANDA 的调查给出的数字更低:只有约 5% 的企业生成式 AI 试点实现了快速的收入加速;采购来的工具成功率约 67%,自建项目大约只有它的三分之一。
洞见七:杀死项目的不是账单的绝对值,是「账单不可预测」加上「价值不可归因」
如果成本高但可预测,它就是一笔可以做投资决策的开支。第三层说明它不可预测:同一输入 30 倍离散,模型自己还低估。而价值那一侧同样缺计量——企业通常无法说清哪一次 agent 决策产生了哪一笔业务结果。一侧是重尾分布的支出,另一侧是无法归因的收益,任何财务评审都会否掉这种组合。 所以 40% 的取消率不是技术不成熟的证据,是计量缺失的证据。
结论
四条可以带走:
token 不是计量单位,完成的工作流才是。 成本等于 agent 数、步数、每步 token 数、层级倍率四项相乘再乘单价,而只有单价由供应商控制。等价格再降一点就划算,等的是四个乘数里最小的那一个。
通缩只覆盖昨天的能力。 达到固定能力的价格每年掉一个数量级,前沿那一档的价格每次发布重置到顶部——o1 的上市输出价与三年前 GPT-3 的上市价完全相同。省钱的前提是停在原地,而 test-time scaling 让上迁有真实回报,所以这一层不能靠「禁止升级」解决,只能靠明确哪些工作流值得上迁。
第三层是随机性,只能止损,不能预算。 同一任务不同 run 差最多 30 倍,准确率在中等成本见顶、在最高档回落,前沿模型预测自身开销的相关性最高 0.39 且系统性低估。硬上限的作用不是省钱,是防尾部。而「越过某个支出水平后钱多花、正确率还下降」是唯一一处省钱和变好同向的地方。
成本下降的主要来源是替换,不是让价。 开放权重在一个大型网关上跑掉 29% 的 token,只占不到 4% 的支出;八月已两度过半,最高 62%。闭源那一档卖的是能力溢价,而溢价对多数工作流过剩。眼下的瓶颈是工具链能否做到模型无关,不是模型质量。
再往前一步。这个博客此前写过 AI 通胀跑在生产率前面,也写过训练数据的价格是怎么被一条地理套利链压下来的。这篇是第三张账单,而它的形状和前两张都不一样:训练数据的成本靠转移到更便宜的地方来压,推理的成本靠替换供应商来压,但两者都没有解决计量问题。地理套利链上的价格之所以能一路往下走,是因为下一站没人测量;agent 项目之所以成批被取消,是因为支出和收益两侧都没有可用的计量口径。
所以问题是:如果一个 agent 工作流的支出是重尾分布,而它产生的价值无法归因到具体决策上,那么在财务上,它和一笔无法定价的期权有什么区别?