HTTP 402 正在把开放互联网改造成数据交易所
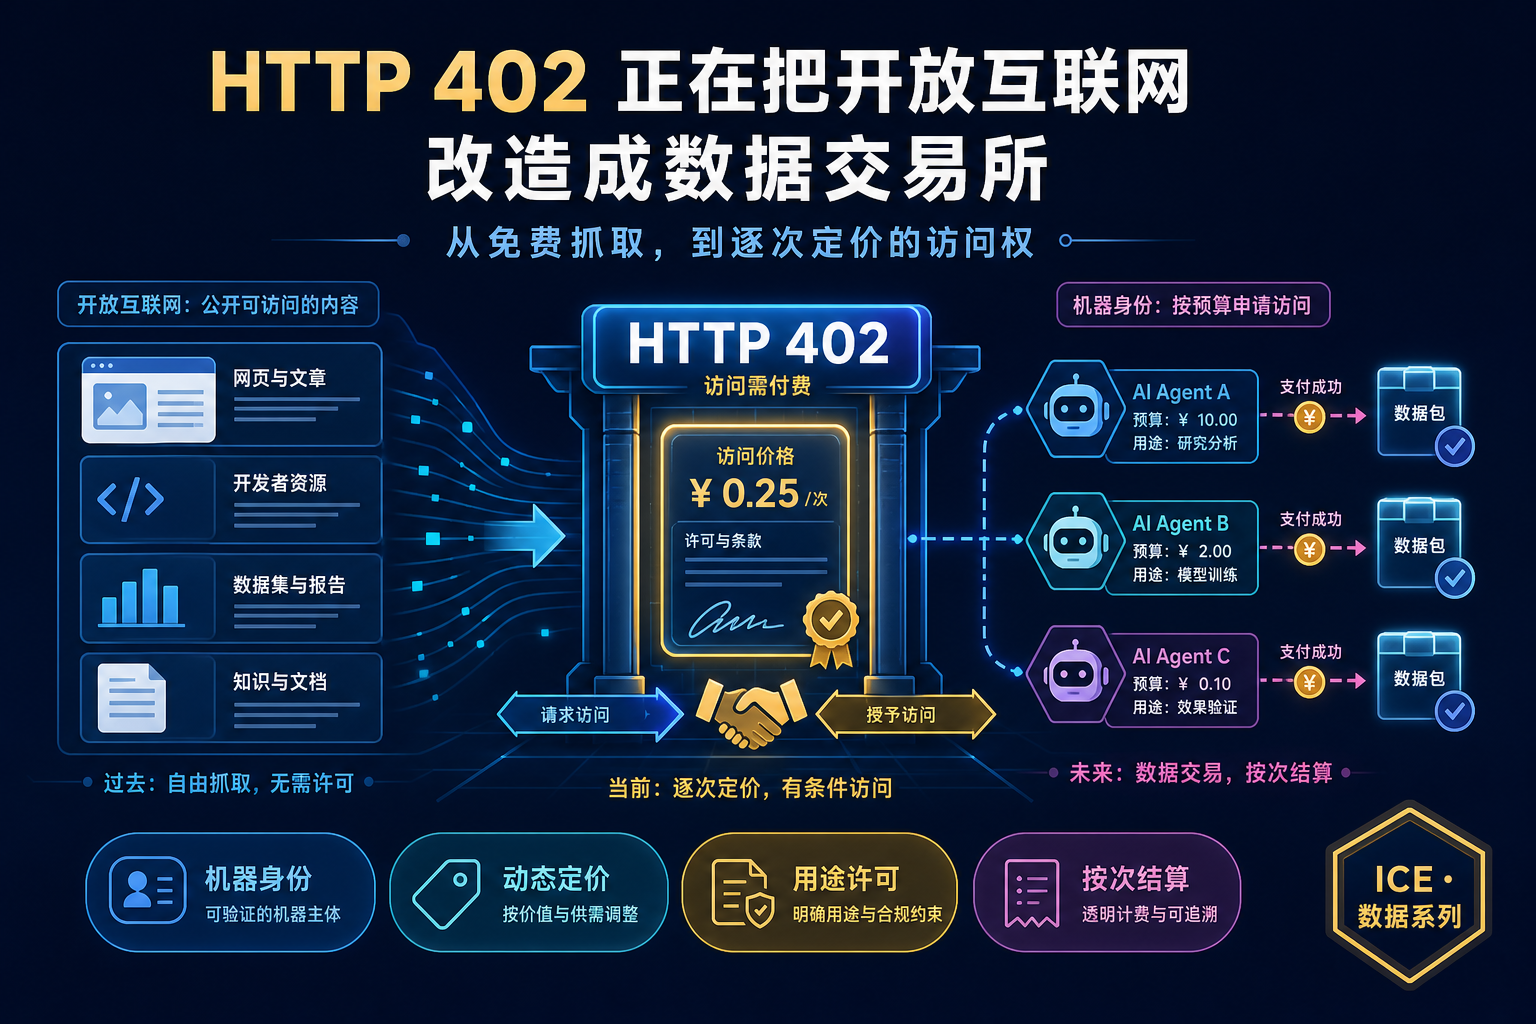
开放互联网曾经有一笔没有写进合同的交换:网站允许搜索引擎抓取内容,搜索引擎把用户送回网站。创作者得到流量、广告和订阅,搜索引擎得到可索引的信息。
AI 改变了交换的后半段。模型和智能体仍然抓取内容,却可以在自己的界面里完成检索、比较、摘要乃至决策,用户不再必须访问原网页。内容依然被消费,回流却可能消失。
Cloudflare 在 2025 年拿出了一个直接的解决办法:当 AI 爬虫请求网页时,服务器不再只能返回 200 OK 或 403 Forbidden,还可以返回 402 Payment Required,并在响应头里写明价格。爬虫如果愿意支付,就带着付款意图重新请求;如果价格超过预算,就离开。
这看起来只是给网页加了一台自动售货机,实质上却是一次更大的结构变化:公开可见的内容与机器可免费批量使用的内容,开始成为两件事。 人仍然可以打开网页,机器对内容的规模化访问则需要先声明身份、用途和预算。
但标题里的“数据交易所”需要加上边界。目前最完整的 Pay Per Crawl 仍处于封闭测试阶段,由一家基础设施平台担任记账与结算中心;一次抓取付款也不自动等于获得训练、再分发或生成答案的全部权利。HTTP 402 提供的是交易入口,不是完整的产权制度。
一、旧交换为什么开始失效
按次收费出现之前,内容网站通常在三种方案之间选择:允许爬虫、通过 robots.txt 表达拒绝,或者直接封锁。
这套机制在搜索时代勉强成立,因为搜索爬虫的目的主要是建立索引,再把人送往原页面。AI 系统的消费方式不同:它不仅寻找页面,还把页面中的信息吸收到训练集、检索索引或最终答案里。
Cloudflare 用“抓取—回流比”描述这种差异:某个平台的爬虫请求了多少 HTML 页面,才给来源网站带回一次带有该平台 Referer 的访问。2025 年 6 月 19—26 日的样本里,不同 AI 平台的比例从 0.1:1 到 70900:1 不等。传统搜索爬虫通常只需抓取几次或更少,就能换回一次访问。
这个数字不能直接当成平台给网站创造价值的完整衡量。原生 App 打开的链接未必携带 Referer,不同爬虫还可能分别承担训练、实时检索和用户委托任务,Cloudflare 自己也承认该指标可能高估部分平台的比例。它仍然揭示了一个方向:抓取和回流不再天然绑定。
到 2026 年 6 月,在 Cloudflare 可识别用途的爬虫请求中,用于 AI 训练的比例从上一年春季的 22% 增至 52%;混合搜索、agent 和训练用途的请求又占 36% 以上。这些是 Cloudflare 网络上的观测,不代表整个互联网,但它解释了为什么内容生产者不再满足于 robots.txt 的“请勿抓取”。
| 访问方式 | 面向谁 | 定价粒度 | 是否技术强制 | 主要问题 |
|---|---|---|---|---|
| robots.txt | 爬虫 | 无 | 否,主要是意愿声明 | 不付款,也无法阻止不守规则者 |
| 人类付费墙 | 人 | 订阅或单篇 | 是 | 注册、登录和结账不适合机器 |
| 大宗数据许可 | 企业 | 整库、年度合同 | 合同与专用接口 | 谈判慢,小网站缺少议价能力 |
| Pay Per Crawl | 已识别的机器客户端 | 单次请求、页面或路径 | 边缘网关执行 | 身份、许可范围与平台集中仍待解决 |
Stack Overflow 对此的概括是“yes, if”:不是无条件开放,也不是彻底封锁,而是满足身份、价格和使用条件之后开放。
二、一次 402 请求到底发生了什么
HTTP 402 从 1997 年起就是保留状态码,但状态码本身从来没有规定如何识别买家、如何报价、用什么付款,以及如何分账。真正让它可用的,是状态码外面补齐的一组身份和计费机制。
Cloudflare 当前的实现先要求爬虫完成注册。爬虫生成 Ed25519 密钥对,公开 JWK 格式的公钥,并用 HTTP Message Signatures 为请求签名。这样,计费对象不再只是一个可以随意伪造的 User-Agent 字符串,而是一个能够验证私钥持有关系的机器主体。
随后有两条访问路径。
第一条是先询价。爬虫第一次请求页面,边缘节点返回:
HTTP/2 402 Payment Required
crawler-price: USD 0.01
爬虫判断页面是否值得购买。如果接受,就在第二次请求中带上:
crawler-exact-price: USD 0.01第二条是先报价。爬虫在第一次请求里直接声明预算上限:
crawler-max-price: USD 0.02如果页面价格不超过预算,请求直接通过;系统只按页面实际价格收费,而不是把预算上限全部扣掉。成功响应会包含 crawler-charged,使购买记录能够进入后续账单和审计。
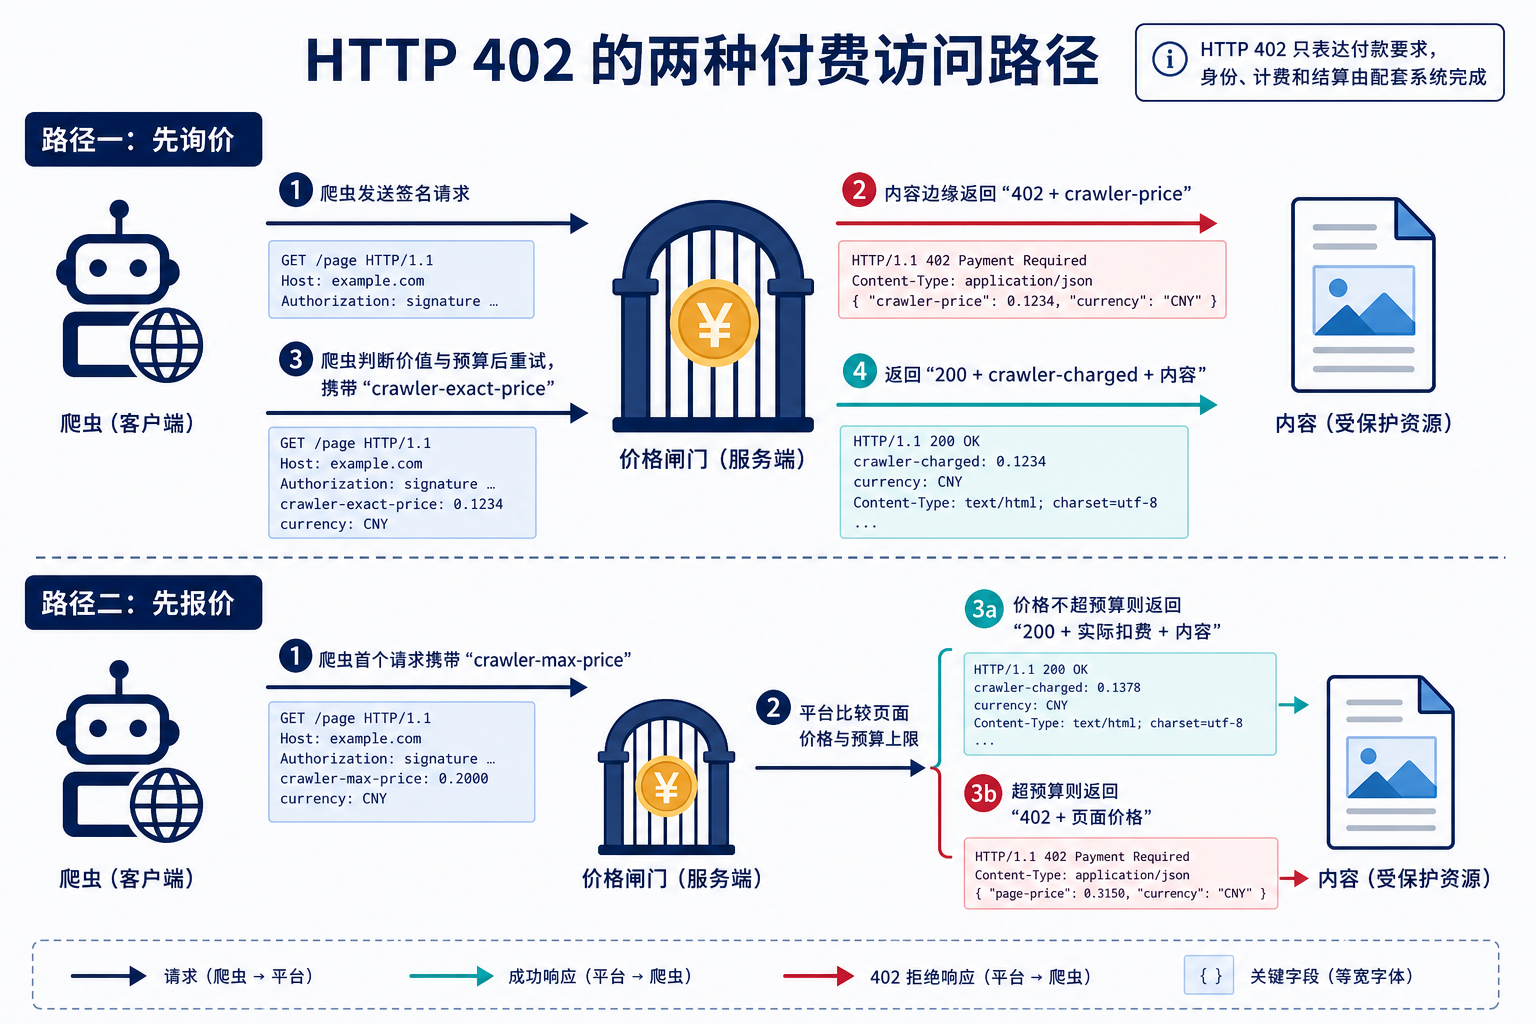
Cloudflare 在其中同时扮演边缘执行者和 Merchant of Record:记录成功访问,聚合账单,向爬虫收费,再把收入分给内容所有者。现阶段买卖双方都要有平台账户,爬虫还需要接入验证与支付关系。因此,这不是一个“任何服务器和任何 agent 都能直接互付”的开放协议,而是一套借用 HTTP 402 作为交易信号的平台化实现。
这里也能看出它与 7 月那篇《Agent 开始自己刷卡:自主支付的三道关》的区别。那篇讨论 agent 如何获得授权、完成结算并承担责任;本文讨论的是内容访问如何被变成可计价商品。支付轨道只是底层条件,谁能抓、抓什么、获得什么使用权才是这里的主角。
三、付费抓取不等于获得训练权
如果只实现“请求一次扣一次钱”,交易仍然缺少最重要的字段:买方付费以后究竟能做什么?
抓取是一种技术动作,训练、索引、检索增强、生成摘要和展示原文则是不同用途。一个爬虫付费下载网页,不意味着它自动获得了永久训练模型、向第三方再分发或在答案中大段复现内容的权利。没有独立许可条款,402 只证明“这次访问付过钱”,无法证明“这种后续使用得到授权”。
Really Simple Licensing(RSL)1.0 正在补这一层。它用机器可读的 XML 文档描述数字内容的允许用途、禁止用途、用户类别、司法辖区、费用和报告义务,并把 AI 使用至少拆成:
ai-train:训练或微调模型;ai-input:作为检索增强、grounding 或生成式搜索的输入;crawl:每次抓取计费;use:每次内容参与模型输出时计费;attribution:要求展示来源和有效链接。
RSL 的意义不在于又造了一种 robots.txt,而是把“能不能访问”和“访问以后能做什么”拆开。网站可以允许搜索索引和链接,却禁止训练;也可以允许 RAG 使用,但要求每次输出计费。
不过,RSL 规范本身仍不能强迫所有爬虫遵守。其开放许可协议、爬虫授权协议和加密媒体扩展都是可选模块;网站也可以继续使用自己的许可服务器与支付基础设施。机器可读条款解决的是表达与互操作,边缘网关、身份系统和法律合同解决的才是执行。
因此,一个完整的数据交易至少需要四层:
- 身份层:确认是哪一个爬虫或 agent;
- 访问层:决定是否返回内容;
- 许可层:声明允许的用途与限制;
- 结算层:计费、收款、分账和留存凭证。
HTTP 402 只是访问层与结算层之间的一句话。把这句话当成完整的数据产权协议,会高估它。
四、网页应该卖多少钱
即使身份和许可都解决了,市场还会立刻遇到一个现实问题:每篇内容值多少钱?
全站统一定价容易实施,却把一条即时新闻、一篇多年积累的评测和一份稀缺数据库当成同一种商品。按栏目定价好一些,但真正影响 AI 买方意愿的特征往往藏在正文里,例如时效性、数据密度、适用司法辖区、产品档位或是否包含独家测量。
耶鲁研究团队 2026 年提出的 LM Tree,尝试让模型从文章文本和买方的接受/拒绝反馈中自动发现这些定价特征。实验使用德国科技媒体 HardwareLuxx 的 8939 篇真实文章,并基于真实 AI 爬虫访问量构造支付意愿代理,再为每篇文章生成 9 个模拟买方请求,共 80451 个交易样本。
| 定价策略 | 测试集收入 | 相对全站统一价 |
|---|---|---|
| 全站统一价格 | 160 美元 | 基准 |
| 新闻/长评测两类价格 | 179 美元 | +12% |
| 媒体原有 8 类编辑分类 | 189 美元 | +18% |
| LM Tree 从正文发现分组 | 264 美元 | +65% |
LM Tree 比两类定价高 47%,比媒体自己的八类目录高 40%。它发现,高端 GPU、CPU、精确性能参数和高级散热内容具有不同的支付规律,而这些差异横跨编辑部原有栏目。
这组结果很有启发,但不能写成“真实市场收入提高 65%”。HardwareLuxx 当时没有上线按次收费,也没有真实成交价格。研究将支付意愿设为“0.004 × 观察到的爬虫访问量”,然后模拟买方是否购买。真实爬取频率能否代表真实付款意愿,仍需上线市场验证。
更重要的含义是:一旦网页可以逐次报价,内容本身会成为动态定价的输入。今天的 SEO 系统判断内容能否获得流量,明天的定价 agent 可能判断某个买方为某篇内容应付多少钱。开放网页由此第一次具有了类似交易所的连续报价能力。
五、创作者拿回议价权,中介拿走市场视野
Pay Per Crawl 最直接的收益是让缺少大宗授权谈判能力的网站也能表达价格。过去,只有大型出版集团有机会和模型公司逐一签约;按次交易把最小商品单位缩小到一个请求,理论上可以让小型网站参与。
但市场不会因此自动去中心化。恰恰相反,按次交易要求有人同时看见并协调四类信息:谁在抓取、抓了什么、愿意付多少、最后如何结算。单个网站很难独立维护全球爬虫身份库、对抗伪装客户端、追踪不同用途并向大量机器买家收款。
于是,最可能成为“交易所”的不是内容网站,而是位于它们前面的基础设施层。它掌握:
- 全网范围的爬虫身份与行为画像;
- 不同内容的需求量和成交价格;
- 买方的预算上限与购买偏好;
- 内容所有者的收费规则和收入表现。
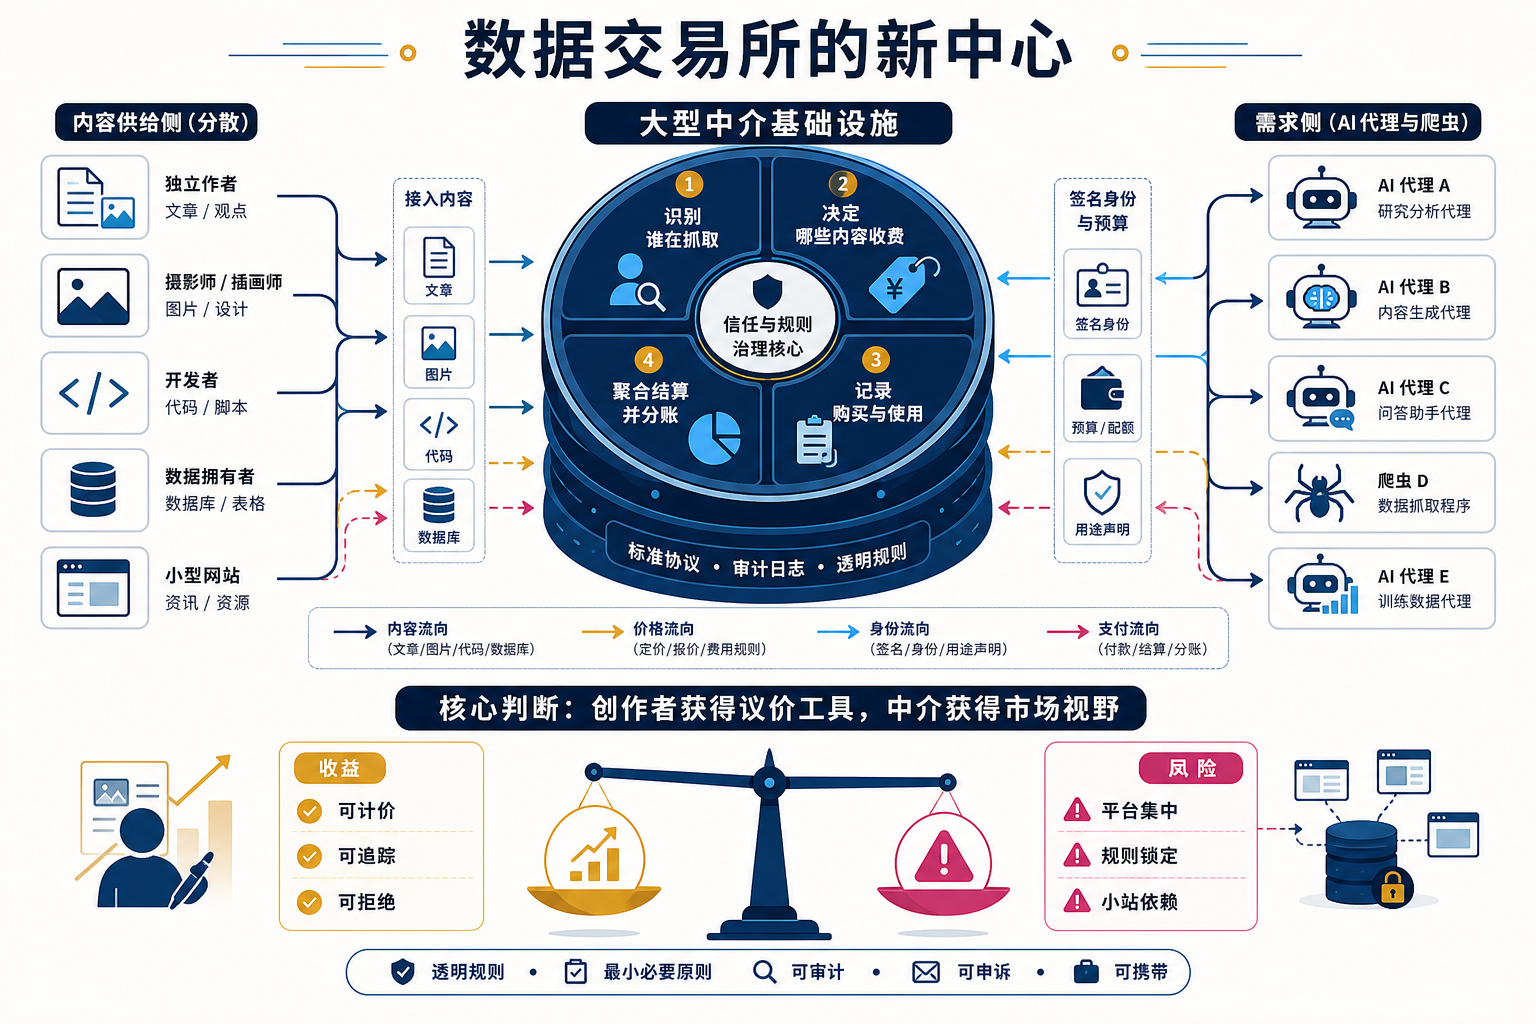
这些信息能降低交易成本,也会形成新的锁定。平台可以决定哪些爬虫属于搜索、训练或 agent,什么行为被允许,哪些价格字段有效,以及纠纷以谁的日志为准。内容所有者获得了议价工具,中介则获得了整个市场的视野。
这不是否定基础设施平台的价值。没有统一身份、规则执行和聚合结算,单次几分钱甚至更小的内容交易很难成立。问题在于:一套帮助创作者摆脱模型平台议价权的工具,可能同时把他们带入对新交易平台的依赖。
六、它还没有解决什么
HTTP 402 要真正把开放互联网变成可持续的数据市场,至少还有四个问题没有答案。
价格与价值不一致。 一次抓取可能只用于去重检查,也可能进入数十亿用户使用的模型。按请求收同一个价格,无法反映后续价值。按推理或输出分账更接近实际使用,却要求模型系统披露内容是否参与了答案,这比记录抓取困难得多。
付费者可能减少抓取。 内容所有者看到的是潜在新收入,AI 企业看到的则是新增边际成本。它们可能优先购买少数高价值来源,减少长尾网站抓取。最终结果未必是所有创作者都获得收入,也可能是需求进一步集中到少数权威数据源。
身份验证只覆盖愿意被识别的爬虫。 签名身份可以阻止别人冒充已注册买家,却不能自动让恶意爬虫自愿注册。对不合作的客户端,仍然需要 WAF、行为识别、法律追索或不给内容。
访问许可与版权边界仍需法律解释。 机器可读条款能减少模糊空间,却不能自行决定训练是否属于合理使用,也不能替代不同司法辖区的版权规则。技术系统可以留下谁何时同意了什么的证据,不能独自创造一项不存在的权利。
因此,今天最准确的判断不是“开放互联网已经开始按次收费”,而是:互联网正在第一次尝试把机器访问从默认免费权利,改造成可声明条件、可报价、可拒绝的交易。
结论
这场变化可以浓缩成四点:
- 搜索时代的流量交换正在失效。 AI 系统能够直接消费和重组内容,抓取量与来源网站获得的访问量不再匹配。
- HTTP 402 把“允许或禁止”变成了“满足条件后允许”。 配合签名机器身份、价格响应头和聚合结算,一次网页访问可以成为自动交易。
- 付款不等于获得全部使用权。 抓取、训练、检索和生成输出必须由许可层分别表达,RSL 1.0 正在尝试提供这套机器可读语言。
- 新的议价权伴随新的中心化。 内容所有者获得计价工具,负责身份、规则和结算的基础设施平台则可能成为真正的数据交易中心。
robots.txt 代表的是请求,付费墙代表的是封闭,HTTP 402 试图提供第三条路:内容继续对人开放,但机器规模化使用它时,需要先说明自己是谁、要做什么,以及愿意付多少钱。
真正的问题是,当公开知识被拆成一次次可计价的机器访问后,我们得到的会是一个更公平的内容市场,还是一个由少数访问中介控制的新互联网?
参考资料
- Cloudflare,《Introducing pay per crawl: Enabling content owners to charge AI crawlers for access》,2025 年 7 月 1 日。https://blog.cloudflare.com/introducing-pay-per-crawl/
- Cloudflare Docs,《What is Pay Per Crawl?》,更新于 2026 年 7 月 28 日。https://developers.cloudflare.com/ai-crawl-control/features/pay-per-crawl/what-is-pay-per-crawl/
- Cloudflare,《The crawl before the fall… of referrals: understanding AI’s impact on content providers》,2025 年 7 月 1 日。https://blog.cloudflare.com/ai-search-crawl-refer-ratio-on-radar/
- Stack Overflow,《Beyond block or allow: How pay-per-crawl is reshaping public data monetization》,2026 年 2 月 26 日。https://stackoverflow.blog/2026/02/26/how-pay-per-crawl-is-reshaping-data-monetization/
- Richard Archer、Soheil Ghili、Nima Haghpanah,《Pay-Per-Crawl Pricing for AI: The LM-Tree Agent》,Yale Cowles Foundation Discussion Paper,2026 年。https://arxiv.org/html/2604.01416
- RSL Technical Steering Committee,《Really Simple Licensing 1.0 Specification》,2025 年 12 月 10 日。https://rslstandard.org/rsl
- Cloudflare,《Content Independence Day, one year on—building the business model for the agentic Internet》,2026 年。https://blog.cloudflare.com/agentic-internet-bot-report/
- ICE 数字实验室,《Agent 开始自己刷卡:自主支付的三道关》,2026 年 7 月 6 日。
本文部分内容由 AI 辅助生成,经人工审校和补充后发布。