上下文写回:数据库厂商真正要抢的,是 Agent 的写流量
11 月 3 日到 5 日,三天之内,五家数据厂商发了同一类东西:
- Snowflake(11/3,Expedition 2026):Business Ontology、Agent 轨迹入表、CoCo 和 CoWork 的记忆与自动化;
- Google Cloud(11/4):Knowledge Catalog 加上“自学习”补全,AlloyDB 推出面向 Agent 的版本;
- PhoenixAI(11/4,StarRocks 的原班人马,原名 CelerData):发布 Contextbase;
- Redis(11/4):Redis Iris 扩展成记忆、上下文、路由、消息六件套;
- Eon(11/5):发布 Yukon,在数据写入时顺手生成给 Agent 用的上下文。
如果只看标题,这和 9 月那一轮很像。我们在《上下文层之争》里写过 Fivetran、Databricks、Teradata:它们争的是业务定义放在哪、以什么形态交给 Agent,一家给表,一家给答案,一家给结果。
但把这一周的新闻稿放在一起读,会发现一个高频词:复利(compound)。
- PhoenixAI CEO 说,上下文“应该放在一个实时系统里,在那里它会复利,每一次运行都让它更好”;
- Redis 把“上下文应当随 Agent 从过往交互中学习而复利”列为 Iris 的四条原则之一;
- Snowflake 把“共享技能、配置和记忆,让每个新 Agent 起点都比上一个高”叫作 Compound;
- Google 给 Knowledge Catalog 加的能力,名字就叫“自学习补全”。
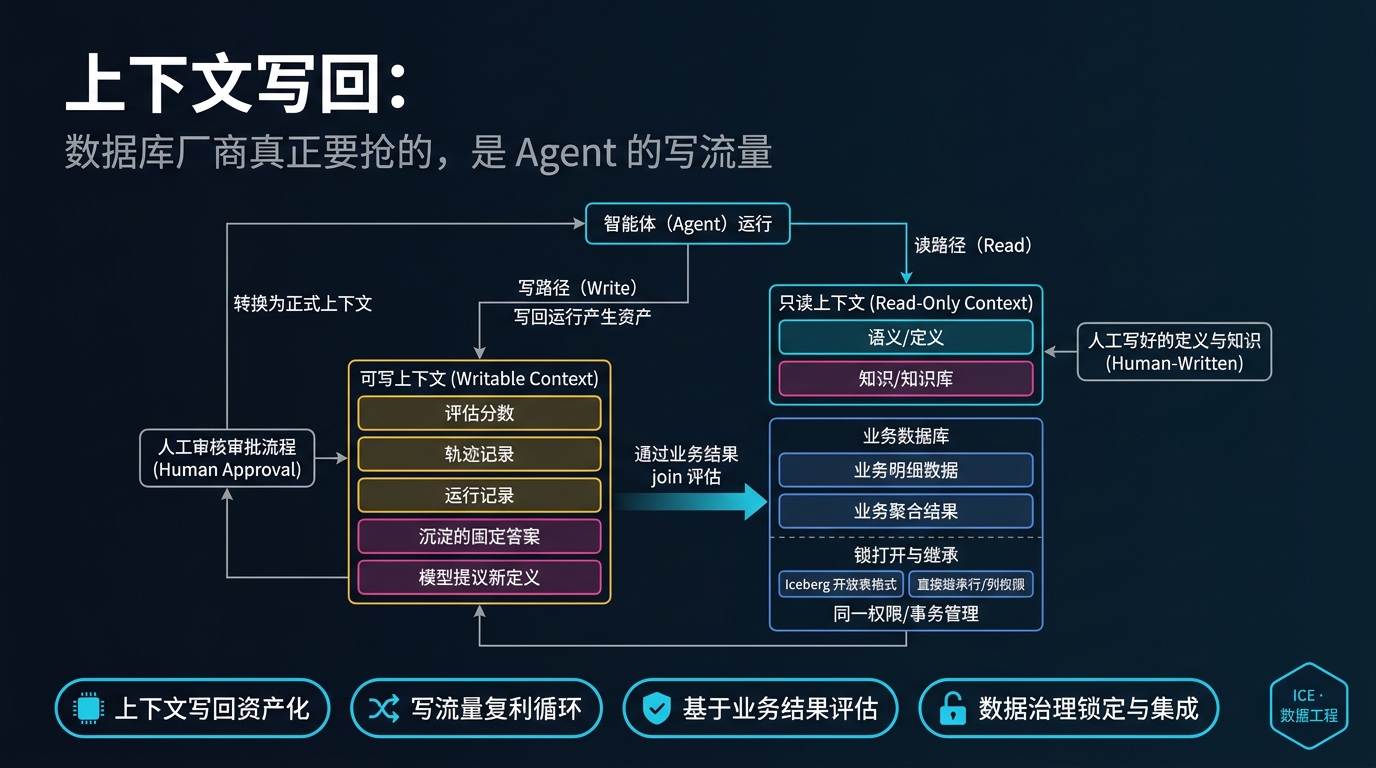
复利的前提是有东西不断存进去。存进去的不是人工写好的定义,而是 Agent 运行本身留下的东西:记忆、轨迹、评估分数、被沉淀下来的固定答案、模型提议的新定义。
先说结论:9 月那一轮争的是 Agent 的读路径,这一轮争的是写路径。谁接住 Agent 的写回,谁就拥有那份会复利的资产,以及随之而来的锁定。
一、上下文正在从“参考资料”变成“账本”
先把“上下文”拆开。PhoenixAI 的发布稿给了一个很好用的分类,它把 Agent 需要的上下文分成五种:
| 成分 | 例子 | 过去谁写 | 现在谁写 | 变化频率 |
|---|---|---|---|---|
| 语义 | 实体、维度、指标口径 | 数据团队 | 数据团队 + 模型提议 | 按季度 |
| 知识 | 规格书、事故复盘、操作手册 | 业务专家 | 业务专家 + 自动挖掘 | 按周 |
| 记忆 | 用户偏好、上次的结论 | 无 | Agent | 每次会话 |
| 轨迹 | 每次模型调用、工具调用、token、成本 | 无 | 系统自动 | 每一步 |
| 评估 | 测试集、线上打分 | 算法团队 | 系统 + 模型评审 | 持续 |
9 月那一轮产品主要处理前两行:把人写好的定义和知识,用一致的方式交给 Agent。上下文是只读的参考资料。
这一周的产品,重心移到了后三行,而且连前两行也开始接受机器写入:
- Google 的 Knowledge Catalog 会持续从 Workspace、GitHub、Jira、Confluence、SharePoint 里挖内容,“从用户意图以及每一次人和 Agent 的交互中学习”,自动补齐上下文缺口;
- Snowflake 的 Cortex Sense 会根据使用情况提议新定义;
- Redis 的 Agent Playbooks 会把“稳定的答案”沉淀下来复用,官方说法是“跑得越多,越完整、越准确”。
于是上下文的性质变了:它不再是一本由人编、给机器查的参考书,而是一本每次运行都会追加记录的账本。读路径一次设计好就够了,写路径却需要回答一串新问题:写到哪、谁来批、怎么删、能不能带走。
二、五家的写回路径:写什么、落在哪、谁批准
把五家的发布拆开,按“写回什么、落在哪里、由谁把关”来看。
Snowflake:轨迹写进客户自己的表,定义由人批准
Snowflake 这次最值得注意的一句话在可观测性部分:每一次模型调用、工具调用、推理步骤和护栏判断,都写进客户自己账号里受治理的表,“可以用标准 SQL 查询,并与业务的其他数据 join”。
紧接着的产品 Agent Trace Intelligence(私有预览),就是用这个 join 去发现三类问题:在循环里空烧钱的 Agent、反复失败的工具,以及每完成一个任务的真实成本。
定义这一侧,Snowflake 的设计很保守:
- Cortex Sense 可以提议定义,但概念的负责人批准后才算正式;
- 导入外部词汇表时,每一条都先标成草稿,走数据管理员的审批流程;
- 模型推断和已批准的定义冲突时,Agent 用已批准的那一条;
- 有意的差异,比如同一指标在不同区域口径不同,保留为多个已批准版本,并标明适用的地点和时间。
记忆则交给用户自己管:CoCo 和 CoWork 的记忆可以随时查看、修改、删除。自动化任务每跑一次都留下一份运行记录,以创建者的权限执行,并受预设配额限制。
Google:机器补全上下文,人在工作台里审
Google 的 Knowledge Catalog 让 Agent 承担“上下文策展的重活”:从各类非结构化来源里挖掘,打包成可复用的 OKF(Open Knowledge Format)上下文集。
人的位置在一个新的工作台里:数据管理员在这里审阅、审计、批准拟议的补全,并且有完整的版本记录和回滚。
Google 给了一组内部基准数字:Knowledge Catalog 让 Agent 准确率提升近 4 倍,延迟最多降低 33%,token 最多减少 75%。注意,这是厂商自测,对照组怎么设的没有说明。
基础设施这一侧,面向 Agent 的 AlloyDB 号称支持数千个协作 Agent 查询实时交易数据,负载完全隔离,超过 300 万 QPS。一个细节很说明问题:计算资源按“活跃推理会话”数量自动伸缩,空闲时缩到零。数据库的计量单位开始从“连接”变成“会话”。
PhoenixAI:五种上下文和业务数据放在同一个集群
PhoenixAI 的 Contextbase 是这一周最激进的设计。它的诊断是:
今天大多数技术栈里,这些东西散落在不同工具里:定义在语义层,文档在向量库,记忆在记忆服务,轨迹和评估在可观测性工具。每个工具各存一份副本,各有一套权限。
它的解法是把语义、知识、记忆、轨迹、评估全部放进同一个数据库,而且就放在业务数据所在的同一个集群上,“一条查询就能触达全部内容,用同一套权限”。所有记录都带链接和版本,并且“按写入时的样子保存”。
围绕它做的第一个应用 ObserveStack,用来追踪和评估 Agent,读的是 Agent 自己读的同一个库。
这句话背后的逻辑是:Agent 是系统里不确定的那一部分,所以它读写的地方必须是确定的。Contextbase 目前是私有预览,还没有公开的效果数据。
Redis:热路径上的记忆、路由和固定答案
Redis 的定位是“运行时”。CEO 的说法很直接:Redis 已经在应用的热路径上,开发者不应该需要五个基础设施产品才能让 Agent 跑起来。
Iris 的六个组件里,和写回关系最密切的是三个:
- Agent Memory(GA):从用户行为、文档和半结构化数据里构建记忆,分层组织,带查看、审计和来源追溯,还能主动遗忘不该保留的内容,比如个人身份信息;
- Agent Playbooks(GA):由团队定义哪些答案是稳定的、可以复用,哪些必须查最新数据、重新跑一遍流程;
- Lens(beta):每个结果都能追溯到服务它的技能、路由或固定答案,以及它学自哪条记忆、来自哪个会话。
Eon:在写入那一刻生成上下文
Eon 的切入点最靠上游。Yukon 在流数据写入时,同一趟处理里更新明细表和聚合表,同时生成上下文:列统计、数据变化、结合业务定义写的描述,再通过 MCP 交给 Agent。
数据本身以开放的 Iceberg 表写进客户自己的对象存储,其他引擎也能读。性能数字同样是自测:写入基准中比 Spark 和 Flink 少用 4 到 7 倍算力;在客户 Rise 一小时生产流量的回放里,保持 60 秒新鲜度,机器比 Flink 少 85%、比 Spark 少 88% 以上。
放在一起看
| 主要写回什么 | 落在哪 | 谁把关 | |
|---|---|---|---|
| Snowflake | 轨迹、记忆、定义提议、运行记录 | 客户账号内的表(遥测存为 Iceberg) | 概念负责人审批定义,用户管理记忆 |
| 自动挖掘的上下文补全 | Knowledge Catalog(OKF 上下文集) | 数据管理员在工作台审批,可回滚 | |
| PhoenixAI | 语义、知识、记忆、轨迹、评估全部 | 与业务数据同一集群 | 统一权限与版本,审批机制未详述 |
| Redis | 记忆、固定答案、路由结果 | 运行时内存层 | 团队定义固定答案范围,记忆可遗忘 |
| Eon | 写入时生成的统计与描述 | 客户对象存储(Iceberg) | 基于业务定义自动生成 |
三、为什么偏偏是数据库厂商
模型厂商也在接写回。OpenAI 的 Agents API(beta)会在服务端保存会话状态,包括 Agent 配置、对话历史和已完成的工作,并且默认在后台做上下文压缩。
所以这场争夺不只发生在数据厂商之间,而是两个阵营在抢同一条写路径:
- 模型侧:会话、记忆、压缩,放在模型 API 后面;
- 数据侧:轨迹、评估、定义,放在业务数据旁边。
数据库厂商的底气,来自一个模型厂商很难复制的位置:它们手里有业务结果。
复利需要一个 join
把“复利”拆成一个具体的循环:
- Agent 运行,读上下文,做事;
- 运行留下轨迹:调了什么、花了多少;
- 评估这次运行:做对了没有;
- 把好的经验沉淀成记忆、固定答案或定义提议;
- 人审批后,变成正式上下文,供下一次运行使用。
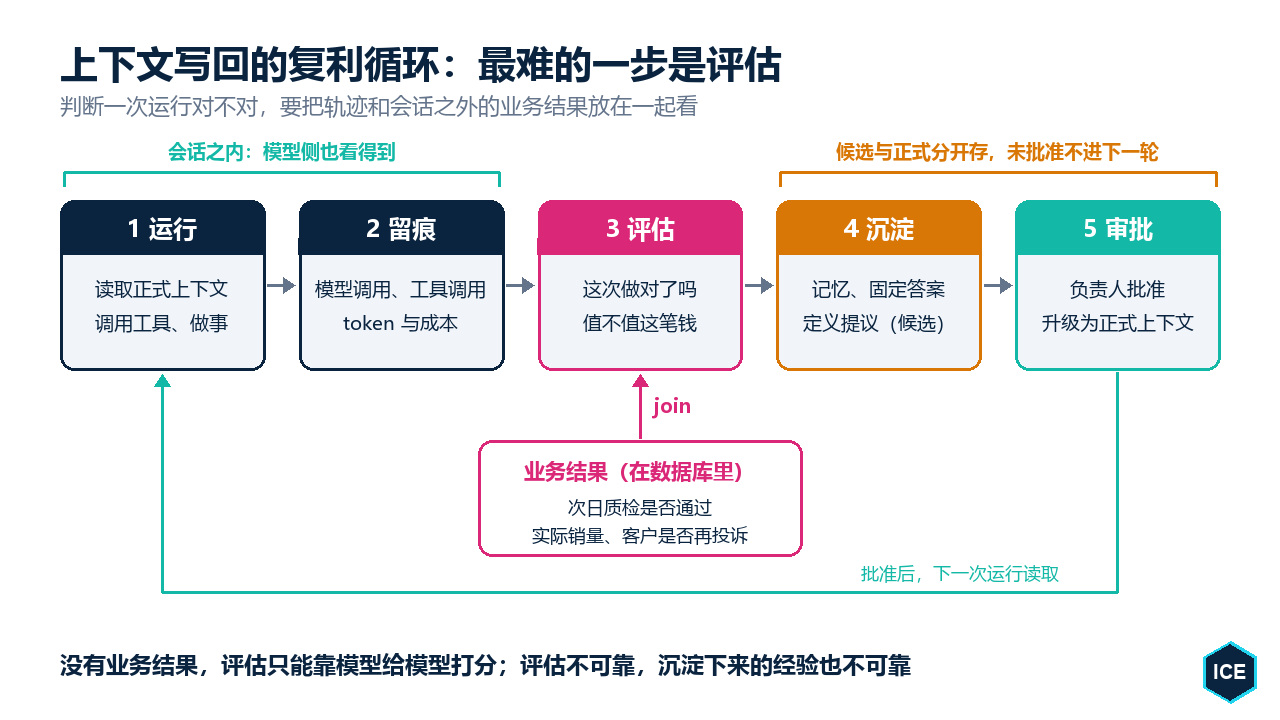
整个循环里最难的是第 3 步。Agent 自己说“已完成”不算数,我们在《操作回执》里刚讨论过:Agent 说改了 1 行,数据库实际改了 301 行。
要判断一次运行到底对不对、值不值,需要把轨迹和业务结果放在一起看:
- 这次自动修好的管道,第二天的数据质量检查通过了吗?
- Agent 推荐的补货量,后来的实际销量对得上吗?
- 这个客服会话结束后,客户有没有再打电话投诉?
这些结果都躺在业务库里。Snowflake 的“每完成一个任务的真实成本”,PhoenixAI 的“用 Agent 读的同一个库来评估”,本质都是这个 join。
模型厂商能看到会话里发生了什么,但看不到会话之外的业务世界后来怎么样了。没有结果,评估只能靠模型给模型打分;评估不可靠,沉淀下来的经验就不可靠,复利也就无从谈起。
另外两个现实理由
一套权限。 记忆和轨迹里全是业务数据的片段,客户名、订单号、金额。放在独立的记忆服务或可观测性工具里,就要再维护一套权限,并且和业务库的权限保持同步。放在业务数据旁边,可以直接继承已有的行级安全和列权限。PhoenixAI 和 Snowflake 都把这一点放在显眼位置。
版本和事务。 定义需要版本号和回滚,记忆需要可审计的修改历史,轨迹需要按写入时的样子保存、不被事后改写。这些恰好是数据库几十年来最擅长的事。
四、复利的另一面:错误也会复利
复利是双向的。一个系统如果能把对的经验越积越多,也能把错的东西越积越牢。这一节讨论写回带来的四个新问题。
问题一:错误答案会被“沉淀”
Redis 的 Agent Playbooks 让团队决定哪些答案稳定、可以直接复用。这能省下大量 token,但也意味着:一个错误答案一旦被认定为“稳定”,之后每一次命中都会原样返回,不再经过模型推理,也就不再有被纠正的机会。
记忆也一样。如果 Agent 把自己的一次错误判断写进记忆,比如“这个客户偏好月结”,下一次会话它会把这条记忆当作事实。我们在《别信 agent 说的“我读完了”》里讨论过,Agent 的自我报告不是证据。现在的问题更进一步:自我报告被写进了下一次运行的上下文。
所以写回链路上至少要区分两种记录:
- 观察到的事实:来自系统自身的记录,比如数据库变更日志、业务结果;
- Agent 的结论:模型推断出来的东西,需要标明来源,并且默认是“候选”而不是“正式”。
问题二:审批会成为瓶颈
Snowflake 和 Google 都选择了“机器提议、人来批准”。这是对的,但会立刻带来一个容量问题。
过去,数据字典一个季度改几十条,数据管理员审得过来。现在,自学习系统从每一次人和 Agent 的交互里挖候选,候选的数量会是过去的几十上百倍。
结果可能有两种:要么审批积压,系统的“自学习”名存实亡;要么审批流于形式,一键全部通过,机器写的上下文实际上没人看过。
这里真正稀缺的不是生成候选的能力,而是批准候选的人。 这和我们在《核验才是稀缺能力》里的判断是同一件事在数据治理上的投影。可行的办法是分级:影响财务口径的定义必须人审,低风险的描述性补全可以抽检。
问题三:遗忘比记住难
这一周的发布里,能删除被放在了显眼位置:Redis 的记忆能主动遗忘个人身份信息,Snowflake 的用户可以随时删除自己的记忆。
但写回的东西不只有记忆。一个客户要求删除个人数据时,需要找到所有地方:
- 记忆里有没有提到他;
- 轨迹里有没有他的订单号;
- 评估测试集里有没有用他的真实对话;
- 被沉淀下来的固定答案里,有没有基于他的数据。
上下文集中在一个库里,这件事反而好做;散在五个工具里,几乎做不干净。这是“放在一起”的一个被低估的好处。
模型侧的情况可以作为对照:OpenAI 的 Agents API 目前只支持美国的数据驻留,也不支持零数据保留(ZDR),即使用自托管沙箱也一样。对有数据出境和留存要求的企业,这一条就决定了会话状态不能放在模型 API 后面。
问题四:数据能带走,上下文未必
过去几年,Iceberg 这类开放表格式把数据层的锁打开了。这一周也能看到这个趋势在延续:Eon 写的是客户存储里的 Iceberg 表;Google 支持和 Databricks、Snowflake、AWS Glue 的 Iceberg 目录联邦;Snowflake 的 Agent 遥测用 OpenTelemetry 采集、存在 Iceberg 表里。
但把写回的东西逐项看,可携带程度差别很大:
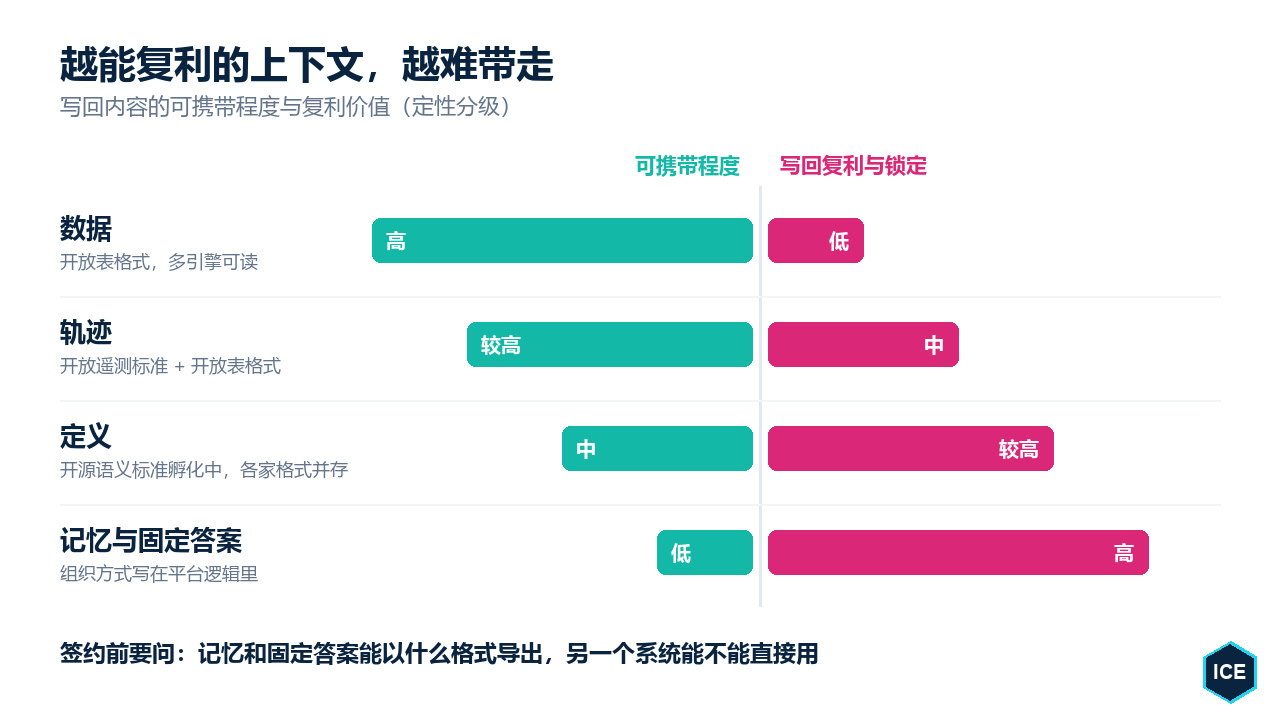
- 数据:Iceberg 已是事实标准,基本能带走;
- 轨迹:OpenTelemetry 加 Iceberg,格式开放,带走后能读;
- 定义:Snowflake 提到语义层的开源项目 Apache Ossie(孵化中),Google 推 OKF,标准正在形成,但还没有统一;
- 记忆和固定答案:每家的组织方式都不同,分层结构、路由规则、复用条件都写在平台逻辑里,导出了也很难被另一个系统直接使用。
这和我们在《持续学习》里的判断一致:越容易带走的部分,越不构成护城河。 厂商真正想留住的,正是最难带走的那部分:被反复验证过的记忆和固定答案。它们是复利最多的资产,也是迁移时损失最大的资产。
五、这对我们意味着什么
对数据工程师:先设计写路径,再选产品
在评估任何上下文产品之前,先画出你自己的写回链路,回答四个问题:
- Agent 会写回哪几类东西?记忆、轨迹、评估、定义提议,哪些需要?
- 每一类写到哪里?和业务数据是否在同一套权限之下?
- 哪些写入需要人批准?批准人是谁,每周能批多少条?
- 用户要求删除时,能不能在所有写回位置里找到并删干净?
这四个问题有答案了,产品选型反而简单:它只是你这条链路的一个实现。
对 Agent 平台设计者:候选与正式要分开存
写回的东西默认都是候选。被批准、被业务结果验证过的,才升级为正式上下文,供下一次运行读取。
两者混在一起,是错误复利最主要的来源。可以借鉴 Snowflake 的做法:模型推断和已批准定义冲突时,永远以已批准的为准。
对采购和架构负责人:签约前问“导出”
对每一个上下文功能,问一句:如果我们明年离开,记忆和固定答案能以什么格式带走,带走后另一个系统能不能直接用?
如果答案是“数据可以带走,其他的不行”,那你买到的就是一份会持续加深的锁定,只是界面更友好。
小结
- 这一轮争的是写路径。 9 月的上下文层产品解决“定义怎么交给 Agent”;11 月这一批的重点是 Agent 运行留下的记忆、轨迹、评估和定义提议写到哪里、谁来批准。
- 数据库厂商的优势在于手里有业务结果。 复利循环里最难的是评估,评估需要把轨迹和业务结果 join 在一起,而业务结果在数据库里,不在模型 API 后面。
- 错误也会复利。 被沉淀的错误答案、被写进记忆的错误判断,会在之后每一次运行里原样复现。写回内容要区分“观察到的事实”和“Agent 的结论”,候选与正式分开存。
- 审批和删除是新瓶颈。 机器提议的速度远超人批准的速度;写回的位置越分散,删除越做不干净。
- 越能复利的资产,越难带走。 数据和轨迹已有开放格式,记忆和固定答案仍然绑定在平台里。
最后留一个问题:你的 Agent 上周写回的东西里,有多少条被人看过?
本文部分内容由 AI 辅助生成,经人工审校和补充后发布。
参考资料
- Snowflake. "Snowflake Delivers the Foundation for Autonomous Data Engineering, Powering the Agentic Enterprise with Trusted, Live Data." Business Wire, 2026-11-03. https://www.snowflake.com/en/news/press-releases/expedition-2026-autonomous-data-engineering/
- Snowflake. "Snowflake CoCo and CoWork Power the Agentic Enterprise." 2026-11-03. https://www.snowflake.com/en/news/press-releases/expedition-2026-coco-cowork/
- Nick El-Rayess et al. "Build Trust in AI Agents with Governed Business Context and AI Security." Snowflake Blog, 2026-11-03. https://www.snowflake.com/en/blog/ai-agents-governance-ai-security-cost-control/
- Snowflake. "Build Faster, Work Smarter with AI Agents and Apps Grounded in Data." Snowflake Blog, 2026-11-03. https://www.snowflake.com/en/blog/ai-agents-governed-data-business-context/
- Sirish Chandrasekaran, Raj Pai. "What's new across Google's Agentic Data Cloud." Google Cloud Blog, 2026-11-04. https://cloud.google.com/blog/products/databases/whats-new-across-googles-agentic-data-cloud
- PhoenixAI. "PhoenixAI Launches Contextbase, the Context Infrastructure for AI Agents." 2026-11-04. https://www.phoenixdata.ai/newsroom/phoenixai-launches-contextbase-the-context-infrastructure-for-ai-agents
- Redis. "Redis Expands Redis Iris to Give AI Agents the Memory, Context, and Messaging They Need to get to Production." 2026-11-04. https://redis.io/press/redis-expands-redis-iris-to-give-ai-agents-the-memory-context-and-messaging-they-need-to-get-to-production/
- Eon. "Eon Launches High-Performance AI Data Layer With Less Infrastructure." GlobeNewswire, 2026-11-05. https://www.globenewswire.com/news-release/2026/11/05/3396659/0/en/eon-launches-high-performance-ai-data-layer-with-less-infrastructure.html
- OpenAI. "Agents API." OpenAI Developers. https://developers.openai.com/api/docs/guides/agents-api/overview
- OpenAI Help Center. "Agents API (beta) FAQ." https://help.openai.com/en/articles/20001551-agents-api-beta-faq