AI 原生研发(上·机制篇):把 agent 接进流程,十三家公司在用的那些机制
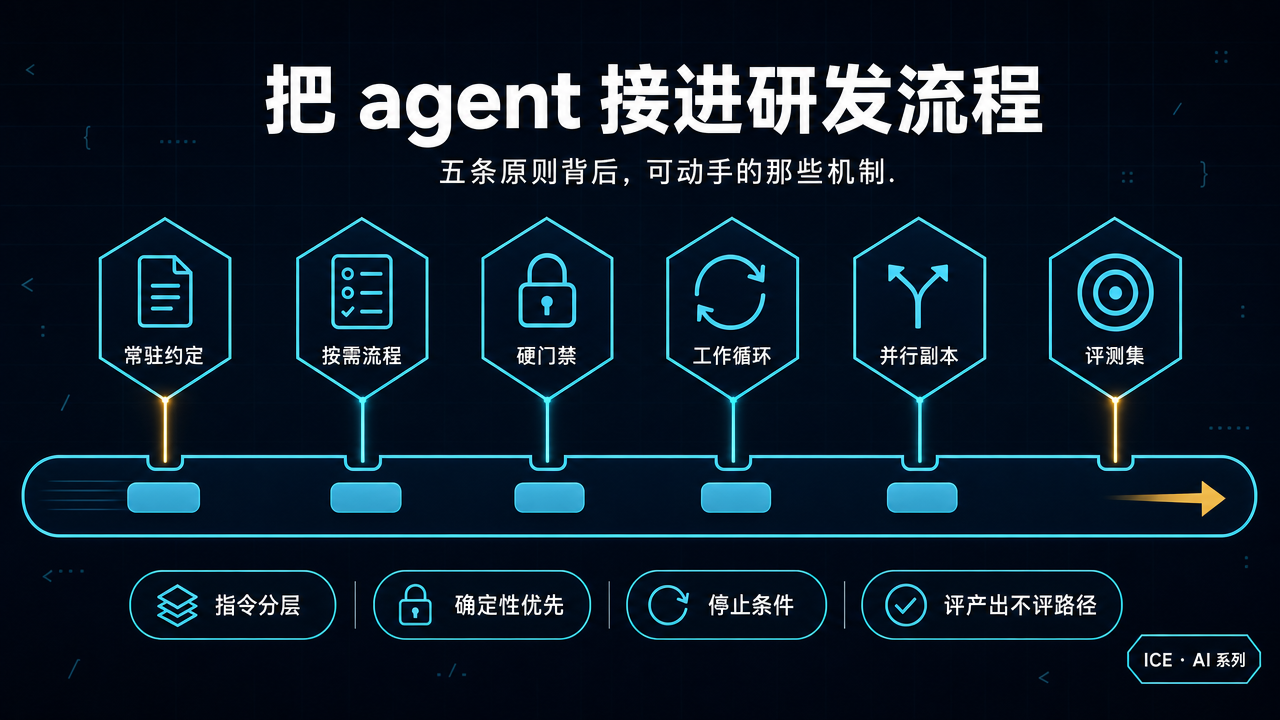
8 月 20 日 Anthropic 发了一份《The Claude Code guide for startups》,作者是 Michael Segner。样本是十三家高速增长的创业公司——从数据库(ClickHouse)到法律(Crosby)、临床记录(Heidi)、医疗编码(Cainex)、居家护理(Zingage)都有——归纳出五条运营原则,另配了 PDF 版和一份结尾 checklist。
先消一个歧义,因为这两份东西经常被混着提:它不是五月那本 36 页的《创始人手册》(The Founder's Playbook)。那本讲创业的四个阶段,是给创始人看的路线图;这份讲十三家公司具体怎么干活,是给工程团队看的操作手册。
五条原则是这样:
| 原则 | 一句话 |
|---|---|
| Everyone ships | 懂问题的人自己出第一版 |
| Automate the tedium | agent 吃掉机械的那部分,人留在需要判断的地方 |
| Trust, but verify | 能自动确认多少,才敢自动化多少 |
| Build for rebuilding | 模型能力在变,别把任何东西当永久资产 |
| Prototype, dogfood, productionize | 先做内部 agent,自己用,再变成产品 |
这五条转得很广,但说实话,光看这五条你回到自己的仓库里并不知道该改哪个文件。真正能照着动手的东西,夹在正文里那十来个 Tip 框:指令该放 CLAUDE.md 还是 skills 还是 hooks、什么时候值得接 MCP、评审和 CI 值班怎么交出去、第一个 agent loop 该选什么活、评测什么时候必须建、重建怎么变便宜。
所以这篇就干一件事:把这些机制收拢成一份能动手的清单,顺着原文的引用把两篇相关文档也补进来,最后把原文那份 checklist 整理成中文。
一、先把“指令放哪”这件事分清楚
材料里 CLAUDE.md 和 skills 反复出现,但没讲清两者的分工。这件事在六月那篇《Steering Claude Code》里有完整框架:Claude Code 一共有七种下指令的方式,每一种控制的都是同样三个变量——什么时候载入上下文、压缩之后是否还在、带多大约束力。
| 方式 | 什么时候载入 | 压缩之后 | 上下文成本 | 适合放什么 |
|---|---|---|---|---|
| 根 CLAUDE.md | 会话开始,全程驻留 | 重新读取 | 高,每行都占 token | 构建命令、目录结构、编码约定、团队规范 |
| 子目录 CLAUDE.md | 读到该目录下的文件时 | 掉了,直到再次触及 | 低 | 只属于这个目录的约定 |
| rules | 用户级的在会话开始;限定路径的在命中文件时 | 重新注入 | 中,不限定路径就是常驻 | 具体约束,如所有 API handler 必须先校验入参 |
| skills | 开始时只载入名字和描述,正文在被调用时才载入 | 按共享预算重新注入,最旧的先掉 | 低 | 流程性工作流,如部署、发布检查单 |
| subagents | 开始时载入名字、描述和工具表,正文经 Agent 工具调用才载入 | 只有最终消息回到主会话 | 低,调用前为零 | 并行或需要隔离的旁支任务,如深度检索、日志分析、依赖审计 |
| hooks | 在生命周期事件上触发 | 完全绕过压缩 | 低,配置在上下文之外 | 确定性动作:跑 lint、完成时发 Slack、拦命令 |
| output styles | 会话开始,注入系统提示 | 从不压缩 | 高,会覆盖默认系统提示 | 角色级改变,慎用 |
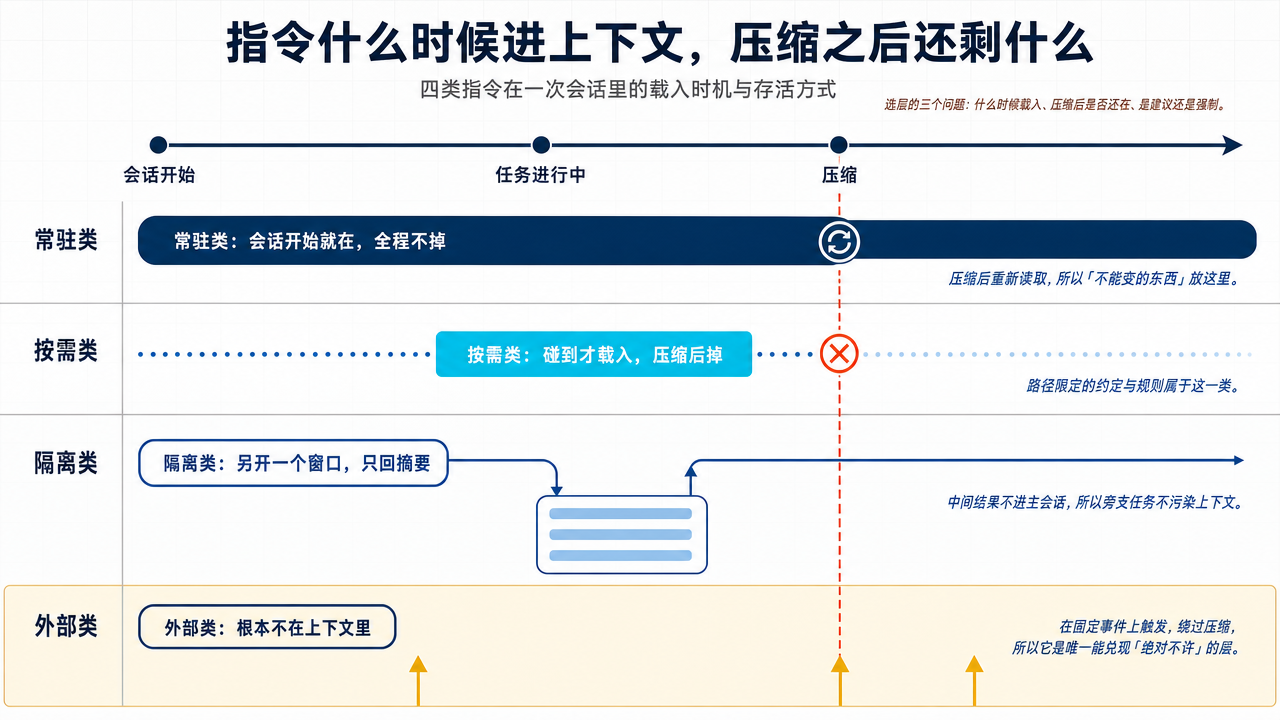
这张表最实用的用法不是查,而是拿去对照你现在写在 CLAUDE.md 里的东西。原文列了四种典型错放,我看每一条都很常见:
“每次 X 都要 Y”写在 CLAUDE.md 里。 这该用 hook。原话说得很准:模型选择去跑 formatter,和 formatter 自动跑,是两件不同的事。
“绝对不许做 X”写在 CLAUDE.md 里。 这是最危险的一种。写在提示里的规则,模型大部分时候会遵守,但在长会话、模糊情境,或者任务中读到的某个文件里藏了注入的时候,它会失守。真护栏必须是确定性的,手段只有 hooks 和 permissions——一个 PreToolUse hook 可以检查任何工具调用,返回退出码 2 就把它拦下。要做组织级的硬约束,还得用管理端下发的 managed settings,用户本地配置改不动。
三十行的流程写在 CLAUDE.md 里。 流程属于 skills。CLAUDE.md 放的是 Claude 每次都该知道的事实,部署手册和安全评审清单该待在 .claude/skills/ 里,正文只在被调用时载入。
只管 src/api/** 的规则却不写 paths。 不限定路径的 rule,机制上等同于把内容写进 CLAUDE.md——永远载入,永远占 token。
还有一条约束值得单独抄下来:CLAUDE.md 控制在 200 行以内,指定一个 owner,改动像代码一样评审。 原因是共享仓库里的 CLAUDE.md 会像任何没主的配置文件一样长:每个团队往里加自己的规则,没人删。而每一行都会载入每位工程师的每次会话,不管跟他手上的活有没有关系,既烧 token 又稀释了真正重要的那几条的遵守度。文件一大就该往下拆——团队约定推进限定路径的 rules,流程推进 skills。
这套分层做对之后的收益,Parahelp 联合创始人 Mads Lunau Liechti 描述得最直接:不只工程师产出变多,“像我这样的非技术的人,也突然开始发 UI 改动和产品改进了”。原文还建议再往上搭一层——建一个公司内的插件市场,把 skills、subagents、hooks 打成包,让一个人调好的实践能整包传给另一个人,而不是靠口头交接。至于这份共享上下文长大之后会遇到什么问题、维护到什么程度就够了,下篇里 Emergent 那段说得比我清楚。
二、让 Claude 看得见:接 MCP 还是直接用 CLI
原文有一句判断规则很好用:Claude 看不见的东西就理解不了。 所以只要你发现团队在从某个系统里复制粘贴信息到 Claude,那就是该接连接器的信号——这个动作本身就是需求。
但接的方式有两种,原文给的取舍标准是具体的:如果已经存在成熟的命令行工具(gh、kubectl、bq、psql 这类),走 CLI 通常比 MCP 更省 token,而且有个额外好处——Claude 拿到的和你的工程师拿到的是同一份 ground truth,不存在两套口径。反过来,需要接的是数据库、内部 API 或者没有 CLI 的 SaaS,那就上 MCP。
顺序上我建议先做 CLI 那一批,因为几乎零成本:给 agent 授权跑 gh pr list 和 psql 查询,比搭一个 MCP server 快得多,收益立刻可见。
三、把评审和值班先交出去
这是我认为最该先动手的部分,因为它不改产品代码,只改流程,出问题也容易回退。
材料里点到的第一个是 Code Review(研究预览阶段):一个托管的多 agent 服务,在你启用的仓库上对 PR 自动过一遍评审,每条发现按严重级别打标。闭环有两种方式——人工改完推上去,或者在那条发现下面评论 @Claude 让它自己收尾(需要配好 GitHub Actions)。
第二个是 Claude Tag(公开测试阶段),做 CI/CD 值班的第一响应和 bug 分诊。Anthropic 自己的部署形态写得很细,可以直接照抄:Claude Tag 有独立的服务账号,能访问一个 CI 工程师需要的工具比如 Datadog 和 Grafana;它的常驻指令是 markdown 形式的 skills,提交在 GitHub 仓库里,这样多个同事可以一起迭代,变更管理跟代码一样。它在 Slack 里接起值班话题,进度就在频道内汇报。
访谈里几家的自建版本可以当选型参考。Heidi 把自动评审对齐到自己的技术与合规框架上,标出关键问题、把建议改动路由给对应的评审人。Translucent 创始人 Jack O'Hara 最得意的是他们那个“Translucent code reviewer”:它在一次变更上扇开、从多个角度分别评审,再把结果综合起来——像他们的资深工程师会做的那样,但比任何一个人都快。Clay 则做了一个从初判到给出修复代码建议的 bug 分诊 agent。
扇出这件事有个具体说法值得记住:原文说用 Claude Opus 或 Claude Fable 这类模型时,直接讲“fan out multiple subagents”或者“use a workflow”,就能让它并行分析大量数据,或者对另一个 agent 的产出做对抗式评审。这个能力的天花板比大多数人以为的高——按《Steering Claude Code》的说法,subagents 可以嵌套五层,而 dynamic workflows 能编排几十到上百个后台 agent,编排计划和中间结果存在脚本变量里而不是 Claude 的上下文窗口里,所以规模上去了指令保真度也不掉。
四、第一个 loop,选一件有停止条件的活
loops 是原文给的一个概念:重复执行工作循环,直到停止条件满足。 用 skills 定义达标的判定标准,越明确越好,然后让 agent 自己迭代到达标。
材料里举的例子是修 flaky test 的 agent,理由说得很干脆:停止条件清晰且自足——把测试重跑到通过就是通过,agent 可以自己验证自己,不需要人来判定。
这就是选第一个 loop 的标准。对照一下就会发现,“实现一个新功能”之所以不适合当第一个交出去的活,不是因为难,而是因为它的完成判定在人的脑子里。而下面这些活,判定都在机器里:flaky test、缺失的测试覆盖、已经全量放开却没清掉的 feature flag、依赖升级、格式与 lint 违例、值班的第一份情况报告。
顺带一个搭配技巧:hooks 和 skills 是设计 agent loop 的基础构件——skills 定义循环里每一步做什么,hooks 保证某些步骤一定发生。
五、评测:什么时候从“手感”切到“数字”
原文有一段把这个时机描述得很准。团队刚开始建 agent 的时候,靠手工测试、自己天天用、加上直觉,其实能走很远。断点通常是这样到来的:用户开始反馈说改完之后 agent 变差了,而团队没有任何办法验证,只能靠猜。 具体表现是三件事做不到——分不清真回归和噪声、没法在上线前把改动跑过几百个场景、没法量化改进。
这一段原文指向了一月那篇《Demystifying evals for AI agents》,那篇给了可执行的起点,值得一起看。
最反常识的一条是不要等完美套件:很多团队推迟建评测是以为需要几百个任务,实际上从真实失败里取 20 到 50 个简单任务就是个很好的开始。早期每一次改动的效应量都很大,小样本足够检测得出来;等 agent 成熟了才需要更大更难的集合。而且它给了一个越晚越贵的理由:早期产品需求天然就能翻译成测试用例,等太久你就是在从一个活着的系统里反推成功标准。
评分器要混着用:
| 类型 | 判什么 | 注意 |
|---|---|---|
| 代码型 | 结果确定、可程序化判定的 | 最便宜,优先用 |
| 模型型 | 需要语义判断、没有唯一正确答案的 | 要定期用人工校准这个 judge |
| 人工型 | 校准前两类,兜住模糊边界 | 贵,但不能完全不用 |
还有一条容易踩的坑:别去检查工具调用序列。 原文的经验是这样太死了,agent 经常会找到设计者没想到但同样有效的路径。要评的是它产出了什么,不是它走的哪条路。
最后是两个指标的区别,选错了会得出相反结论。pass@k 衡量的是 k 次尝试里至少成功一次的概率,k 越大越高;pass^k 是 k 次全部成功的概率,k 越大越低。k=1 时两者相同,都等于单次成功率;到 k=10 就讲着完全相反的故事——一个趋近 100%,一个趋近 0%。选哪个看产品要求:一次成功就够的工具用 pass@k,用户每次都指望它靠谱的面客 agent 用 pass^k。举个原文的算例,单次成功率 75% 的 agent 跑三次,三次全对的概率是 0.75³ ≈ 42%。
六、让重建变便宜:worktree、plan mode 和硬门禁
材料里“建四遍”这种说法之所以不是空话,是因为有具体机制让重建的成本降下来。
第一个是 git worktree。一个仓库、一份 .git 对象库,可以挂多个工作目录,每个目录检出自己的分支。于是 v2 在一份隔离的副本里重建,v1 完全不动照常跑,你对两边跑同一套评测,赢了才合。Claude Code 可以帮你直接开一个。
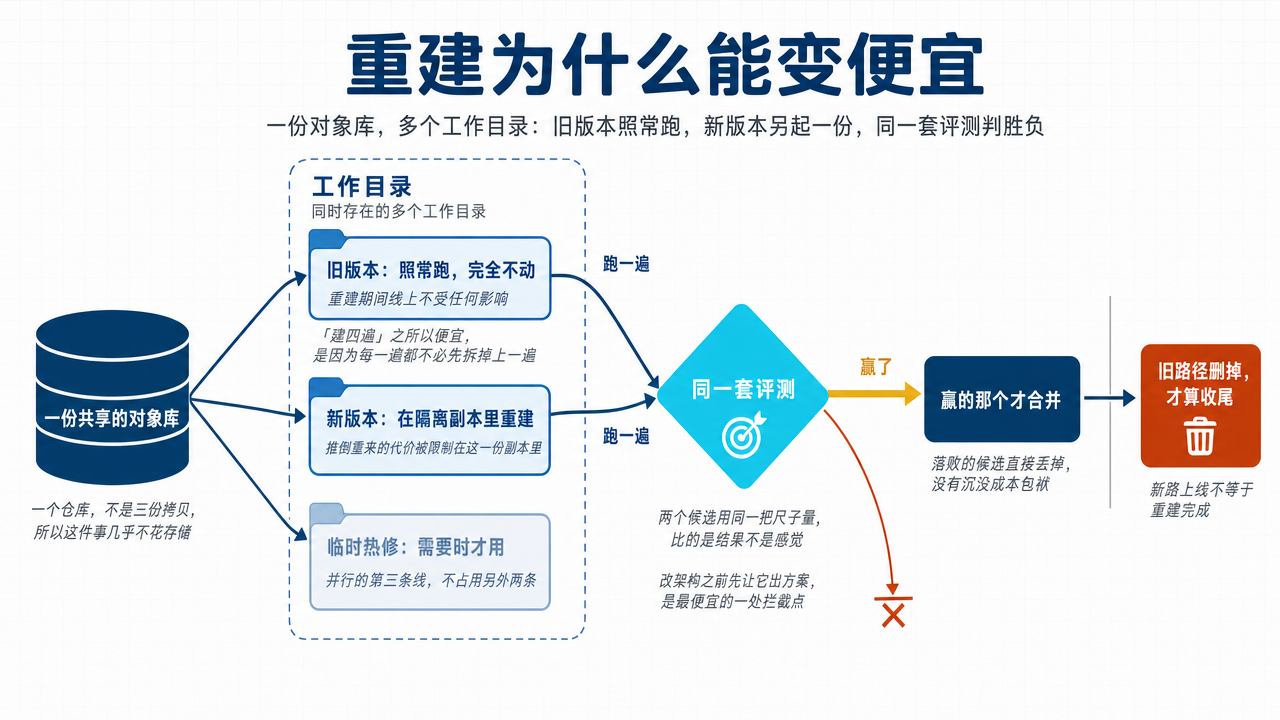
第二个是 plan mode(--plan 或者按 Shift+Tab;原文正文写的是 --plan,结尾 checklist 里写成了 /plan,以文档为准)。非平凡的重写就从这里起步:Claude 先探索代码库、提出重建方案,你批准或者掰回来,它才开始写代码。原文的说法是这是“最便宜的一处拦截点”——一个即将偏离架构的重建,在这里被发现的成本最低。
跟 plan mode 配套的还有两条更早的经验,来自去年 11 月 Anthropic 访 YC 公司那篇。一条是 Ambral 的 Jack Stettner 把研究、规划、实现拆成三个独立会话,只把提炼过的结论往下传,而不是把整段上下文历史一路拖着走;他的原话是“不要让 Claude 一边研究一边规划一边实现”。另一条来自 Vulcan 的 Tanner Jones:盯着它的思维链,手放在中断键上——在前几次工具调用里就把方向拧回来,比让它跑完一整条错路省得多,同时开多个实例的时候尤其如此。
这三样其实是同一件事的三个粒度:会话拆分防上下文污染,plan mode 防架构漂移,及早中断防沉没成本。都不花钱,见效都快。
第三个是长任务的收口。/goal 用在那种 Claude 容易提前宣布完工、评审时偏好自己的发现、或者跑着跑着偏离原目标的复杂任务上。
最后是 hooks 作为硬门禁的三个具体例子,都可以今天就加:lint 不过不许写入、测试不过不许提交、任何东西离开沙箱之前先把密钥剥掉。这类约束的价值在于它每次都执行,跟模型当时怎么判断无关。
七、原文那份 checklist,加上漏掉的第五章
原文结尾把每章的技术要点收成了一页 checklist,但只列到第四章,第五章没了。整理成中文并补齐是这样:
第一章 · 人人都能发版
- Claude 看不见的东西就理解不了:把每天在用的工具和事实来源通过 MCP 或 CLI 接进来。
- 建一个公司内的插件市场,让一个人的最佳实践能以 skill 的形式立刻传给另一个人。
- 各子目录的 CLAUDE.md 放该目录专属、每次都适用的编码约定;按需触发的流程性工作流放 skills。
第二章 · 自动化机械部分
- 在一个仓库上开启 Code Review(研究预览),让 PR 自动过一遍评审。
- 把 Claude Tag(公开测试)接进 CI/CD 的值班响应和 bug 分诊。
- 需要并行分析大量数据、或者对另一个 agent 的产出做对抗式评审时,用 dynamic workflows 扇出多个子 agent。
第三章 · 信任,但要验证
- 不能变的东西放仓库根的 CLAUDE.md。
- 需要更自主或长周期的工作,用 loops——重复到停止条件满足为止。
- 建立创建和维护 agent 评测的流程。
- 工作里必须确定性的部分交给 hooks,它在生命周期固定点触发,可以当硬门禁。
第四章 · 为重建而建
- 用 git worktree 在隔离副本里跑重建,当前版本完全不动——这就是“建四遍”变便宜的原因。
- 非平凡的重写先进 plan mode(
/plan或 Shift+Tab),让 Claude 先探索代码库并提出方案,你批准或掰回来。
第五章 · 原型、自用、产品化(原文缺,按正文补)
- 内部 agent 先用 Claude Code 搭起来,团队自己用一段时间,视反馈再决定是否提升为对外产品,通常走 Claude API、Agent SDK 或 Managed Agents。
- 做产品时借鉴上游 harness 的取舍。Omni 联合创始人兼 CTO Chris Merrick 说他们参考了“文件优于 embedding”的思路,因此有底气在自己产品里保持简单,绕开了一整套 RAG 管线本会带来的复杂度;他们也把 Claude Code 让用户并行推进任务的那套 harness 概念搬进了自己的 UI。
- 让自己的产品和自己的开发环境用同一代模型。Emergent 的 Mukund Jha 提到,因为他们的 app builder 背后也是 Anthropic 的模型,所以线上一出现异常,本地用 Claude Code 就能很快判断这是模型行为还是 harness 问题,分诊周期因此明显缩短。
结论
如果要给一个从零开始的顺序,我会这么排:
- 先加 hooks。 成本最低、收益立刻可见,而且它是唯一能真正兑现“绝对不许”的手段。lint 门禁、测试门禁、剥密钥,今天就能加。
- 再收拾 CLAUDE.md。 按 200 行的上限砍一遍,流程移进 skills,路径专属的约束移进带
paths的 rules,给这个文件指定一个 owner。 - 然后挑第一个 loop。 选一件停止条件在机器里而不在人脑里的活,flaky test 是标准答案。
- 跑顺了再建评测。 从真实失败里取 20 到 50 个任务起步,混用代码型和模型型评分器,评产出不评路径,按产品要求决定看 pass@k 还是 pass^k。
- 最后才谈重建和放权。 worktree 加 plan mode 让重建变便宜;非技术同事发版这件事放在最后,因为它依赖前面所有门禁都已经就位。
这个顺序的逻辑是一条:每一步都在为下一步准备验证能力。 门禁到位了才敢交 loop,loop 跑顺了才有数据建评测,评测立起来了才敢让人往仓库里推自己不完全懂的代码。反过来做,每一步都会变成一次事故。
但这份清单里有一件事我故意没解释:为什么这十三家公司花最大力气的地方,几乎都不是“写代码”,而是验证和删除这两件过去永远排不上优先级的活?这不是工具清单能回答的问题,它关系到增益究竟来自哪里——如果答错了,上面这五步的顺序也会排错。
下篇:《AI 原生研发(下·判断篇):真实瓶颈不是写,是验证和删除》——四个自报指标各自在衡量什么、增益为什么来自转手次数而不是打字速度、“删”怎么成了新瓶颈、以及这份厂商访谈该打几折。
参考资料
- Michael Segner,Anthropic,《The Claude Code guide for startups》,2026 年 8 月 20 日。五条原则、各章 Tip 与结尾 checklist 均出自此文。https://claude.com/blog/claude-code-guide-for-startups
- Michael Segner,Anthropic,《Steering Claude Code: when to use CLAUDE.md, skills, hooks, and subagents》,2026 年 6 月 18 日。七种下指令方式的载入时机、压缩行为与上下文成本对比。https://claude.com/blog/steering-claude-code-skills-hooks-rules-subagents-and-more
- Anthropic Engineering,《Demystifying evals for AI agents》,2026 年 1 月 9 日。20–50 个起步任务、三类评分器、pass@k 与 pass^k。https://www.anthropic.com/engineering/demystifying-evals-for-ai-agents
- Anthropic,《How three YC startups built their companies with Claude Code》,2025 年 11 月 17 日。研究、规划、实现分成独立会话的工作流来源。https://claude.com/blog/building-companies-with-claude-code
本文部分内容由 AI 辅助生成,经人工审校和补充后发布。