级联半径:为什么重试修不好多智能体流水线
Deep Research 报告 | 2026 年 9 月 | 面向 Agent 系统建设者与数据工程团队
摘要
多智能体系统的关键问题已经从"有没有用"转向"坏在哪里、会扩散多远、能不能恢复"。一批新的故障注入基准开始绕过笼统的任务成功率,直接观察错误如何产生、传播和被遏制。
几项独立研究给出了相互咬合的证据:在 OrchestraBench 的受控实验中,工具调用故障可被完全恢复,而上下文污染、输出冲突和抢跑行动的最终成功率均为 0;盲目重试只会复现潜伏故障并延长发现时间。MAS-FIRE 进一步表明,闭环拓扑能中和超过 40% 会击穿线性流水线的故障;Who&When 则显示,自动定位到决定性错误步骤的最佳准确率只有 14.2%。
这些结果指向同一个判断:多智能体可靠性的核心不是让模型"再想一次",而是让系统能够检测污染、限制传播并回到可信状态。 本文将沿着"故障分型—级联传播—归因回滚"这条主线,解释级联半径为何值得进入监控面板,以及生产团队应该按什么顺序建设防线。
一、这条研究线是怎么冒出来的
要理解今天的研究为什么盯着"失败"不放,得先看 2025 年那个尴尬的空档。
当时多智能体框架——AutoGen、LangGraph、CrewAI、MetaGPT、ChatDev——已经从 demo 往生产走了,但它们之间唯一可比的东西只有任务准确率。一个流水线在生产环境里给出了错误答案,团队能知道的就是"这次失败了",而没法知道是哪个路由决策失误、错误从哪一级开始扩散、加上"智能路由"这层复杂度到底值不值。伯克利团队把这个状态描述得很准:失败常常是静默的——一个被错误路由的任务,照样会产出一份看起来很合理的回答。
MAST(Multi-Agent System Failure Taxonomy)是第一次系统性的回应。Cemri 等人用扎根理论(Grounded Theory)方法,分析了 7 个开源框架的 200 条对话轨迹——每条平均超过 15,000 行文本——由六位专家标注员迭代编码,最终收敛出 14 种失败模式、3 个大类:系统设计问题、智能体间失配、任务验证缺失。三名标注员在 15 条轨迹上独立打标,Cohen's Kappa 达到 0.88,这个一致性水平说明"失败模式"确实是可辨认的客观现象,而不是研究者的主观归类。
MAST 的价值不只在分类。研究者发现 ChatDev 的 CPO 智能体会在未与 CEO 达成共识时终止对话,这是典型的"违反角色规范"(FM-1.2)。把最终决定权交还 CEO 后,任务成功率提升 9.4%;增加高层任务目标验证后,又获得 15.6% 的提升。但 ChatDev 在 ProgramDev 上的基线正确率仅为 33.33%,局部补丁并没有把系统推到高可靠区间。这里真正重要的结论是:不少失败来自系统结构和交互机制,不能简单归因于底层模型不够强。
这给后续研究定了方向:既然被动等待生产事故既慢又不可复现,就主动注入故障,观察系统如何失效。
二、"编排失败"到底指什么
在往下走之前,需要把术语边界划清楚,否则后面的数字会互相打架。
任务失败(task failure)是端到端的:最终输出错了。编排失败(orchestration failure)是过程性的:某个路由、委派、验证或状态传递的决策错了——它可能导致任务失败,也可能被下游侥幸纠正,还可能产出一个"正确但无法审计"的结果。这两者不是一回事,而传统基准只测前者。
这个差别在一份数据里体现得特别刺眼。Tian 等人在 GPQA-Diamond 上做过一个统计:在 95.5% 的案例中,参与编排的智能体里至少有一个答对了,但编排系统最终只交出 87.4% 的正确率。换句话说,编排过程主动丢掉了大约 8 个百分点本来已经拿到手的正确性。这部分损失完全看不见——端到端指标只会告诉你"87.4%",不会告诉你"你本可以有 95.5%"。
顺着这个缺口,2026 年的评测工具分化成三代,各自回答不同的问题。
| 代际 | 代表工作 | 回答的问题 | 方法 | 局限 |
|---|---|---|---|---|
| 端到端基准 | AgentBench、SWE-bench、OdysseyBench | 这个流水线成功了吗 | 跑真实任务,看最终正确率 | 无法定位失败点,成本随规模暴涨 |
| 归因基准 | Who&When、TraceElephant | 失败是谁、在哪一步造成的 | 对已发生的失败轨迹做事后标注 | 观察性的,无法控制变量,不可复现 |
| 注入基准 | MAS-FIRE、OrchestraBench | 特定故障会传播多远、能否恢复 | 按固定种子注入故障,测恢复率与传播 | 工作流多为合成,构念效度需另行论证 |
注入基准是今年的新东西,而它带来的最重要产物,是一个此前没人量化过的指标:级联半径(cascade radius)——在第 1 级注入一个错误后,下游有多少级被污染。这个指标之所以关键,是因为它把"一个错误值多少钱"从玄学变成了可以放进 SLO 的数字。
三、先看清故障链:暴露、传播、归因
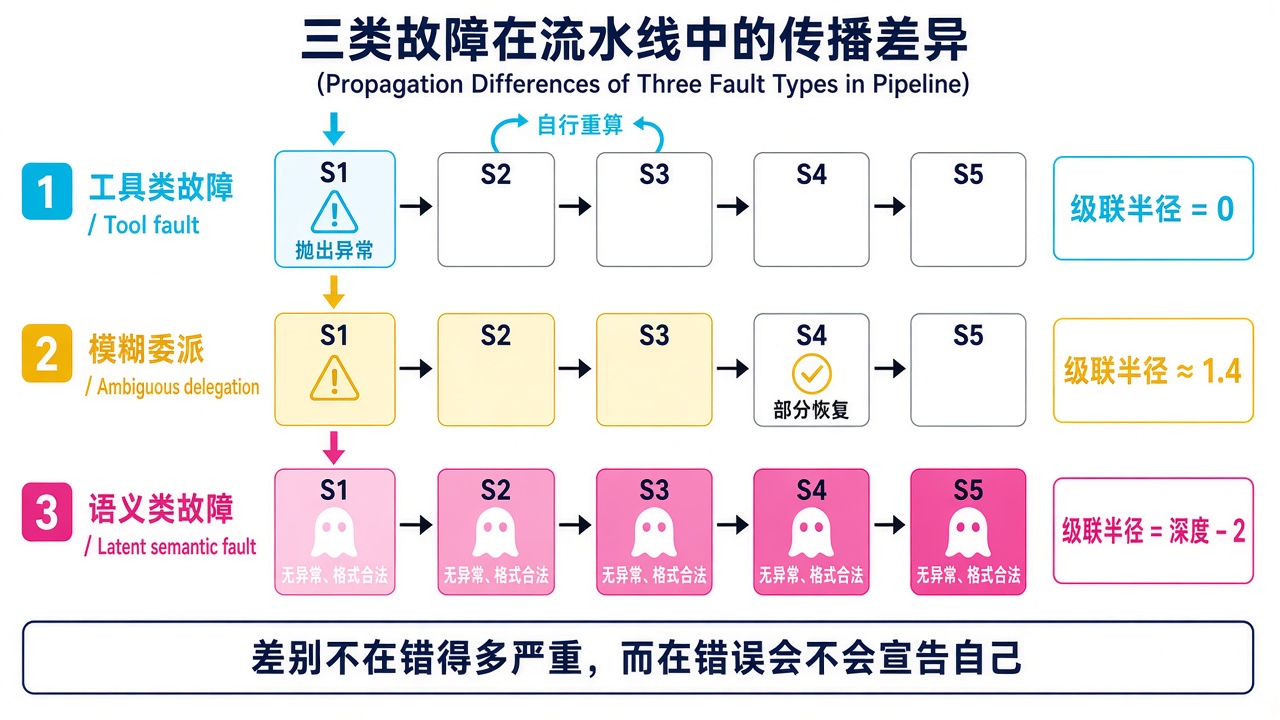
后面的实验很多,但都可以放进同一条故障链:错误是否会主动暴露、暴露前会传播多远、发现后能否定位源头。三段对应三类不同的工程手段。
第一段是故障暴露。 工具调用失败、参数格式错误和接口超时虽然常见,却相对容易处理:它们会主动暴露,系统可以重算、换路或中止。真正危险的是潜伏的语义故障:上下文被污染、子智能体输出矛盾、信息尚未收齐便提前行动。它们不抛异常,只留下格式正确、内容错误的中间结果。
第二段是级联传播。 错误中间结果一旦被当作可信上游值消费,就会污染所有依赖它的阶段;在迭代协作中,它还可能因被反复引用而固化为虚假共识。研究者称之为 consensus inertia(共识惯性)。
第三段是故障归因。 Who&When 从 127 个多智能体系统收集了 184 个标注失败任务。最好的方法定位到责任智能体的准确率为 53.5%,定位到决定性错误步骤仅为 14.2%;部分方法甚至低于随机基线。也就是说,发现"结果错了"与知道"哪一步污染了状态"之间,仍隔着很大距离。
三段构成一条完整链路:可见性决定能否及时发现,级联半径决定损失规模,归因能力决定能否精确回滚。 下面的研究分别测量了这三件事。
四、三组实验与生产经验:为什么重试不够
4.1 OrchestraBench:在真实 Claude 上测出的三层故障结构
这份工作(Anote 团队,arXiv:2608.05263)没有停留在模拟:核心实验运行在真实 Claude 智能体上,以可验证的算术依赖链作为受控探针,每种故障模式 30 个样本,总计 N=150。选择算术链,是为了用精确匹配获得无须主观判断的真值。
| 故障模式(MAST 分类) | 算术链成功率 | 算术链级联半径 | 贷款审批版成功率 | 贷款审批版级联半径 |
|---|---|---|---|---|
| 工具调用错误 | 1.00 | 0.00 | 0.70 | 0.60 |
| 模糊委派 | 0.30 | 1.40 | 0.40 | 1.20 |
| 上下文污染 | 0.00 | 2.00 | 0.00 | 2.00 |
| 子智能体输出冲突 | 0.00 | 2.00 | 0.00 | 2.00 |
| 抢跑行动 | 0.00 | 2.00 | 0.00 | 2.00 |
结果分成三档:工具调用故障完全恢复,模糊委派约有三分之一能被纠正,而上下文污染、输出冲突和抢跑行动的最终成功率均为 0。区别不在错误有多复杂,而在系统是否知道错误已经发生。
最关键的一行数据不在表里:重试无法恢复这些潜伏故障。 当污染源仍在上下文中,重试只会重新生产同一个错误并延长发现时间。retry with backoff 适合暂时性的工具失败,却不能代替语义校验、故障归因和状态修复。
作者用两组对照检查这一结果是否只是实验构造的产物。把相同计算改写成四角色贷款审批流程后,故障模式的相对排序不变,但绝对数值发生偏移:模糊委派从 0.30 升至 0.40,工具故障恢复率从 1.00 降至 0.70。跨 Sonnet 4.6、Opus 4.8 和 Haiku 4.5 重跑后,工具故障始终最易恢复,上下文污染和抢跑行动始终未恢复,模糊委派则在 0.10–0.33 间波动。稳定的是故障层级,不是每一个具体数值。
级联半径随深度的增长同样是单调的:
| 流水线深度 | 潜伏型故障级联半径 | 工具型故障级联半径 |
|---|---|---|
| 3 | 0.93 | 0.00 |
| 4 | 1.85 | 0.00 |
| 5 | 2.80 | 0.00 |
| 6 | 3.63 | 0.00 |
| 7 | 4.67 | 0.00 |
近似每加一级、半径涨 0.9。三种灾难性模式精确地等于"深度 − 2",也就是说它们污染了注入点之后的每一级;模糊委派因为会部分自愈,曲线始终低于这个结构上限。作者很诚实地指出,在这条可验证算术链上,确定性模式的增长有一部分是构造使然,所以他们把深度扩展定位为"佐证信号"而不是头条结论。
这里还藏着一个值得单独拎出来的实验。研究者先让 LLM 路由器读取可信上游值,潜伏型故障恢复率从基线的 0.08 升至 0.83,级联半径从 1.83 降至 0.33。随后,他们在一组独立、规模更大的消融实验中移除可信上游提示:带提示的恢复率为 0.67,不带提示时降至 0.08(配对下降 0.58,p=5.19×10⁻⁴)。增益主要来自可信状态信号,而不是模型自主发现了污染。
因此,这组实验支持的不是"LLM 路由器天然会自愈",而是更窄也更重要的结论:检测语义污染需要一个来自系统外部的可信参照。
4.2 MAS-FIRE:架构拓扑的保护力,比换模型更大
如果说 OrchestraBench 回答了"故障怎么分层",MAS-FIRE(arXiv:2602.19843)回答的是"什么结构能挡住它"。这份工作定义了 15 种故障类型,覆盖智能体内部认知错误和智能体间协作失败,通过三种非侵入式机制注入:修改提示词、改写响应、操纵消息路由。测试对象是三种代表性架构——线性瀑布式的 MetaGPT、迭代闭环的 Table-Critic、双边协商的 CAMEL。
| 故障类型 | MetaGPT(线性) | CAMEL(双边协商) | Table-Critic(迭代闭环) |
|---|---|---|---|
| 角色模糊 | 23.97%–31.68% | 61.05%–69.88% | 79.31%(GPT-5)/ 91.05%(DeepSeek-V3) |
| 盲目信任 | 0.0% | 0.0%(提示层防御) | 6.32%(GPT-5)/ 70.61%(DeepSeek-V3) |
| 指令类故障 | ≤13.7% | — | 16.67%–40.52% |
| 通信类故障 | >93% | — | — |
两条结构性结论先于模型差异。第一,迭代闭环中和了超过 40% 会击穿线性工作流的故障;Table-Critic 的验证—精炼循环本身就是一道拦截线。第二,通信类故障在 MetaGPT 中的恢复率超过 93%,因为角色订阅、去重和环检测被下沉到确定性基础设施,无须依赖模型临场推理。
第三条最反直觉:更强的模型不一定更鲁棒。 在"盲目信任"故障下,研究者要求 JudgeAgent 无条件信任 Generator,同时向 Generator 注入语义错误。Table-Critic 配 GPT-5 的恢复率为 6.32%,配 DeepSeek-V3 则为 70.61%。作者的解释是,恢复要求 JudgeAgent 推翻已被污染的指令;更强的指令遵循能力在这个特定故障下反而成了负担。
这不是"弱模型更安全"的普遍结论,而是一个边界提醒:指令遵循只有在指令可信时才是安全特性。
4.3 From Spark to Fire:把治理做成消息层插件
前两份工作诊断问题,这份(arXiv:2603.04474)给了一个可落地的处方,而且处方的形态很有启发性。
研究者把协作抽象成有向依赖图,并将错误扩散归结为传播强度、网络拓扑和纠正能力之间的竞争。在六个主流框架上,他们识别出级联放大、拓扑敏感性和共识惯性三类脆弱性;一个原子级错误种子就可能扩展成系统级失败。
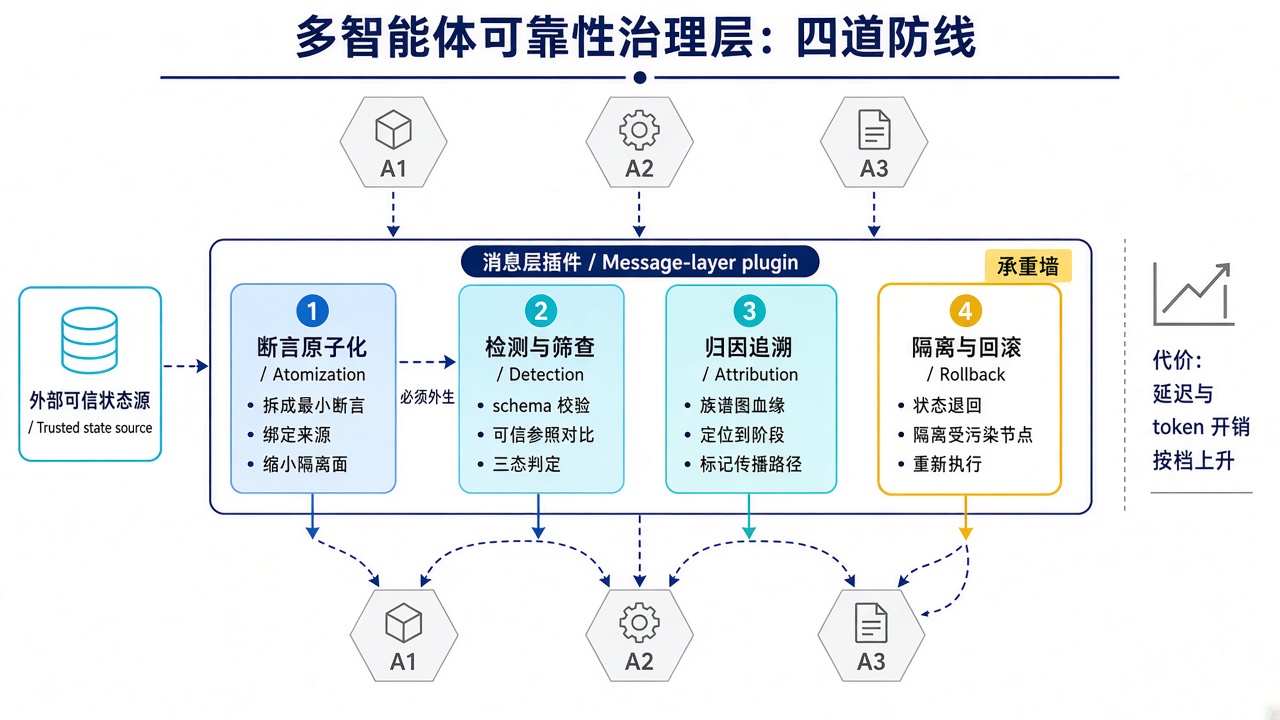
防御方案不改协作架构,而是在消息层增加"族谱图"治理插件:原子化断言、追踪来源、筛查与定向验证,并在确认污染后执行隔离和回滚。防御成功率由基线 0.32 提升至 0.89 以上。
消融实验揭示了这四件事的权重排序,这个排序对工程选型非常有用:
| 移除的组件 | 遏制率(BICR) | 说明 |
|---|---|---|
| 完整方案 | >89% | 检测 + 归因 + 隔离 + 回滚 |
| 去掉回滚 | 3.1% | 几乎等于没防御 |
| 去掉检测 | 14.4% | 有回滚但不知道何时触发 |
| 去掉断言原子化 | 40.0% | 粒度太粗,隔离面过大 |
回滚是那块承重墙:去掉它,遏制率从 89% 直接掉到 3.1%。这和 OrchestraBench 的重试结论是同一个道理的两面——光"再试一次"没用,你必须能把状态退回到污染发生之前。
代价也是明码标价的:Speed 模式下延迟从 100.6 秒涨到 149.9 秒、token 从 13,212 涨到 20,789;Strict 模式能把遏制率推到约 94%,但代价是 214.6 秒和 56,314 token——四倍多的 token 开销。这意味着治理层不是"加了就好",而是一个需要按任务价值分档配置的旋钮。
4.4 Anthropic 与 Cognition:生产环境里两种相反的经验,和它们的交汇点
学术基准之外,两家把多智能体推到生产的公司留下了一组有意思的对照。
| 维度 | Anthropic Research | Cognition(编码场景) |
|---|---|---|
| 架构 | Opus 4 领队 + Sonnet 4 子智能体并行 | 多智能体贡献判断,写入单线程 |
| 实测收益 | 内部研究评测比单 Opus 4 高 90.2% | 跨前沿模型的能力路由带来实际增益 |
| 性能归因 | token 用量单独解释 80% 的方差 | 依赖子任务与模型能力的匹配 |
| token 成本 | 约为聊天交互的 15 倍(单智能体约 4 倍) | 未公开,但写入单线程压低了重算 |
| 明确不适用 | 共享同一上下文、强依赖的任务(如多数编码) | 并行写入的智能体群 |
Anthropic 的 Research 功能用 Claude Opus 4 作为领队智能体、Claude Sonnet 4 作为并行子智能体,在内部研究评测上比单个 Opus 4 高出 90.2%。但他们对"为什么有效"的解释相当去魅:在 BrowseComp 评测上,三个因素解释了 95% 的性能方差,其中光 token 用量本身就解释了 80%,另外两个是工具调用次数和模型选择。多智能体架构之所以有效,主要是因为它提供了一种"花掉足够多 token"的结构。代价随之而来:普通智能体大约消耗聊天交互 4 倍的 token,多智能体系统大约 15 倍。他们明确划了适用边界——适合宽度优先、信息量超出单个上下文窗口、需要大量并行的只读型任务;不适合所有智能体必须共享同一上下文、彼此强依赖的场景,比如大多数编码任务。
Cognition 走的是相反的路径。他们在 2025 年发过一篇标题很不客气的《Don't Build Multi-Agents》,理由是并行写入的智能体会各自对代码风格、边界情况、实现模式做出隐含且互相冲突的选择,产品因此变得脆弱。10 个月后他们更新了立场:确实部署了能跑通的多智能体系统,但收敛到一类很窄的模式——多个智能体贡献"智力",而写入保持单线程。子智能体负责审查、检索、提供边界判断,不负责动手改状态。他们还发现了一个新用法:跨前沿模型的路由不是"弱模型问强模型"的难度升级,而是"哪个模型更擅长这个子任务"的能力路由——有的模型更会调试,有的更擅长视觉推理,有的更会写测试。
两家的结论表面相反,落点却一致:适合并行的是独立的信息获取与判断,不是对共享状态的无约束写入。 Anthropic 让多个智能体并行研究,却把最终写作收回主智能体;Cognition 则直接坚持单线程写入。这个生产经验与前述实验相互呼应:共享状态越多、依赖越强,协调和污染风险就越高。
五、从证据到设计:四条可靠性原则
上面的数字不需要再背一遍,它们可以压缩成四条设计原则。
原则一:先按"是否可见"给故障分级。 会抛异常的工具故障,可以交给超时、重试和熔断;格式合法但语义错误的中间结果,则必须经过独立校验。两类故障不能共享一套恢复策略。
原则二:把流水线深度视为风险预算。 在 OrchestraBench 的受控链上,潜伏故障的平均级联半径随深度 3→7 从 0.93 增至 4.67。每增加一级,不只增加一次调用,也扩大了上游污染的潜在影响面。新增智能体前,应先证明并行收益大于协调成本。
原则三:重试前先修复状态。 工具暂时不可用时可以重试;如果上下文、指令或中间结果已经被污染,原状态上的重试只会重复错误。此时需要的是检测、隔离和回滚,再从最后一个可信检查点继续执行。
原则四:可信状态必须由系统提供。 拿掉可信上游提示后,LLM 路由器的潜伏故障恢复率从 0.67 降至 0.08,接近基线。校验和、外部真值源、独立验证器和可审计血缘,不是附加功能,而是语义故障检测的前提。
六、行业影响:可靠性工程正在往哪迁移
Agent 工程正在吸收 SRE 的工作。 提示词、编排框架和工具接入只解决"能不能跑";故障注入、级联半径监控、可信状态设计和回滚机制才回答"坏了怎么办"。区别在于,混沌工程注入的不再只是节点宕机和网络延迟,还包括格式合法的语义污染。
可观测性标准仍在追赶。 监控级联半径的前提,是把智能体调用、工具执行和子智能体委派组织成结构化 span。OpenTelemetry GenAI 约定已经覆盖 invoke_agent、execute_tool、plan、retrieval 和 memory,但相关字段仍处于 Development 状态,且新旧属性名并存。现阶段的务实做法是钉死 instrumentation 版本、兼容查询两代字段,并避免把兼容性双发的 token 数重复相加。
托管 harness 减少了运维面,也增加了黑箱面。 OpenAI Agents API 托管会话、编排、上下文压缩和恢复,省掉了队列、状态库、沙箱和压缩例程的大量工程工作。但压缩决定哪些信息能进入下一轮;如果摘要策略无法检视和消融,它本身就是一个质量变量。再考虑目前的数据驻留与 ZDR 限制,企业需要在减负、可观测性和合规之间明确取舍。
监管最终会落到可验证的工程证据。 加州 9 月 18 日的行政令要求评估 frontier 模型的 kill switch、驻场审计和失控事件报告。无论最终规则如何,团队都需要回答类似的问题:错误在哪里产生、传播到哪些环节、是否能及时隔离、能否证明已经回滚。级联半径和状态血缘正是这类答案的技术基础。
模型差异不能替代系统防线。 MAS-FIRE 中较弱模型在某类污染指令下表现更好,只能说明能力排序不等于鲁棒性排序,不能推出开源或国产模型天然更安全。无论选哪种模型,都不应把它偶然的行为倾向当作防线。
七、实践入门:按什么顺序加防线
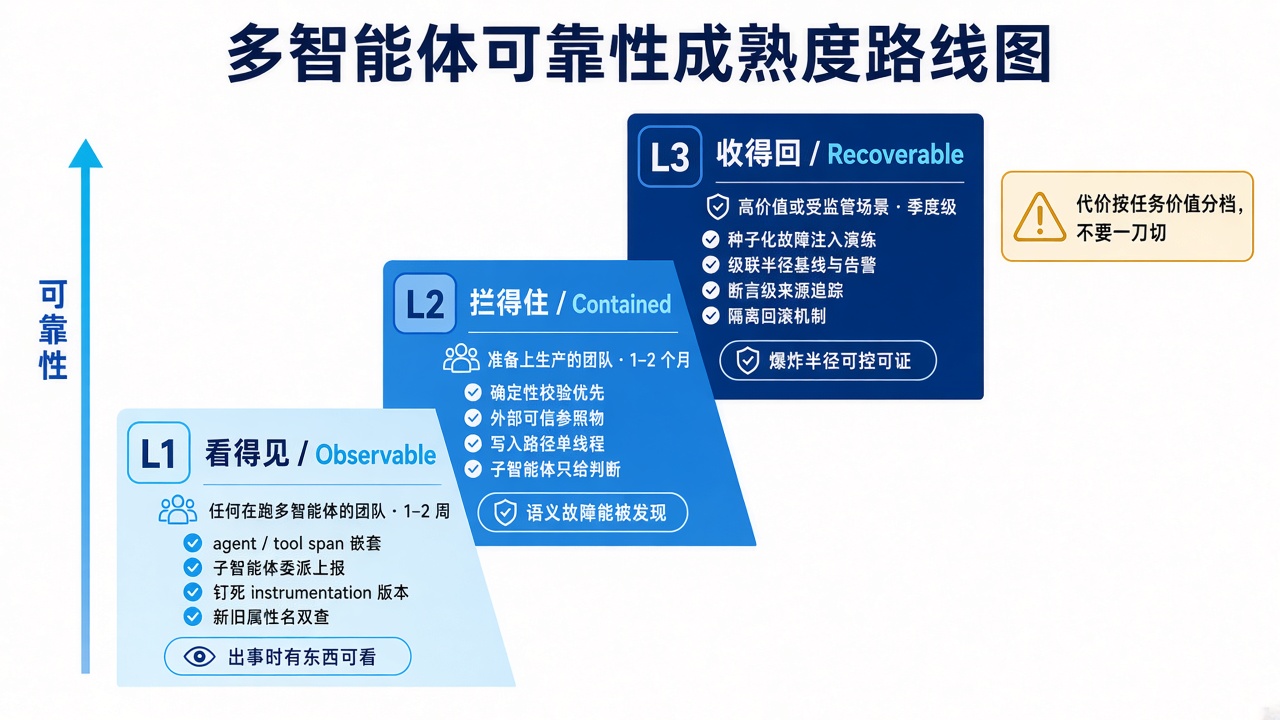
四条原则不必一次全部实现。更稳妥的路径是先获得可见性,再建立遏制能力,最后补齐恢复与验证。
L1:看得见(1–2 周)。按 OpenTelemetry GenAI 语义约定把 agent span、tool span 和子智能体委派嵌套起来,钉死 instrumentation 版本,同时查询新旧两代属性名。这一层不会直接提高成功率,但能让团队在出事时还原调用链。
L2:拦得住(1–2 个月)。把能硬编码的检查下沉到基础设施:输出 schema、数值范围、关键字段校验和,以及跨智能体的消息去重与环检测。为关键中间结果建立外部可信参照,并把共享状态的写入收敛到单线程;子智能体负责检索、审查和判断,不直接争夺写权限。
L3:收得回(季度级)。在预发环境按固定种子注入语义故障,测出不同深度下的级联半径,并为它建立基线与告警阈值。随后实现断言级来源追踪、隔离和检查点回滚。From Spark to Fire 的数据也提醒我们,这一层会显著增加延迟与 token 成本,因此应按任务价值和监管风险分档启用。
| 资源 | 类型 | 用途 |
|---|---|---|
MAST(arXiv:2503.13657,pip install agentdash) | 分类法 + LLM 标注器 | 给你的失败轨迹打标,得到失败模式分布 |
| Who&When(ICML 2025,含 184 条标注失败) | 归因基准 | 评估你的自动归因方案,也是现实期望的校准器 |
| MAS-FIRE(arXiv:2602.19843) | 注入框架 | 15 类故障、三种非侵入注入机制,可直接复用 |
| OrchestraBench(arXiv:2608.05263) | 注入 + 级联基准 | 种子可复现,Apache-2.0,全量复现约 4 美元 |
| OrchBench(arXiv:2607.25656) | 编排计划模拟器 | 不跑真实智能体评估编排方案,仅需 1.3% token |
| OpenTelemetry GenAI 语义约定 | 观测标准 | agent/tool/workflow span 的命名基线(仍为 Development) |
八、未来展望
注入式评测会从研究工具变成发版门禁。 今天这些基准还带着明显的研究气质——合成工作流、受控算术链、作者自己承认构念效度有限。但它们的形态(固定种子、可复现、离线可重算)天然适合进 CI。一年之内,"这次发版的级联半径回归了没有"大概率会变成和"测试覆盖率掉了没有"同等常规的问题。
归因会成为真正的瓶颈。 检测和回滚都有相对确定的工程路径,但 14.2% 的步骤级归因准确率说明"到底哪一步错了"这个问题目前仍然主要靠人。在这个数字显著上升之前,多智能体系统的运维成本不会下降——你能自动止损,但不能自动修复。
可信状态会被协议化。 既然智能体无法自主检测污染、必须外部提供参照物,那么"可信状态"就需要一个标准化的载体:带来源与校验和的断言、可审计的血缘、以及跨智能体传递时的完整性保证。From Spark to Fire 的族谱图插件是一个早期形态;它选择做在消息层而不改架构,这个设计取向很可能会被复制。
架构收敛会比模型进步更快见效。 MAS-FIRE 和两家公司的生产经验指向同一条设计规则:闭环验证 + 单线程写入 + 确定性基础设施防御。这三条不依赖任何模型升级,今天就能做,而且收益被实测数据支撑。相比之下,指望下一代模型"更鲁棒"这件事,已经被"强模型悖论"打了一个问号。
结论
多智能体系统最难处理的,不是会报错的工具故障,而是格式合法、语义错误、能够继续向下游流动的状态。这类故障不会因为模型再想一次而消失;流水线越深,它的传播面往往越大。
因此,可靠性设计的顺序应该是:先让故障可见,再用确定性规则和可信参照阻断传播,最后通过来源追踪与检查点回滚恢复状态。重试仍然有用,但只应留给暂时性的工具失败;它不能替代语义校验。
最后留一个问题给正在跑多智能体流水线的你:如果现在在你系统的第一级注入一个格式合法、数值错误的中间结果,你有多大把握在它污染完整条链之前发现它?你的答案是一个数字,还是一句"应该会被发现吧"?
参考资料
- Cemri, M., Pan, M. Z., Yang, S., et al.(UC Berkeley Sky Computing Lab,2025). Why Do Multi-Agent LLM Systems Fail? arXiv:2503.13657. https://arxiv.org/abs/2503.13657
- Chen, Y., Gu, Y., Vidra, N., Setty, S., Zheng, S.(Anote,2026). OrchestraBench: Evaluating Multi-Agent Orchestration Failure Modes, Recovery, and Decomposition Quality. arXiv:2608.05263. https://arxiv.org/abs/2608.05263
- Jia, J., Deng, Z., Chen, Z., Wang, Y., Zheng, Z.(2026). MAS-FIRE: Fault Injection and Reliability Evaluation for LLM-Based Multi-Agent Systems. arXiv:2602.19843. https://arxiv.org/abs/2602.19843
- Xie, Y., Zhu, C., Zhang, X., et al.(2026). From Spark to Fire: Modeling and Mitigating Error Cascades in LLM-Based Multi-Agent Collaboration. arXiv:2603.04474. https://arxiv.org/abs/2603.04474
- Zhang, S., Yin, M., Zhang, J., et al.(ICML 2025 Spotlight). Which Agent Causes Task Failures and When? On Automated Failure Attribution of LLM Multi-Agent Systems. arXiv:2505.00212. https://proceedings.mlr.press/v267/zhang25cq.html
- Ren, Z., He, J., Zhang, X., et al.(2026). OrchBench: Evaluating Multi-Agent Orchestration Plans in Isolation via Deterministic Simulation. arXiv:2607.25656. https://arxiv.org/abs/2607.25656
- Tian, A. X., Zhang, R., Tang, J., et al.(2025). Beyond the Strongest LLM: Multi-Turn Multi-Agent Orchestration vs. Single LLMs on Benchmarks. arXiv:2509.23537. https://arxiv.org/abs/2509.23537
- Anthropic Engineering(2025 年 6 月). How we built our multi-agent research system. https://www.anthropic.com/engineering/multi-agent-research-system
- Cognition(2026). Multi-Agents: What's Actually Working. https://cognition.com/blog/multi-agents-working
- OpenTelemetry(2026). GenAI Semantic Conventions. https://github.com/open-telemetry/semantic-conventions-genai
- OpenAI(2026 年 9 月 10 日). Agents API Overview. https://developers.openai.com/api/docs/guides/agents-api/overview
- PPC Land(2026 年 9 月 18 日). Newsom sets November 16 deadline to study frontier AI kill switch. https://ppc.land/newsom-sets-november-16-deadline-to-study-frontier-ai-kill-switch/