分数不迁移:BIRD 考 70 分的 Agent,到真实 BI 只剩 17 分
Deep Research 报告 | 2026 年 9 月 | 面向数据工程师、Agent 选型者与数据平台团队
摘要
给团队选数据工程 Agent,最省事的办法是看榜。但 2026 年下半年出现的一批新基准,反复指出同一个问题:榜上的分数,往往带不到真实工作里。
在 BI-Bench 上,BIRD 榜前四的开源模型只拿到 6.0%–17.3%,Spider 2.0-lite 榜前二的开源 Agent 也只有 23.8%–26.3%。在 DataClawEval 上,16 个前沿 Agent 跑 100 个真实数据工程任务,最高分是 74.9;没有任何一个模型在五种执行引擎上全面领先,同一模型独立运行三次,最好与最差甚至能相差 26.76 分。
这些结果揭示了三种“不迁移”:跨基准不迁移、跨引擎不迁移、跨运行不迁移。本文依次解释这三层断裂,再讨论两个更实际的问题:怎样可信地判分,以及工具、领域后训练和持续评测,分别能修复什么。
一、旧基准量的是哪一段
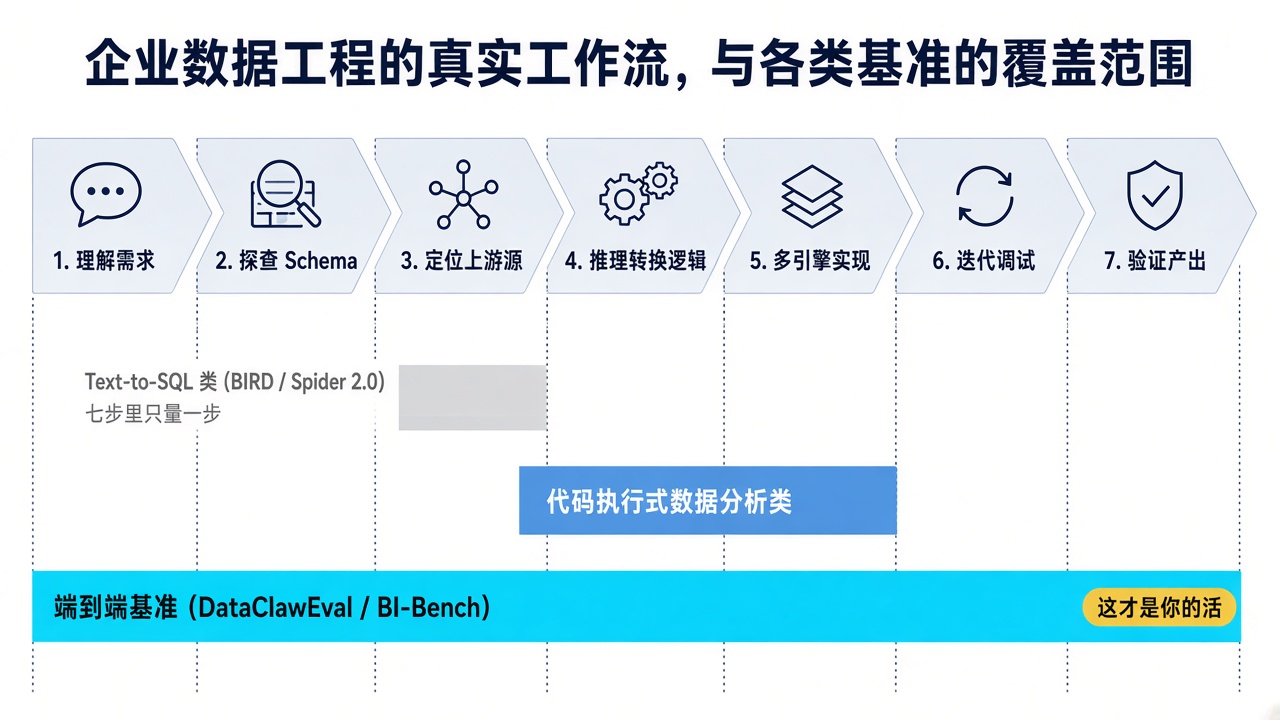
要理解分数为什么不迁移,得先看清企业数据工程的真实工作流有多长。
DataClawEval 的作者把它拆成了一条链:拿到一句自然语言需求后,工程师要去查数据库 schema、理解业务语义、定位上游数据源、推理转换逻辑、用异构的数据处理技术写出可执行程序、反复调试运行时错误,最后验证产出对不对。这条链上任何一环断了,最终那张表就是错的。
现有基准量的是这条链上的哪一段?大致可以分成四类:
| 基准家族 | 代表 | 测什么 | 没测什么 |
|---|---|---|---|
| Text-to-SQL | BIRD(12,751 对问答 / 95 个真实库)、Spider 2.0 | 固定 schema 上合成一条 SQL,按执行准确率打分 | 探查、多引擎实现、调试、产出物化 |
| 代码执行式数据分析 | InfiAgent-DABench、DA-Code、DABstep | 在沙箱里迭代写代码,得到一个分析答案 | 生产级流水线的构建与运行 |
| 端到端数据工程 | DataClawEval(100 任务 / 5 引擎) | 完整工作流,确定性脚本判分 | — |
| 端到端 BI | BI-Bench(100 用例 / 真实 .pbix) | 从原始表到业务答案的全流程 | — |
前两类通常有一个共同特征:桌子已经擦干净了。表已经结构化,部分基准还直接给出 schema 或 join 条件;而真实工作里,最费力的恰恰是找到桌子、擦干净,再确认它能不能和旁边那张拼起来。
BI-Bench 的构造方式很能说明问题。研究者从公开网页上爬了大量真实的 Power BI 工程文件(.pbix),从用户自己搭的仪表盘里挑出标题能准确描述意图的可视化,把它背后的结果表直接导出成 CSV 当作真值答案。这样得到的 (问题, 答案) 对,全部来自真人在真实业务里提的问题,没有一条是 LLM 合成的。这个过程花了 400 多人时,平均每条用例 4 小时以上,最后只留下 100 条。
代价换来的是真实难度。论文举出的极端用例,需要模型同时处理 38 张必要表。在这种复杂 schema 上,选错表、漏做一次转换或连错一个键,都会让最终答案失效。
二、崩塌之一:分数不跨基准迁移
第一层崩塌最直观:把榜单冠军直接搬过来,分数会塌掉一个数量级。
| 系统 | 原榜单成绩 | BI-Bench(SQL)成绩 |
|---|---|---|
| Kwai-AutoSQL-14B / 32B、Infly-RL-SQL-32B、XiYanSQL-QwenCoder-32B | BIRD 榜前四开源模型,均 >70% | 6.0–17.3%(平均不到 10%) |
| ktx + Codex(GPT-5.5) | Spider 2.0-lite 榜首,>70% | 26.3% |
| Databao Agent(GPT-5.2) | Spider 2.0-lite 次席,>70% | 23.8% |
| o4-mini(BI-Bench 最强) | — | 48.2% |
| GPT-5.5 | — | 46.7% |
这张表的含义不是模型突然退化,而是原榜单没有覆盖新任务需要的完整能力。专门为 SQL 生成优化到 70% 以上的系统,换到端到端 BI 后只剩个位数到十几分;在不加工具的设置下,通用模型 o4-mini 反而以 48.2% 居首。
为什么落差这么大?论文的解释落在 join 和 transform 上。这两件事在 BI 里本质是数据管理问题,不是文本生成问题。LLM 当然可以被提示去预测 join,但真实 BI 工程里的表动辄数百万行,prompt 里只能塞进每张表的一小部分行,靠这点样本去判断值的重叠关系并不可靠。而经典的 join 预测算法在全表上计算值包含率这类统计特征,并且在所有表之间做全局推理——在大表和复杂 schema 面前,老办法反而更稳。
另一项研究从横向给出了同样的信号。Data Agent Benchmark(DAB)把 54 条查询铺在 12 个数据集、9 个领域和 4 种数据库管理系统上,专门测跨异构系统的集成、转换与分析——也就是真实企业里数据被拆散在多个库、引用不一致、关键信息埋在非结构化文本里的那种状态。在这套题上,表现最好的前沿模型 Gemini-3-Pro 只有 38% 的 pass@1。
因此,跨基准不迁移的原因可以压缩成一句话:任务名称相似,不等于工作流同构。 选型时先对齐输入状态、可用工具、执行环境和验收方式,再比较分数;否则 BIRD 上的 70% 和 BI-Bench 上的 10%,只是两把刻度不同的尺子。
三、崩塌之二:同一个模型换个引擎就不是同一个模型
第二层崩塌发生在同一个基准内部。DataClawEval 的 100 个任务覆盖五种执行引擎:PySpark 20 个、HiveSQL 28 个、MySQL 20 个、PrestoSQL/Trino 12 个、FlinkSQL 20 个,兼有批处理与流处理,横跨五个业务域。每个任务都在独立 Docker 沙箱里执行,再由任务专属的确定性脚本判分,不依赖 LLM 评委。
16 个前沿 Agent 跑下来,总分区间是 60.3–74.9。最强的 GPT 5.5 只有 74.9,离饱和还很远。但真正有意思的不是总分,是拆开看的样子:
| 引擎 | 分数区间 | 最佳模型 | 低分率(<50 分的运行占比) |
|---|---|---|---|
| MySQL | 全员 >74,最高 88.8 | GPT 5.5 | 9.7% |
| PySpark | 48.0–83.8 | Claude Opus 4.8(83.8) | 10.6% |
| FlinkSQL | 44.9–85.0 | DeepSeek V4 Flash(85.0) | 19.1% |
| PrestoSQL/Trino | — | DeepSeek V4 Pro(77.7) | 25.5% |
| HiveSQL | 无人超过 69.8,最低 49.6 | GPT 5.5 | 26.1% |
论文的核心判断是:性能在引擎之间的差异,远大于模型之间的差异。 MySQL 上所有 Agent 都超过 74 分,可能与关系型 SQL 在训练语料中更常见有关;HiveSQL 无人超过 69.8,显示方言与执行语义仍是明显短板。PySpark 和 FlinkSQL 的模型间跨度最大,因此比总分更能区分能力边界。
而"没有全能选手"这一点更直接:GPT 5.5 拿下总分、HiveSQL、MySQL 三项第一,PySpark 归 Claude Opus 4.8,Trino 归 DeepSeek V4 Pro(77.7,与 Gemini 3.5 Flash 打平,但 token 成本不到后者的三分之一),FlinkSQL 归 DeepSeek V4 Flash。GLM 5.2 是个典型的偏科生:PySpark 和 MySQL 上有竞争力,HiveSQL 只有 49.6。
另一个反直觉结果是:token 花得多不等于做得好。模型间的 token 消耗相差超过 4 倍,却与得分没有正相关。GPT 5.3 Codex 每任务平均使用 271.4k token,最省但排名靠后;Gemini 3.5 Flash 平均使用 973.8k,在 Trino 上达到 1529.0k,成绩仍只在中游。大量探查和重复尝试,可能只是在放大成本。
所以榜单该怎么看?论文给的建议是:跨引擎的覆盖度,比平均分更能说明一个数据工程 Agent 的能力。一个总分数字会把最该看的信息抹掉。
四、崩塌之三:跑一次的分数不代表能上线
第三层崩塌关乎"能不能无人值守"。DataClawEval 让四个代表性 Agent 每个任务独立跑三遍,同时看分数口径(max@3 / avg@3 / min@3)和成功口径(pass@3 表示三次里至少成功一次,pass^3 表示三次全成功)。
结果差别很大。Gemini 3.1 Pro 最稳,分数波动 12.63 分,pass@3 与 pass^3 的缺口只有 8.16 个百分点。DeepSeek V4 Flash 和 V4 Pro 峰值成绩有竞争力,但波动分别到 15.92 和 15.31 分,缺口 17.35% 和 19.39%。最差的 Hy3:最好一次 70.49 分,最差一次 43.73 分,相差 26.76 分;pass@3 有 75.51%,但 pass^3 只剩 48.98%。
把最后一组数字翻译成工程语言:这个 Agent 有超过四分之一的任务处于**“三次里能成功,但不能三次都成功”**的状态。在每天定时、无人值守的流水线里,“偶尔做对”仍然是不可靠。评测因此不能只报单次成绩或最好成绩,还要同时看 max/avg/min 与 pass@3/pass^3。
还有一个更隐蔽的陷阱:超时会改变排名,却不等于它应该被剔除。 1600 次运行中有 79 次(4.9%)到达墙钟上限,未产出要求的文件,因此记 0 分。GLM 5.2 的超时率高达 22%,总均分被拉低 13.3 分:报告均值 68.8,只排第十一;若只统计已完成的运行,均值则为全场最高的 82.1。前一个数字更接近生产可靠性,后一个数字更接近“完成时的解题能力”。选型时应把两者拆开,而不是用一个平均分混在一起。
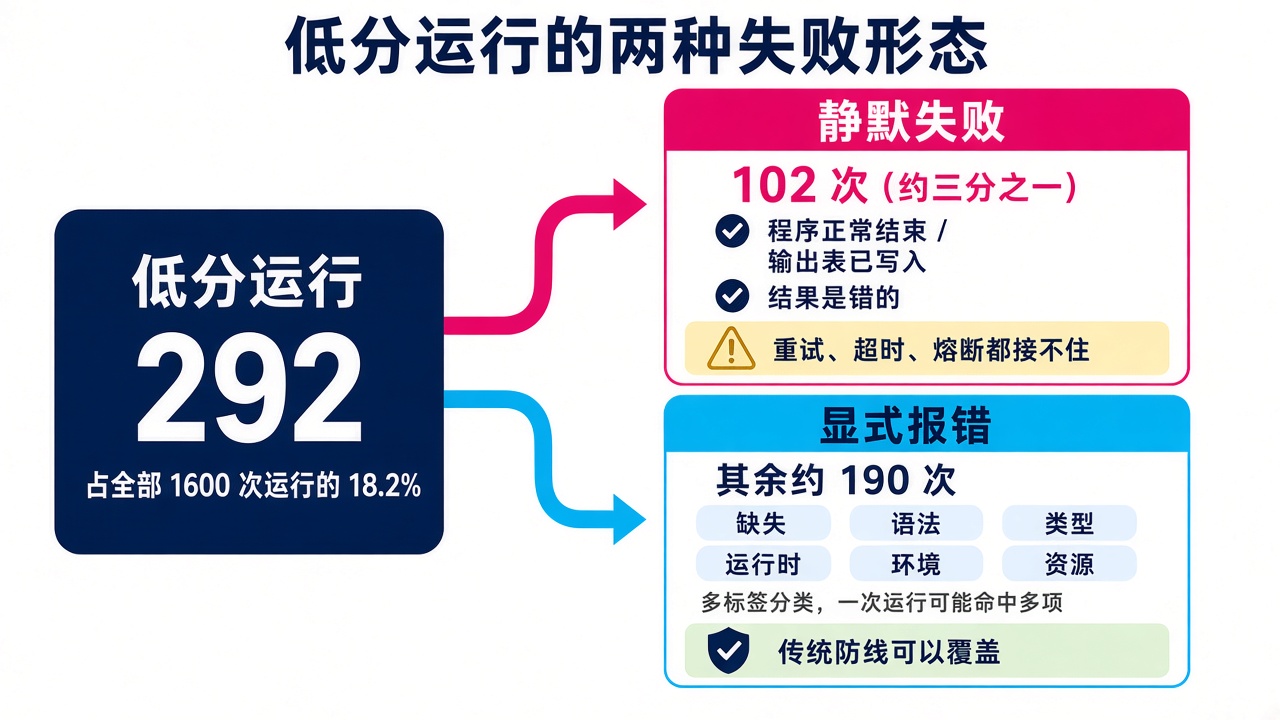
最后是失败的形态。292 次低于 50 分的运行里,大约三分之一(102 次)是静默失败:程序正常结束、输出表也写出来了,结果就是错的。剩下的会在运行时抛出至少一个错误,按类型分为缺失、语法、类型、运行时、环境、资源六类,而且分布强烈依赖引擎——FlinkSQL 的低分主要来自资源类错误(61 次低分里 36 次),Trino 主要是环境类(49 次里 22 次),HiveSQL 主要是类型类(117 次里 29 次)。
这个比例值得所有 Agent 平台团队记住:在低分运行中,约三分之一不会抛异常。重试、超时和熔断只能覆盖显式报错;要拦住静默错误,还得在产出端校验行数、聚合值、schema 和关键业务约束。
五、连评分器都在通胀:LLM-as-Judge 的三种系统性失真
上面所有结论都建立在一个前提上:判分是可信的。DataClawEval 花了不小篇幅证明这个前提为什么不能交给 LLM。
实验设计得很干净:为 100 个用例各写一份 LLM 评委提示词,忠实复刻对应的评分细则,包括打分维度、各维度满分和权重。然后让 GLM 5.2 和 DeepSeek V4 Pro 各自对同一批输出(来自 Claude Opus 4.8)独立打三遍,与规则脚本的真值对比。
| 打分维度 | 规则脚本真值 | GLM 5.2 / DeepSeek V4 Pro |
|---|---|---|
| 过程分(探查 / 效率 / 自校验) | 22.2 | 75.0–76.0 |
| 产物分(可执行 / schema / 数值 / 业务逻辑) | 52.1 | 90.4–91.0 |
| 单用例总分标准差 | 0(逐位精确) | 6.35 / 1.99,最坏超过 55 分 |
| HiveSQL 子集 | 65.0 | 81.3–82.4 |
三种失真同时出现:
- 全面通胀:过程分从 22.2 被抬到 75.0–76.0。评委奖励的是“看起来做过探查与自校验”的文本模式,不是实际执行效果。
- 结果不稳定:同一输出重复评分,最坏能相差 55 分以上;部分维度甚至得到满分的 291% 或 200%,足以让榜单名次随采样噪声变化。
- 偏差依赖引擎:HiveSQL 被高估最多。评委不仅整体偏高,还扭曲了各引擎的相对难度。
这些不是偶发问题,而是纯文本评估的结构性限制:规则脚本会真正执行产物、逐行核对结果;LLM 评委没有观察运行时行为。因此,文风、有用性等主观维度可以交给 LLM;只要任务存在可执行的正确性定义,就应优先使用确定性脚本。
六、还有救:工具与后训练的杠杆比模型规模大
前面说明了分数为何失真,现在看哪些改造真正有效。BI-Agent 的实验给出两个杠杆:专用工具和领域后训练。
第一个杠杆是工具。 BI-Agent 把 BI 工作流拆成结构化数据上的子任务——搜索、连接、转换——然后在各阶段调度专门的数据管理方法,而不是让 LLM 从头生成一切。效果是全面的:
| 模型 | 无工具(SQL) | 有工具(SQL) | 增益 |
|---|---|---|---|
| o4-mini | 48.2 | 61.9 | +13.7 |
| GPT-5.5 | 46.7 | 60.2 | +13.5 |
| GPT-5.2 | 46.1 | 55.2 | +9.1 |
| GPT-OSS-120B | 5.3 | 45.3 | +40.0 |
| Qwen3-8B | 5.2 | 19.8 | +14.6 |
SQL 场景平均提升 14 个百分点、Python 场景 11 个,20 组对比里 19 组统计显著。最戏剧性的是 GPT-OSS-120B:单独用只有 5.3 分,接上工具变成 45.3,直接逼近前沿模型的裸分水平。一个模型的"数据工程能力",很大程度上不是它自己的属性,而是它加上什么工具之后的属性。
第二个杠杆是领域后训练。 研究者用一套轨迹合成方法自动造训练数据(与 BI-Bench 完全隔离以防泄漏),对 Qwen3-8B 做 SFT 和 RL。一个 80 亿参数的模型,配上工具并经过 RL 后训练,在 SQL 上从 5.2 涨到 35.0(+29.8),超过了 GPT-4o,也超过了五个大型开源模型里的四个在无工具设置下的成绩。
成本侧同样明显。后训练的 Qwen3-8B-RL 跑完整个 BI-Bench 只花 0.19 美元,而 o4-mini、GPT-4o 等模型超过 10 美元,质量却相近。论文报告的后训练使用 2 张 80GB H100:SFT 约 9 小时、RL 约 22 小时,按公开云价格估算,总计算成本不到 200 美元。需要注意,这个数字只包含论文中的训练计算,不包含工具开发、数据治理和长期运维成本。
这两个杠杆指向同一个方向:在边界清晰的数据任务上,“小模型 + 专用工具 + 领域后训练”可能比更大的通用模型更划算。 但这里能迁移的是方法,不是论文里的成本数字;团队仍需用自己的数据、引擎和验收标准重新核算。
七、评测本身的账:最优解不是被部署的解
最后一项研究换了个角度:假设你已经建好了靠谱的基准,那跑基准这件事本身的成本怎么办?
一个服务数万月活的生产分析 Agent 给出了具体数字:核心基准 519 道题,完整跑一次约三小时。而模型、提示词、工具、周边系统都在持续变化,每次变化都要重测,开发与监控累计产生了数万次评测运行。研究者拿 52 天内的 574 次历史运行,按时间切成 287 次校准和 287 次留出测试,比较了四种省钱办法。
| 方法 | 执行比例 | 通过率 MAE | 工程特性 |
|---|---|---|---|
| 随机抽样 | 38.5%(200 题) | 1.79 pp | 最简单,精度最差 |
| 历史缓存 | 69.1% | 1.54 pp | 同等执行量下精度最低 |
| 难度分层固定子集 + gp-IRT | 38.5% | 1.40 pp | 小预算下最优 |
| IRT 自适应测试(Rasch) | 38.5% | 1.37 pp | 200 题起精度最高 |
小预算区间(100 题 / 19.3%)是固定子集领先:gp-IRT 2.65 pp,优于随机抽样的 2.94 和自适应的 2.92。从 200 题起自适应反超,300 题(57.8%)时自适应 0.79 pp、固定子集 0.99 pp、随机 1.18 pp。论文摘要还给了一个更强的配置:多维 2PL 自适应测试在 200 题时能做到 1.03 pp 的 MAE。排序保真度也很高,300 题时自适应的 Spearman 相关达到 0.986。
然后他们部署了固定子集。
这个选择是整篇论文最有工程味的地方。精度最优的是自适应测试,但真正上线的是难度分层固定子集,理由全是运维层面的:固定子集在执行前就能知道工作负载,便于排期和容量规划;它保留题目级的可比性,当行为变化时能直接定位是哪几道题变了,而自适应每次选的题不同,这种诊断能力就没了;它不需要在一个为并行执行设计的评测系统里额外加顺序服务逻辑——自适应必须根据当前作答结果决定下一题,天然是串行的。
稳健性也验证过:这个子集不经重新校准就迁移到了另外五个 Agent 家族,在短至一天的校准窗口上也保持稳定。团队给出的运维建议是,模型、提示词、工具或执行系统发生实质变化后重新校准,并定期跑一次完整基准、与固定子集的估计值对比,以测量持续监控期间引入的误差。
这里的普适教训是:评测方案的选型标准不只有误差,还有可解释性、可诊断性和系统契合度。 如果把 MAE 从 1.40 压到 1.37 的代价,是失去题目级归因与并行执行能力,那么更低的误差未必带来更高的工程价值。
八、把研究结论变成一套选型流程
前面的数据最终可以落到四步。它们分别对应“测什么、怎么测、看什么、如何上线”。
第一步:先复刻工作流,再选模型
用自己的 schema 规模、引擎组合、工具权限和业务约束,构造一组小而真实的内部任务。不要直接拿 Text-to-SQL 分数替代端到端能力;如果实际技术栈是 Hive + Flink,MySQL 上的高分几乎没有决策价值。
第二步:用执行结果判分
能写确定性规则的维度——可执行性、schema、行数、数值、业务约束——全部交给脚本。只有文风、解释质量等缺少客观真值的维度,才交给 LLM 评委。这样才能避免“答案错了,但推理写得像对的”带来的评分通胀。
第三步:把总分拆成四组指标
- 能力:按引擎、任务类型和复杂度拆分,而不是只看平均分。
- 稳定性:至少独立运行三次,同时报告 avg/min 与 pass^3。
- 可靠性:单列超时率、显式报错率和静默错误率。
- 成本:同时记录 token、工具调用、运行时长和人工复核成本。
这四组指标回答的是不同问题:能不能做、能不能稳定做、失败时能不能发现,以及值不值得做。把它们压成一个总分,只会丢掉决策所需的信息。
第四步:用“模型 + 工具 + 校验器”上线
允许不同引擎路由到不同模型,不必强求一个全能选手;把 join 预测、全表统计等确定性较强的能力交给专用工具;把产出校验设为强制步骤,而不是可选的自我反思。持续评测可以先用固定代表性子集,遇到模型、提示词、工具或执行环境的实质变化,再重新校准并跑一次完整基准。
结论
这批研究没有证明 Agent 做不了数据工程;它们证明的是,我们过去经常测错任务、看错指标,也用错评委。
BIRD 上的 70% 带不到端到端 BI,平均分掩盖了引擎偏科,单次成功掩盖了运行波动,纯文本评委又会把错误答案打成高分。反过来看,工具能带来 9.1–40.0 个百分点的提升,领域后训练能让 8B 模型接近大模型,说明改进空间并不只在模型规模上。
那么回到你自己的系统:你现在用来决定"这个 Agent 能不能上生产"的那个数字,是跑了一次得到的,还是跑了三次都成功的?
参考资料
- DataClawEval 团队,《DataClawEval: A Benchmark for Data Engineering Agents in Real Industrial Harness》,2026,arXiv:2607.28033 — https://arxiv.org/html/2607.28033v1
- BI-Agent 团队,《BI-Agent and BI-Bench: Towards Automating End-to-End Business Intelligence》,2026 年 9 月 16 日,arXiv:2609.20886 — https://arxiv.org/abs/2609.20886
- Yining She、Lei Lin,《Efficient Benchmarking in Production: A Study of an Evolving LLM Agent》,2026 年 9 月 18 日,arXiv:2609.21267 — https://arxiv.org/abs/2609.21267
- Ruiying Ma 等,《Can AI Agents Answer Your Data Questions? A Benchmark for Data Agents》(DAB),2026 年 3 月,arXiv:2603.20576 — https://arxiv.org/abs/2603.20576v1
- Li 等,《Can LLM Already Serve as A Database Interface? A BIg Bench for Large-Scale Database Grounded Text-to-SQLs》(BIRD),2024 — https://bird-bench.github.io/
- Lei 等,《Spider 2.0: Evaluating Language Models on Real-World Enterprise Text-to-SQL Workflows》,2024 — https://spider2-sql.github.io/