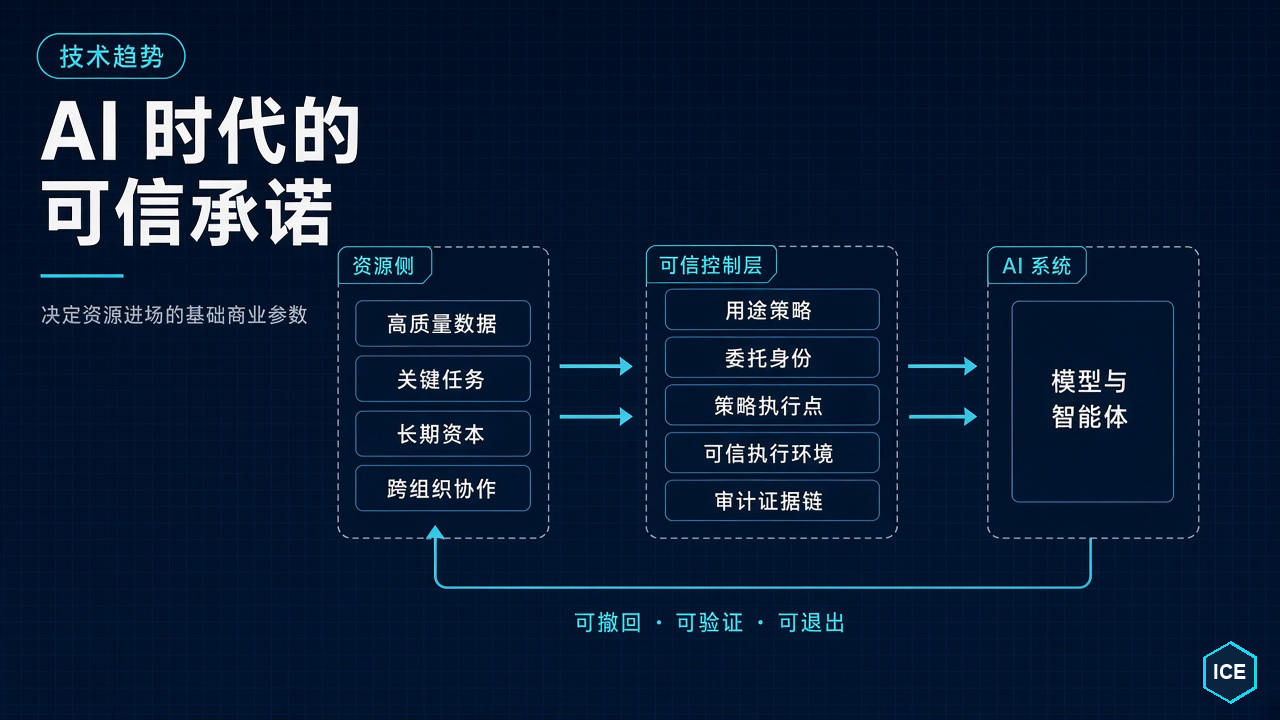
AI 时代的可信承诺:决定资源进场的基础商业参数
为什么工业革命首先发生在英国?
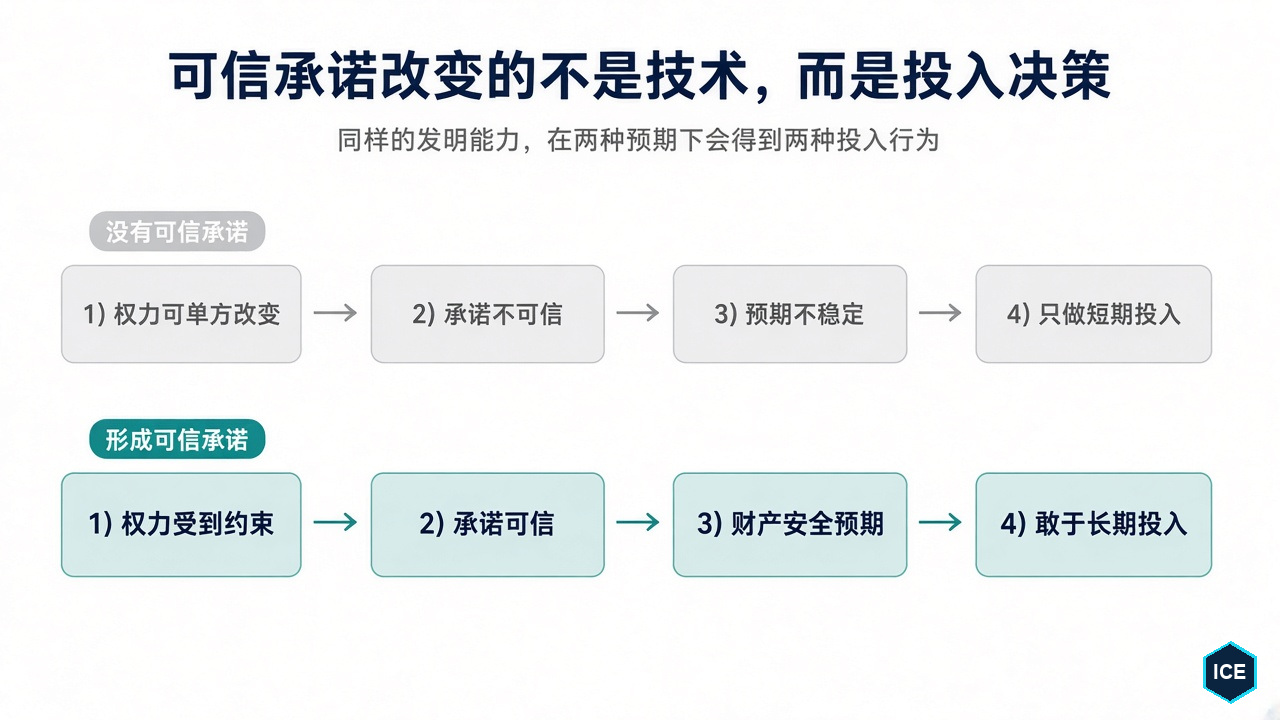
有一种影响很大的解释,不是从煤炭、机器或某位发明家讲起,而是从 1688 年的光荣革命讲起。它认为,光荣革命限制了王权随意征税、征收财产和改变规则的能力,相当于把权力关进了笼子。政府由此作出了一种更可信的承诺:私人财产不会被轻易夺走,今天达成的约定明天也不会被单方面推翻。
当人们对财产安全形成稳定预期,就更愿意把资本投入周期更长、风险更高的生产与创新。投资增加,技术试验增多,最终为工业革命创造了条件。这种从产权、制度约束和激励结构解释长期经济发展的思路,通常被称为制度主义。
这套解释最有启发的地方,不是证明“光荣革命直接带来了蒸汽机”,而是指出:一项技术能否真正进入生产,不只取决于它能不能被发明,也取决于人们敢不敢围绕它作出长期投入。
把这个视角移到今天,就得到了本文想追问的问题:AI 当前缺的,只是更强的模型吗?
制度主义真正提供了什么
诺斯和温加斯特在 1989 年提出,1688 年以后,王权单方面改变协议和征收财产的能力受到约束。制度由此回答了一个基础问题:统治者能否可信地承诺,今天答应的规则明天不会被随意改写。
这个解释并不是历史定论。后续研究指出,产权和私人信贷的改善在 1688 年以前已经出现;Robert Allen 也强调,高工资、廉价煤炭和工程能力共同决定了机器化在英国是否划算。制度主义不是工业革命的唯一答案。
但它留下的机制依然重要:可信不是一句保证,而是对单方面改变规则的权力形成约束。 参与者确信投入不会被随意夺走,才愿意进入长期、不可逆的安排。
顺着这个机制看 AI,第一个要问的就是:今天谁握着那种可以单方面决定的权力。
AI 时代的“王权”,不是某一家公司
我们习惯把“AI 的瓶颈”等同于“模型能力的瓶颈”:准确率不够高、幻觉仍然存在、推理还不够强。这些都是真问题,但不是全部。
很多关键资源迟迟没有进入 AI,不只是因为模型不够好,而是因为持有者无法确定交出去之后会发生什么。数据会不会被用于训练,权限会不会被继续放大,记录能不能带走,已经授出的权力还能不能收回。
这里的“王权”并不特指某一家科技公司,也不等于黑盒模型本身。它是一种更普遍的结构性权力:
资源一旦进入系统,接收方就能单方面决定如何保留、使用、复制和再分配,而提供方难以观察、验证或退出。
这种权力可能落在模型提供者、云平台、应用运营者或智能体编排者手里。主体不同,问题相同:资产与控制权发生了单向转移。
所以本文的中心论点不是“可信会让模型更聪明”,而是可信会让更多关键资源愿意进入 AI 系统。前者取决于架构、算力和训练;后者取决于数据、任务、资本和协作方愿不愿意入场。
可信的核心,是控制权不会一去不返
既然问题出在控制权的单向转移,可信承诺要约束的就是这种转移。它不是一句“我们会保护你的数据”,而是资源进入系统之后,原持有者仍然保留一部分控制能力。
这种控制对应着一次合作的三个时点:
- 进入之前,边界可知。 数据用于什么目的,是否进入训练或记忆,智能体拿到哪些权限。
- 运行之中,执行可验证。 系统是否真的守住了用途和权限,而不是只生成了一份日志。
- 结束之后,授权可撤回、参与者可退出。 后续访问能够停止,已复制的数据有明确处置路径,迁移时不会把全部历史和控制权留在原地。
第三点最容易被喊成口号,所以需要拆开看。撤销未来访问、删除已保存的数据、消除数据对模型权重的影响,这是三个难度完全不同的问题。前两者已有相对成熟的工程手段;第三个属于机器遗忘(Machine Unlearning),目前仍远不是可靠、普适的能力。
因此,“可退出是信任的前提”不等于一切都能恢复原状。它的实际含义是:参与者清楚哪些影响可以撤回、哪些不能,而且不可逆的部分在进入之前就被讲明。 承诺的可信度,恰恰取决于它是否承认自己的边界。
把这三个时点守住,机制链才会运转:不确定性和交易成本下降,更多高价值要素愿意进入;真实使用产生反馈,再推动能力和产业化演进。
当控制权可以收回,四类资源才会进入
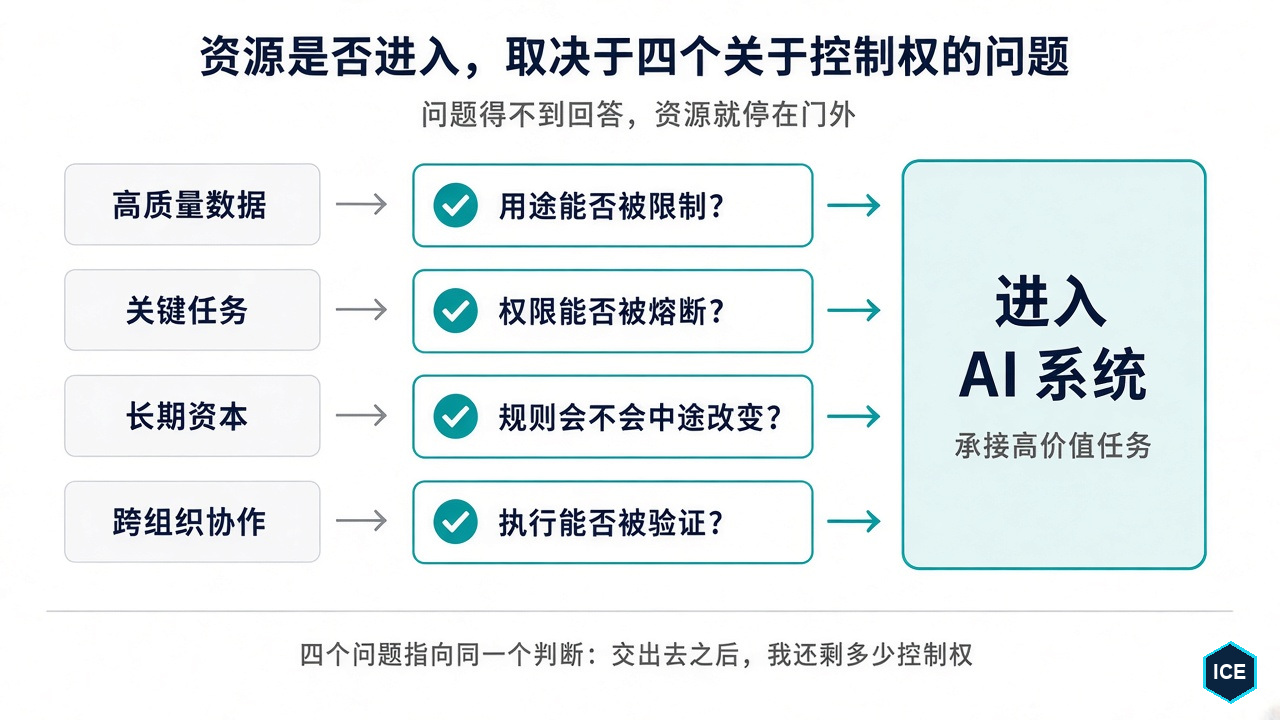
数据、任务、资本和跨组织协作,看起来是四类不同的入场决策,背后却是同一个判断:交出去之后,我还剩多少控制权。
数据是否进入,取决于用途能否被限制。 大量经业务长期沉淀的数据仍留在组织内部,原因往往不是技术上接不通,而是提供者无法确认它会不会进入训练、被二次转交,或在授权到期后继续被使用。可信机制增加的不是数据数量,而是让高价值数据在明确边界内参与计算。
任务委托有多深,取决于权限能否被熔断。 从“AI 给建议”到“AI 直接执行”,越靠近执行端,越需要知道它代表谁、能做什么、以及何时能被立刻叫停。可信决定的不是 AI 有没有入口,而是组织敢把多重要的事交给它。
资本是否愿意长期投入,取决于规则会不会中途改变。 数据基础设施、工具链和核心场景的回本周期都更长。稳定的责任与收益边界不会自动带来长期资本,但能减少一类本可避免的风险溢价。
跨组织协作能否扩大,取决于执行能否被验证。 委托身份、机器可读的用途策略、来源证明和审计记录,把一部分“相信对方不会乱来”,换成了“可以查对方有没有乱来”。
免责式合规,不等于工程化可信
讲到这里需要做一个区分,否则“可信”很容易被做成另一回事。
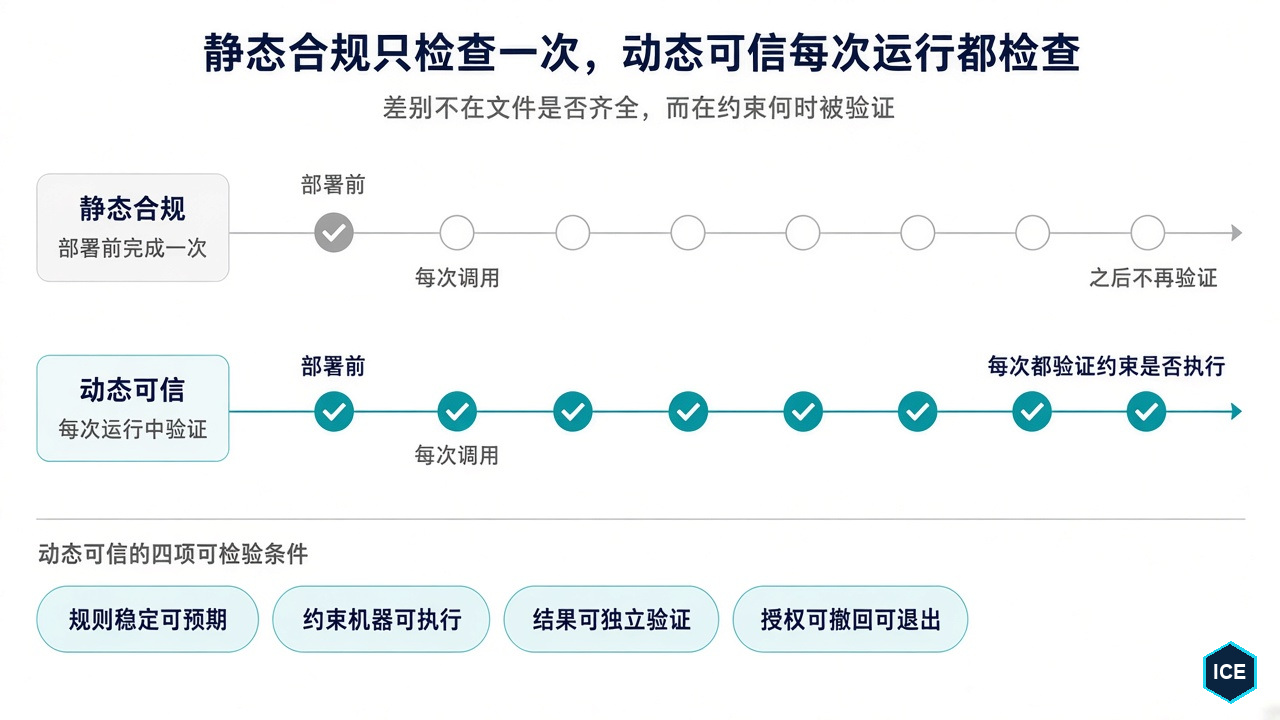
当前不少治理仍停留在静态合规:更长的用户协议、更多免责声明、更多审批节点,以及大量事后很难核验的日志。这套动作主要证明“流程已经走过”,本质上偏向单方面的责任免责,而不是向参与者作出双向承诺。
动态可信要回答的是另一个问题:这一次调用,约束到底有没有被执行。它不在部署前完成一次,而是在每次运行中接受验证。
两者的分野也解释了为什么可信不等于增加人工审批。审批越多,交易成本越高,速度越慢,最后往往只有扛得起合规成本的大机构能参与,用来降低不确定性的制度反而成了进入壁垒。有效的约束应当尽量交给机器执行,并留下可被独立核验的结果。
动态可信同样不等于零风险。模型仍会出错,规则也无法穷举所有情况。它提供的是清晰边界、执行证据和出错后的处置能力,而不是“永不出错”的保证。
这条路上还有两个容易踩的坑。一是集中式可信中介本身成为新的权力和锁定点;二是形式化日志只证明记录存在,并不能证明约束被执行过。一个缺少竞争、互操作和退出机制的“可信平台”,很可能重新制造出它原本要解决的那种单向控制权。
把前面三个时点翻译成可以逐条检验的条件,大致是四项:规则稳定可预期,约束能被机器执行,执行结果可被独立验证,授权可撤回且参与者可退出。 这也是判断一套可信方案是真做了还是只说了的最低标准。
信任正在从纸面走向代码
这些要求听起来很高,但并非空想。已经有几条技术路线在把承诺从条款变成可执行、可验证的约束。
用途控制策略把“只能用于什么、不能转交给谁”从合同文字变成机器可读规则,ODRL、数据空间协议和策略执行点都属于这条路线。它针对的是承诺能否在调用发生的那一刻被真正执行。
可信执行环境(TEE)用硬件隔离和远程证明,让外部参与者确认特定代码是否运行在受保护环境中。它不能证明业务规则本身正确,但能压缩“平台声称如此执行、外部却无法核验”的空间。
联邦学习与隐私计算让数据留在原处,只交换梯度、中间结果或计算输出。它们并不天然等于“可用不可见”:梯度仍可能泄露信息,参与方也依然要信任协议实现。但它改变了原始数据必须集中交付的默认做法。
可验证凭证、委托身份与审计证据链回答的是智能体代表谁、拿到什么权限、调用有没有越界,把抽象的责任主体落到每一次具体执行上。
这些技术各自只解决一段。TEE 替代不了用途规则,联邦学习替代不了责任归因,日志也不能自动证明执行正确。目前真正缺的,是它们之间的互操作,以及一套被跨组织共同接受的验证机制。
换句话说,部署了某项技术并不等于可信就成立。 可信仍要靠持续履约积累,但履约的方式正在改变:从“请相信我们的声明”,逐步变成“你可以验证系统如何执行”。
可信正在成为 AI 的基础商业参数
讨论可信,很容易落进伦理原则或合规成本的语境。但从产业角度看,它首先是一个商业参数:它决定什么数据愿意进入、什么任务敢于委托、什么资本愿意长期压上,以及哪些组织愿意坐到同一张桌子前。
缺少可信承诺,AI 依然可以展示能力,也能完成大量辅助性工作。但它被委托的深度会被卡住,很难进入那些控制权不能丢、责任必须说清、失败成本很高的核心流程。能力再强,也只能停在边缘。
反过来,当用途可控、执行可验证、授权可撤回、参与者可退出时,AI 才不只是一个更聪明的工具,而开始具备承接高价值任务的资格。
这正是“信任工程化”(Engineering Trust)要解决的问题,也是下一代 AI 基础设施的核心竞争点之一:不是要求参与者先去相信系统,而是让系统拿出足够的证据,使参与者不必只靠相信。
技术突破决定 AI 能做到什么;工程化可信决定数据、任务和组织愿意让它做到什么。
本文部分内容由 AI 辅助生成,经人工审校和补充后发布。
参考资料
- Douglass C. North, Barry R. Weingast. “Constitutions and Commitment: The Evolution of Institutions Governing Public Choice in Seventeenth-Century England.” The Journal of Economic History, 1989. https://ideas.repec.org/a/cup/jechis/v49y1989i04p803-832_00.html
- Steven Pincus, James A. Robinson. “What Really Happened During the Glorious Revolution?” NBER Working Paper 17206, 2011. https://www.nber.org/papers/w17206
- Robert C. Allen. The British Industrial Revolution in Global Perspective. Cambridge University Press, 2009. https://www.cambridge.org/core/books/british-industrial-revolution-in-global-perspective/29A277672CCD093D152846CE7ED82BD9
- Robert C. Allen. “Why was the Industrial Revolution British?” CEPR, 2009. https://cepr.org/voxeu/columns/why-was-industrial-revolution-british
- International Data Spaces Association. “Sharing data better makes AI work better and vice versa.” 2026. https://internationaldataspaces.org/sharing-data-better-makes-ai-work-better-and-vice-versa/
- International Data Spaces Association. “Autonomous AI agents acting safely within governed data-sharing environments.” 2026. https://internationaldataspaces.org/autonomous-ai-agents-acting-safely-within-governed-data-sharing-environments/
- W3C. “ODRL Information Model 2.2.” https://www.w3.org/TR/odrl-model/
- W3C. “Verifiable Credentials Data Model v2.0.” https://www.w3.org/TR/vc-data-model-2.0/
- Confidential Computing Consortium. “About Confidential Computing.” https://confidentialcomputing.io/about/
- H. Brendan McMahan et al. “Communication-Efficient Learning of Deep Networks from Decentralized Data.” AISTATS, 2017. https://proceedings.mlr.press/v54/mcmahan17a.html
- Ligeng Zhu, Zhijian Liu, Song Han. “Deep Leakage from Gradients.” NeurIPS, 2019. https://arxiv.org/abs/1906.08935
- Lucas Bourtoule et al. “Machine Unlearning.” IEEE Symposium on Security and Privacy, 2021. https://arxiv.org/abs/1912.03817