困惑度还在下降,模型的公平性为什么已经坍塌
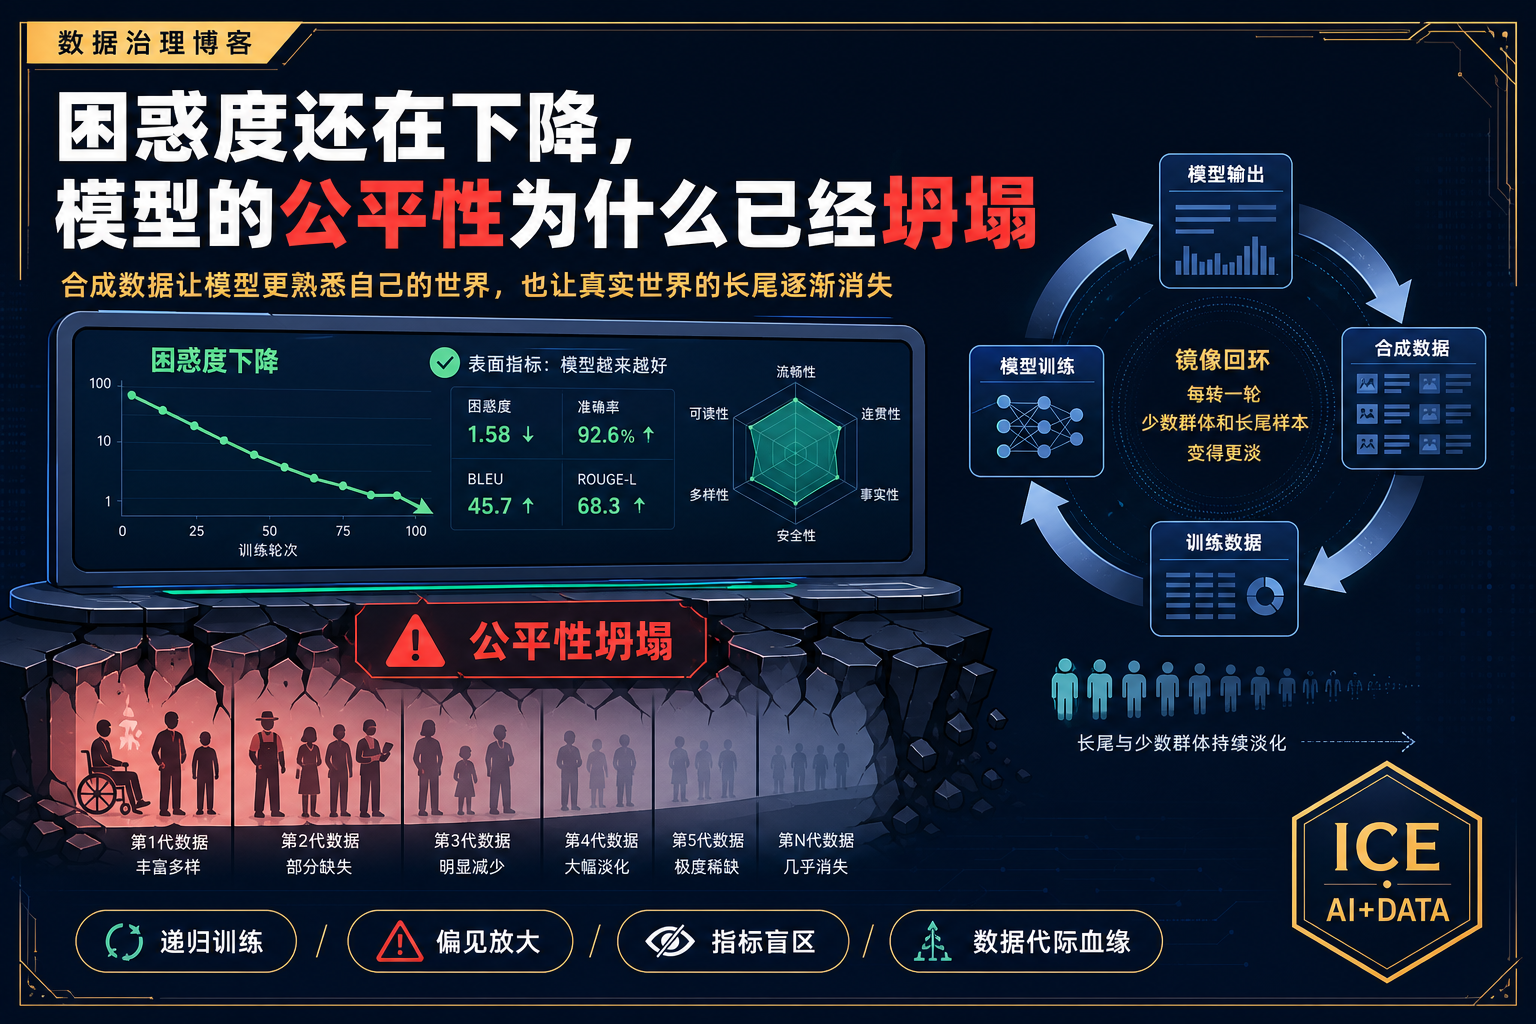
一个语言模型连续使用自己生成的数据训练五轮后,困惑度从 16.07 降到 10.55。
如果只看这项指标,模型似乎越来越好:它预测下一个词时更加确定,也更贴合训练语料。
但同一实验中,性别—职业的公平差距从 13.18 扩大到 19.38,第四轮一度达到 20.37;另一个公平性指标 SOFA 则从 0.509 升至 1.020,接近翻倍。
这不是模型同时变好和变坏,而是两个指标正在观察两个不同的世界:
困惑度衡量模型有多熟悉自己生成的数据;公平性衡量它是否仍能平等表示真实世界中的不同人群。
当模型不断把自己的输出写回训练集,它会越来越擅长预测一个由自己塑造的世界。这个世界内部可以非常一致,却可能越来越窄、越来越刻板。
论文把这种在常规性能警报响起之前发生的偏见放大,称为 “公平性坍塌”(Fairness Collapse)。
一、模型变好的只是一个指标
8 月发布的论文《The Fairness Collapse Phenomenon》使用 Qwen2.5-0.5B 和 Bias in Bios 职业传记数据集,构造了一个受控的递归训练实验。
研究者从约 30 万篇英文职业传记中选出 27,752 篇,覆盖 28 种职业,并平衡了职业分布。模型先在人类传记上训练,再用自己生成的合成传记继续训练五轮;每轮评测都使用独立保留的人类传记。
| 实验要素 | 设置 |
|---|---|
| 模型 | Qwen2.5-0.5B |
| 人类数据 | 27,752 篇平衡后的职业传记,约 200 万 token |
| 职业类别 | 28 种 |
| 合成方式 | 人类前缀续写与少样本生成 |
| 递归轮数 | 5 轮 |
| 主要公平指标 | Equal Opportunity Gap,越低越好 |
| 测试数据 | 独立保留的人类传记 |
在“人类前缀续写 + 递归污染”这组实验中,五轮变化如下:
| 指标 | 初始人类数据 | 第五轮 | 方向 |
|---|---|---|---|
| 困惑度 PPL | 16.07 | 10.55 | 表面改善 |
| MMLU | 42.14 | 32.08 | 明显下降 |
| 职业预测准确率 | 80.05% | 77.38% | 小幅下降 |
| EO GAP | 13.18 | 19.38 | 公平性恶化 |
| SOFA 偏见分数 | 0.509 | 1.020 | 接近翻倍 |
所以,“模型整体还在变好”并不准确。MMLU 已经下降了约 10 个百分点。真正反常的是:困惑度持续改善,职业预测准确率早期变化不大时,群体公平性已经明显恶化。
还要明确实验边界:它使用的是 0.5B 小模型、英文职业传记和性别—职业关联,不能直接证明所有前沿模型都会以同样速度坍塌。但它暴露的指标盲区是真实的:聚合性能没有下降,不代表不同人群受到的错误仍然相同。
二、模型为什么会越来越相信自己的偏见
合成数据不是凭空产生的。模型会根据训练数据中已有的统计关联,生成最像“合理答案”的文本。
如果原始数据中护士更多与女性关联、工程师和教授更多与男性关联,第一代模型会轻微放大这些高概率组合。生成结果进入下一轮训练后,原来的偏差就不再只是模型判断,而变成了新的“训练事实”。
循环由此形成:
- 原始数据包含不均衡关联;
- 模型生成更接近高概率模式的文本;
- 长尾和反常组合出现得更少;
- 合成文本被当作下一轮训练数据;
- 下一代模型把被放大的关联学得更牢。
论文观察到,护士等女性关联职业逐渐向更负的 EO 值移动,教授、软件工程师等男性关联职业则向相反方向漂移。模型不是随机产生新的偏见,而是在强化原数据中已经存在的方向。
这正是递归训练危险的地方:模型先把概率偏好变成文本,再把文本当作现实重新学习。
研究者还比较了两种机制。
迭代再生成每轮都从同一个人类训练检查点重新开始,只更换合成数据;其 EO GAP 最高达到 18.34。
递归污染不仅使用上一代合成数据,还继续更新上一代模型参数;其 EO GAP 最高达到 20.37,恶化更强、更持续。
这说明偏见有两条累积路径:一条写在数据里,一条写在模型参数里。只清理当前批次的合成文本,并不能消除模型检查点已经继承的偏差。
三、为什么困惑度没有发出警报
困惑度回答的是:模型对当前评测文本有多意外。
当训练数据越来越由模型自己生成时,语法、用词和职业叙事会越来越接近模型原有的概率分布。模型当然更容易预测这些文本,困惑度自然下降。
但这是一种内生改善。模型不是更接近真实世界,而是训练世界越来越接近模型。
传统数据质量指标容易漏掉三个问题:
- 聚合平均掩盖分群差异。 总准确率只下降 2.67 个百分点,不同性别在具体职业上的召回率差距却显著扩大;
- 流畅性无法衡量代表性。 文本可以更顺畅,同时让少数群体和反刻板样本逐渐消失;
- 同源评测制造镜厅。 如果训练集、验证集和评测集都来自相同模型家族,模型只是在用自己的标准证明自己正确。
这也是公平性坍塌比传统模型坍塌更危险的原因。传统坍塌最终会让输出质量下降,开发者迟早能在准确率和用户反馈中发现;公平性坍塌首先伤害的是分布尾部,主流样本上的体验甚至可能继续改善。
系统看起来更稳定,只是因为被它遗忘的人越来越少出现在平均值里。
四、数据血缘必须记录“被模型改写过几代”
现有数据血缘通常能够回答:
- 文件来自哪个网站或业务系统;
- 谁在什么时间采集和清洗;
- 哪个数据集生成了当前版本;
- 数据经过哪些作业与转换。
对合成数据来说,这些信息还不够。
两份文件都可以标记为“AI 生成”,但风险完全不同:一份可能由真实数据直接扩充,并经过专家筛选;另一份可能是第五代模型在第四代合成数据上继续生成的结果。把它们视为同一种来源,会丢掉最关键的风险信息。
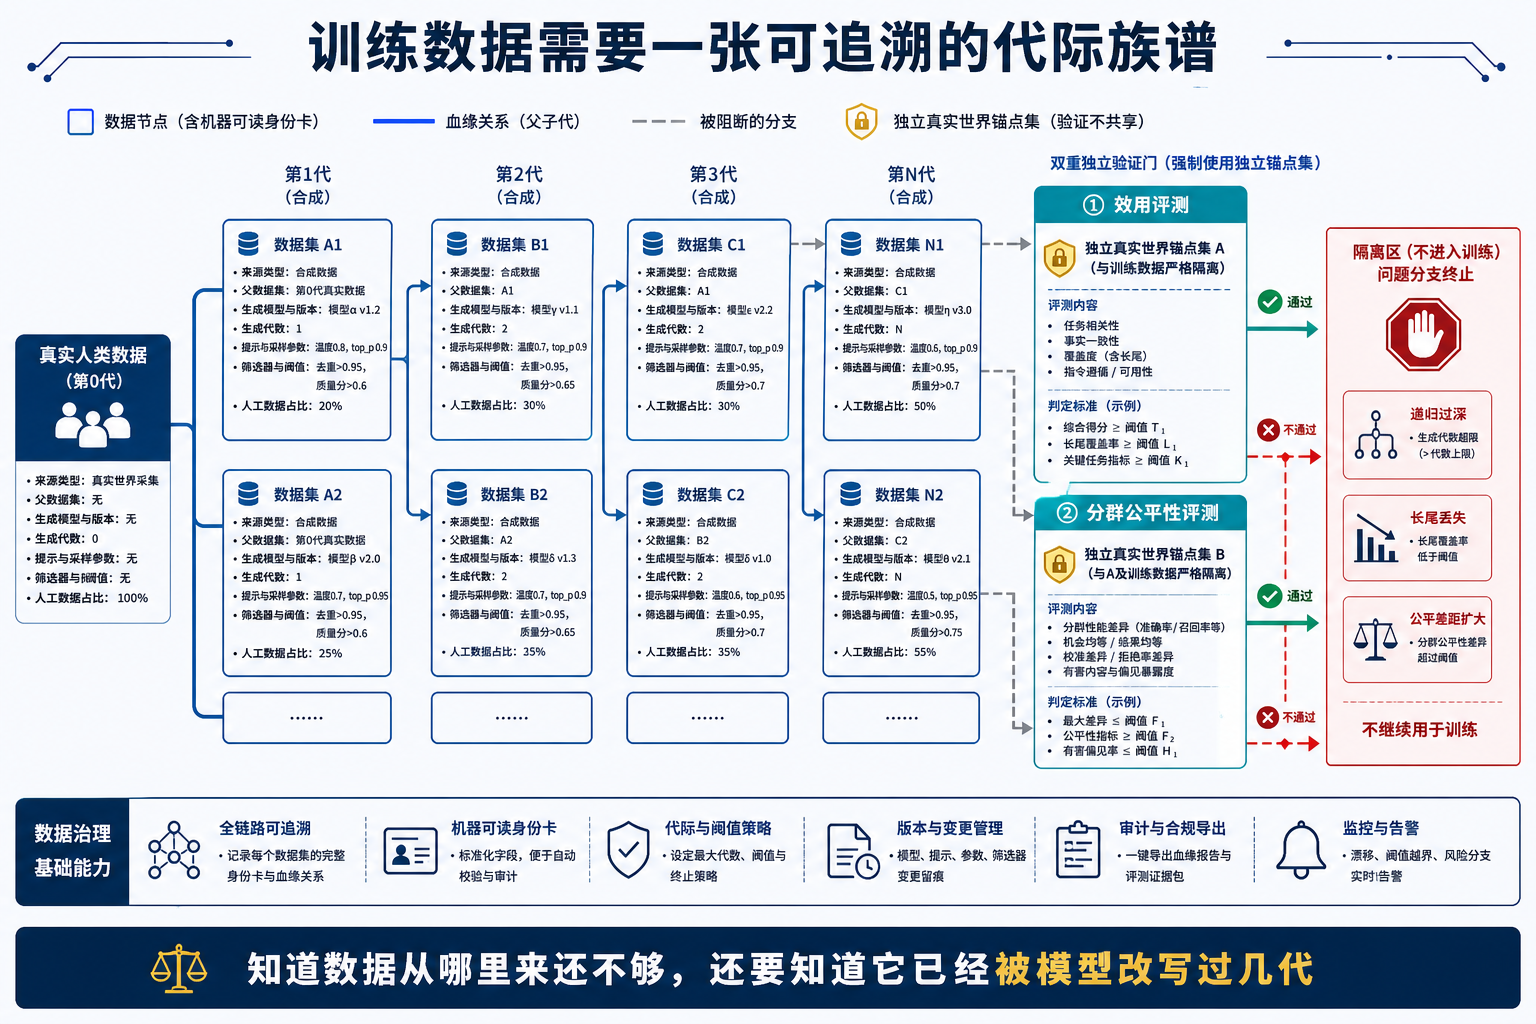
训练数据需要增加一层 代际血缘:
origin_type:人类、合成或混合;generator_model:生成模型、版本和检查点;parent_dataset:父数据集及其哈希;synthetic_depth:距离真实数据源经过多少代模型生成;generation_config:提示词、seed、温度和采样策略;filter_chain:筛选器、验证模型、阈值与人工复核;human_anchor_ratio:本轮保留的真实人类数据比例;fairness_profile:各敏感群体和长尾切片上的评测结果。
C2PA 已经能够为数字内容记录生成来源、修改动作和输入材料;欧盟《人工智能法》第 50 条也从 2026 年 8 月 2 日起要求生成内容具备机器可读标记。这些机制为识别合成内容提供了入口。
但“这段内容由 AI 生成”仍然不是完整的训练数据血缘。标记进入数据湖后必须被保留、聚合并传递到训练清单中;每次再生成都要增加代际深度,而不是覆盖原始来源。来源未知的网络文本也不能默认当作人类数据,只能进入“代数未知”的风险分区。
五、训练上线需要两道独立闸门
解决公平性坍塌,不能只增加一个合成数据标签。
第一道闸门检查 效用:困惑度、MMLU、任务准确率、事实性和长尾覆盖。
第二道闸门检查 分群公平性:不同性别、地区、语言、年龄或其他相关群体的召回率、错误率和表示差距。
两道闸门必须使用与生成模型隔离的真实世界锚点集。如果验证数据也来自同一个模型,评测会退化成一组相互确认的镜子。
工程上还应设置三条硬规则:
- 合成代数超过阈值的数据不得直接进入下一轮训练;
- 真实锚点比例不得随数据规模扩张而无限下降;
- 任何分群指标恶化,即使平均性能提高,也必须阻断发布或降低样本权重。
合成数据仍然有价值。它可以补充稀缺场景、保护隐私、构造压力测试,也可以主动增加被忽视群体的表示。问题不在于“是否使用合成数据”,而在于能否证明它来自哪里、经过几代、保留了什么,又删掉了谁。
结论
公平性坍塌揭示了一种比输出变差更隐蔽的失败:
模型可能越来越擅长预测自己创造的世界,同时越来越不擅长表示真实世界中的不同人。
困惑度下降并不虚假,它只是回答了一个过于狭窄的问题。只要训练数据不断向模型自身的分布靠拢,这个指标就可以持续改善,而长尾和少数群体已经从数据中悄悄退场。
因此,下一代训练数据治理不能止于“来源可追溯”。它必须进一步记录合成数据的父子关系、生成代数、模型版本、筛选过程和真实数据锚点。
知道数据从哪里来,只能证明它的出生地;知道它被模型改写过几代,才能判断它还保留了多少现实。
参考资料
- 《The Fairness Collapse Phenomenon: Bias Amplification in Language Models Trained on Synthetic Data》,arXiv:2608.04268,2026 年 8 月。https://arxiv.org/html/2608.04268
- Ilia Shumailov 等,《AI models collapse when trained on recursively generated data》,Nature,2024 年。https://www.nature.com/articles/s41586-024-07566-y
- Angelina Wang 等,《Fairness Feedback Loops: Training on Synthetic Data Amplifies Bias》,ACM FAccT,2024 年。https://dl.acm.org/doi/10.1145/3630106.3659029
- C2PA,《Implementation Guidance 2.3》,2026 年。https://spec.c2pa.org/specifications/specifications/2.3/guidance/Guidance.html
- European Commission,《Code of Practice on Transparency of AI-generated Content》,2026 年。https://digital-strategy.ec.europa.eu/en/policies/code-practice-ai-generated-content
- Ada Lovelace Institute,《Synthetic data, real harm》,2026 年。https://www.adalovelaceinstitute.org/blog/synthetic-data-real-harm/
本文部分内容由 AI 辅助生成,经人工审校和补充后发布。