别只数 GPU 卡:agentic 负载正在把瓶颈推回控制面
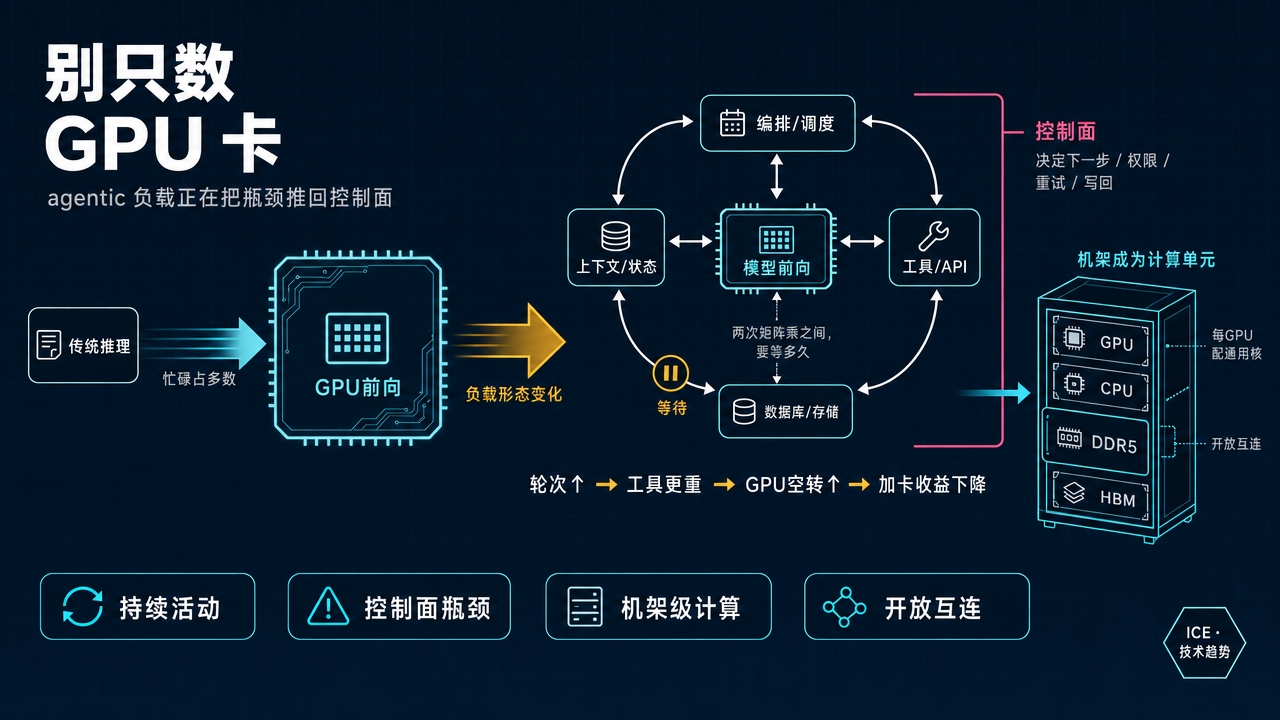
过去两年谈算力,基本等于数卡:有多少张 GPU、多少 HBM、多少 FP4 算力。这套记账方式对训练是成立的,对一次性的问答推理也大致成立。
但 agent 跑起来不是这个形状。9 月 12 日的一则报道里,AMD 高管 McNamara 与 Ramsay 讲了一段容易被当成套话、其实信息量不小的判断:agentic AI 改变了系统架构。过去的部署是线性的——web 服务器、应用服务器、数据库、存储、GPU 服务器依次串起来;而 agentic 系统是持续活动,多个 agent 并行,中间夹着控制面操作、API 调用、数据库查询和工具执行。
这句话翻译成工程语言就是:真正决定 agent 端到端有多快的,往往不是矩阵乘得多快,而是两次矩阵乘之间要等多久。 而那段等待,跑在 CPU、内存、IO 和调度器上。
本文按三步走:负载形态怎么变了,AMD 如何把这个判断写进产品线,以及「计算的基本单元」为什么正在从芯片挪到机架。最后单独一节把厂商口径和已验证事实分开——这类硬件叙事最容易在这一点上糊过去。
一、先把「控制面」说清楚
「控制面」这个词在不同语境里含义差别很大,这里指的很具体:一次 agent 循环中,除了模型前向计算之外的所有事情。 前向计算(forward pass)就是模型从输入一层层算到输出的那一趟,全是大矩阵乘法,也是 GPU 真正在干活的部分。
剩下的全归控制面:决定下一步做什么的编排逻辑、把工具描述拼进上下文、真的去调那个 API、等数据库返回、校验权限、把中间结果写回存储、失败后重试。这些活儿没有一件需要 GPU,但每一件都在 GPU 等着的时候发生。
差别在哪?一次传统推理请求的生命周期里,GPU 忙碌的时间占绝对多数,前后的 HTTP 解析和序列化可以忽略。而一个跑二十轮工具调用的 agent,模型每轮吐几百个 token,中间却要等一次数据库查询、一次代码执行、一次外部 API。轮次越多、工具越重,GPU 空转等待的比例就越高。
摊到时间轴上会更直观。假设每轮模型前向 0.5 秒、工具等待 2 秒:
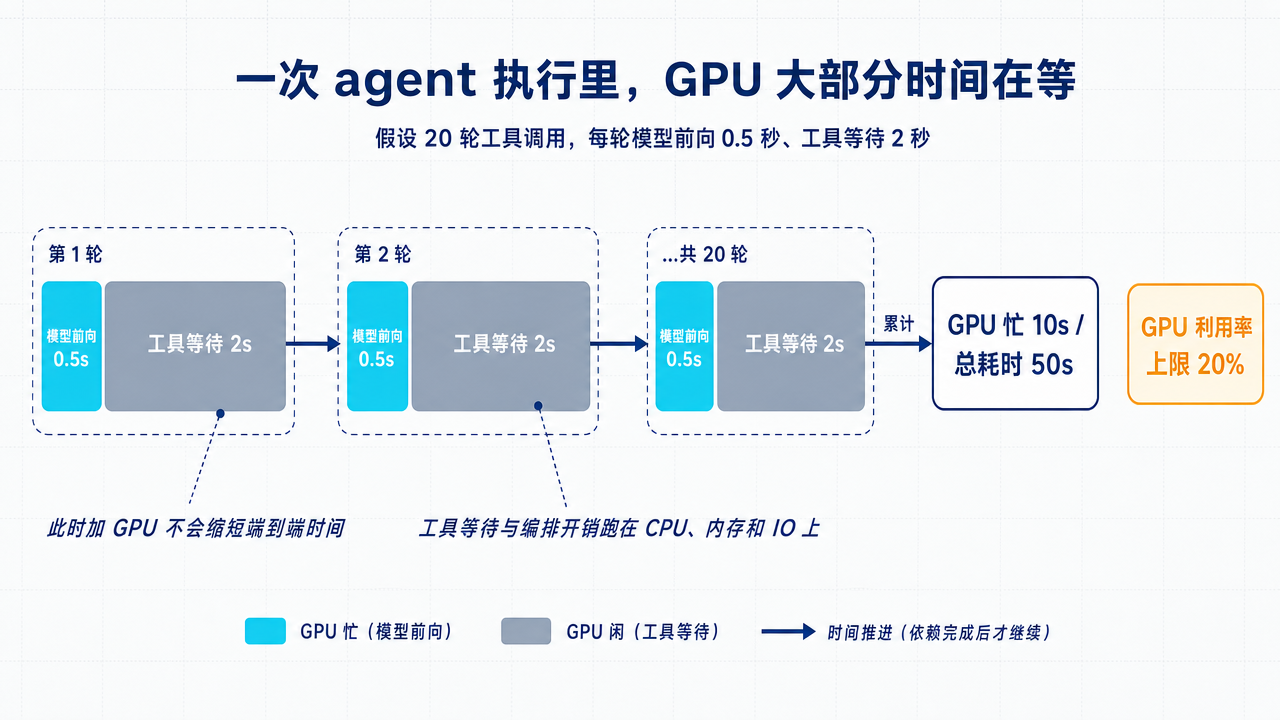
利用率的上限已经被工具等待钉死在 20%。 这时候「数卡」这套记账方式就开始失真了——把 GPU 从 8 张加到 16 张,如果时间都花在等工具返回和编排调度上,端到端并不会快一倍。
二、AMD 把这个判断写进了产品线
判断可以嘴上说,产品线是要花钱的。看 AMD 怎么切 SKU,比听它怎么表态更可靠。
7 月的 Advancing AI 2026 上,AMD 发布了第六代 EPYC 9006「Venice」,基于 Zen 6。旗舰 EPYC 9996 是 256 个 Zen 6c 核、512 线程、1024 MB L3 缓存,基频 2.55 GHz、加速 4.1 GHz,600W。次一级的 9966 是 192 核 / 384 线程、768 MB L3。用非紧凑的 Zen 6 核的型号最高 96 核,但频率能上到 5.0 GHz。
这里有个容易被跳过的细节:Venice 的计算芯粒用台积电 N2,IO die 用 6nm,每个 CCD 是 32 个 Zen 6c 核配 128 MB L3,也就是每核 4 MB,是上一代 Turin 的两倍。内存侧给到 16 通道 DDR5-8000,支持 MRDIMM 到 12800,带宽 1.6 TB/s;部分型号走 24 通道 LPDDR5X,用可现场更换的 SOCAMM2 模块。IO 侧是 PCIe Gen6,单路 128 lane、双路 160 lane,外加 CXL 3.1。
缓存翻倍、内存带宽拉满、PCIe 换代——这三样恰好都不是矩阵乘需要的东西,而是控制面需要的东西。上千个 agent 并发时,每个都在读写自己那份状态、拼自己那份上下文、等自己那次工具返回,吃的正是缓存命中率、内存带宽和 IO 通道数。
更直白的信号是 AMD 自己怎么划分这条产品线的用途。按 9 月那次表态,Venice 对应三类部署:
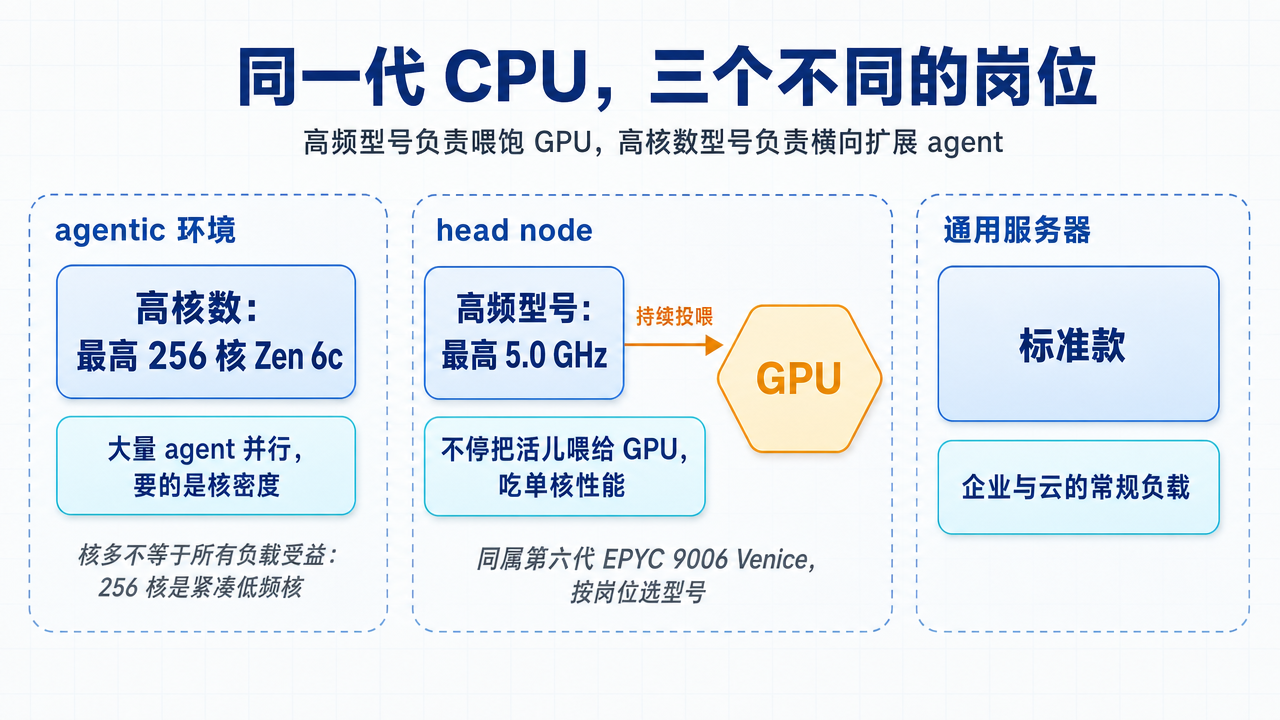
「高频型号专门用来喂饱 GPU」这件事,本身就是承认 GPU 会被喂不饱。 AMD 的产品页把这个定位写得更明白:用高频型号服务 AI host node,用高核密度横向扩展 agent。
完整产品线有四条:9006 SP7 是主线;9006 SP8 优化单节点性能;9006X SP7 就是带 3D V-Cache 的 Venice-X,L3 最高 1152 MB;还有 9006 LP「Verano」,用 LPDDR 内存,明确标注专供 AI host node。
不过节奏要看清:SP7 在 2026 年四季度出货,SP8 要到 2027 上半年,9006X 和 LP 都在 2027 下半年。 四条线里只有一条今年能到手,剩下三条还是路线图。
三、更大的变化:计算单元从芯片变成了机架
同一场发布会上,AMD 推出了 Helios 整机柜方案,现已满产、三季度末开始出货。微软已宣布会在自己的数据中心部署。
先看它由什么组成:
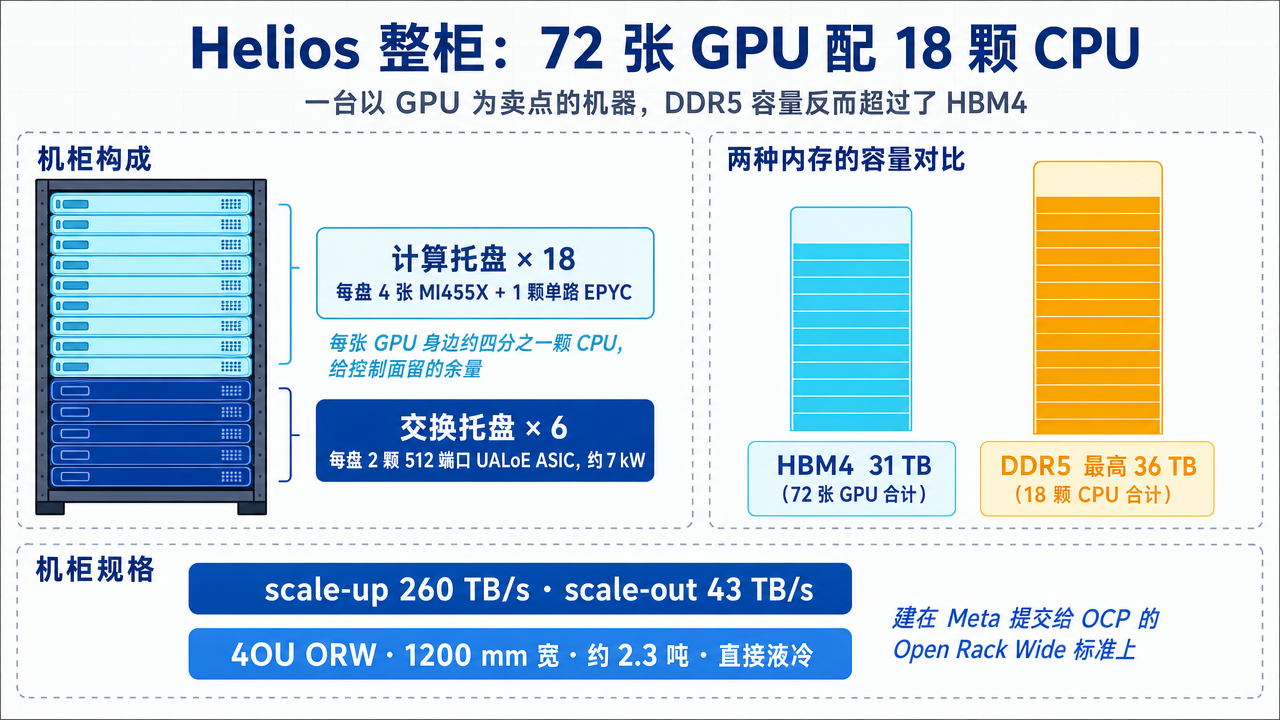
算力参数同样可观:单张 MI455X 是 432 GB HBM4、23.3 TB/s 带宽、40 PFLOPS FP4;整柜内存总带宽 1.7 PB/s,峰值 2.9 EF FP4、1.4 EF FP8。
但真正值得停一下的是那组内存对比:一台以 GPU 为卖点的机器,普通内存(最高 36 TB DDR5)的容量反而超过了高带宽内存(31 TB HBM4)。 这不是凑巧,是给控制面和数据搬运留的地方。
还有一个可以直接推算的比例:72 张 GPU 配 18 颗 CPU,每张 GPU 身边有四分之一颗 CPU;若按旗舰 256 核配置,等于每张 GPU 配 64 个通用核。这个推算依赖具体 SKU,实际部署会有差异,但量级说明了问题——设计者认为每块加速器旁边需要相当可观的通用算力待命。
机柜内部的连接同样是重投入。按 Hot Chips 2026 披露的细节,交换托盘里那两颗 512 端口 200G 的 UALoE ASIC 单向能跑 10.8 TB/s,管理面用一颗 Ryzen 做 BMC。AMD 也提到,scale-up 这一跳目前还是电互连,正在接近向光互连过渡的临界点。
值得注意的是标准选择。Helios 建在 Meta 提交给 OCP 的 Open Rack Wide(ORW)标准上,是这个标准的首个采用者;scale-up 用 UALink over Ethernet,scale-out 对齐 Ultra Ethernet Consortium。AMD 在这里押的是开放标准而不是自家专有 fabric,这对采购方的含义比性能数字更实在:不至于被单一互连技术锁死。
AMD 官方技术博客里有一句话把这件事说得最干脆:计算的基本单元不再是芯片、甚至不是服务器,而是机架。这话从一家以卖芯片为主业的公司嘴里说出来,是个转向。9 月那次表态也印证了:公司定位正从半导体供应商挪向机架级系统与软件提供商,内部从「管单个产品路线图」改成「协调一张跨 CPU、GPU、网络的数据中心路线图」,并预计 2027 年数据中心业务翻倍以上。
四、哪些是厂商口径,哪些还没有答案
前面的构成参数和出货时间是公开规格,而下面这些数字全部来自 AMD 自己的方法论文档,不是第三方实测,读的时候要打折:
AMD 称 Helios 对比英伟达 Vera Rubin NVL72,峰值 FP4 高 15%、HBM 容量高 50%、HBM 带宽高 6%、scale-out 带宽高 50%,每美元 token 最多高 30%。CPU 侧,AMD 称在 100 kW 机架功耗约束下,双路 EPYC 9996(合计 512 核)对双路英伟达 Vera(176 核,Olympus 平台)有优势,口径是六个负载的几何平均——SPECrate 2017_int_base、Server-Side Java 多 JVM、NGINX 网页服务、Redis、Memcached 和 TPROC-C。媒体转述的「对 Intel Xeon 最高 3.4 倍、对 Vera 约 20%」也出自这套口径。
这些负载有意思的地方在于:它们全是传统服务端负载,没有一个是 agent 工作流。 这恰好暴露了当前最大的空缺——
agentic 负载至今没有公开的标准 benchmark。 「CPU 与控制面正在成为新瓶颈」这个判断,目前的支撑主要是厂商表述和架构推理,而不是第三方可复现的实测。我倾向于认为这个方向是对的,因为它和 agent 的执行形态吻合;但必须承认,现在还没有一个大家公认的测法能把「GPU 空转等工具」这件事量化成一个可比数字。
另外两条边界也要说清:
第一,256 核用的是 Zen 6c,是紧凑低频核,旗舰基频只有 2.55 GHz。核多不等于所有负载线性受益——串行的编排逻辑该看的是高频那条线,不是核数那条线。
第二,这套东西大部分还没真正落地。英伟达仍是市场主导;Helios 以参考设计的形式交给合作伙伴,规模部署才刚起步,微软宣布部署是个强信号,但一两个客户不构成生态。
ICE 观察
🔧 技术视角
如果这个方向成立,容量规划的第一个问题就不该是「买几张卡」,而是「GPU 有多少时间在等」。
这个指标值得先测,因为它不用换任何硬件就能得到,而且结果往往不好看。在它变好之前,加卡改善的只是账单——真正该动的是工具调用的并发度、缓存策略和超时设置,而这些全在控制面上。
🏢 落地视角
给几个马上能查的点:把 agent 的一次完整执行按「模型前向 / 工具等待 / 编排开销」三段打点,看三者占比;查 head node 的主频而不只是核数;查每张 GPU 分到的 CPU 核数与内存带宽;查 PCIe 通道有没有被网卡和存储挤占。
要注意的是,机架化采购会抬高一次性门槛。约 2.3 吨的整柜、直接液冷、7 kW 的交换托盘,意味着这不是「再插几张卡」式的升级,而是机房层面的改造——供电、承重、冷却都要重新算。对多数团队来说,Helios 的价值不在于它是件可采购的商品,而在于它给出了一个配比参考:每块加速器旁边该留多少通用算力。
💼 商业视角
AMD 的动作是在改变自己被评价的方式:从比单芯片性能,转向比整柜的 token 每美元。这对它有利,因为整柜口径能把 CPU、网络、软件的优势一起计入;但也把交付难度抬高了——卖机架要管液冷、供电、现场维护和软件栈,这些都不是芯片公司的传统强项。
押开放标准(ORW、UALink、UEC)是这盘棋里更聪明的一手。它降低了客户的锁定顾虑,也把竞争焦点从「谁的专有 fabric 更强」挪到「谁的整柜更划算」——后者是 AMD 更愿意打的仗。
结论
- 负载形态变了,记账方式得跟着变。 agent 是持续活动而非一问一答,端到端时间被工具等待和编排开销大量占据。继续只数 GPU 卡,会系统性低估控制面的约束。
- AMD 的 SKU 切法是比表态更硬的证据。 高核数给 agent 横向扩展、高频型号专门喂饱 GPU、缓存每核翻倍、PCIe 换代——这些都指向控制面,而不是指向算力峰值。
- 计算单元正在从芯片变成机架。 Helios 里 DDR5 容量超过 HBM4、72 张 GPU 只配 18 颗 CPU,都是这个判断的物证;而押 ORW 和 UALink 这类开放标准,让整柜采购不必绑定单一 fabric。
- 最该补的是测法,不是硬件。 这个方向缺的不是产品,是一个公认的 agentic benchmark。在它出现之前,厂商的所有对比数字都只能当参考。
所以,在考虑加卡之前,不妨先回答一个问题:
你的 GPU 利用率上不去,是因为卡不够,还是因为它一直在等工具返回?
参考资料
- AMD Newsroom. AAI 2026: AMD Launches AMD Helios Rackscale Solution for Frontier AI. 2026. newsroom.amd.com
- AMD. AMD EPYC 9006 Server CPUs for AI-First Data Centers(产品页与性能口径说明). amd.com
- AMD ROCm Blogs. CDNA 5 and the AMD Helios Rackscale Solution. rocm.blogs.amd.com
- TechPowerUp. AMD Announces 6th Gen EPYC Server Processors Powered by "Zen 6" Microarchitecture. 2026. techpowerup.com
- Tom's Hardware. AMD's 256-core Epyc 9996 'Venice' claims up to a 3.4x jump over Intel Xeon competition. 2026. tomshardware.com
- Phoronix. AMD EPYC 9006 Venice Announced & Looks Poised To Be A Grand Slam. 2026. phoronix.com
- Data Center Dynamics. AMD officially launches Helios rackscale system, with MI455X GPUs, Venice Epyc CPUs, and Pensando. 2026. datacenterdynamics.com
- NC Labs. AMD unveils Helios MI400 architecture at Hot Chips. 2026. nc-labs.com
- AMD Expands Into Rack-Scale AI as Agentic Workloads Boost CPU Demand. 2026-09-12. thelincolnianonline.com
- XPU.pub. AMD Scales Epyc 9006 "Venice" to 256 Cores and 1 GB of L3 Cache. 2026. xpu.pub
本文部分内容由 AI 辅助生成,经人工审校和补充后发布。