机密 AI 的执行点:密钥释放之前,CPU 与 GPU 必须证明彼此绑定
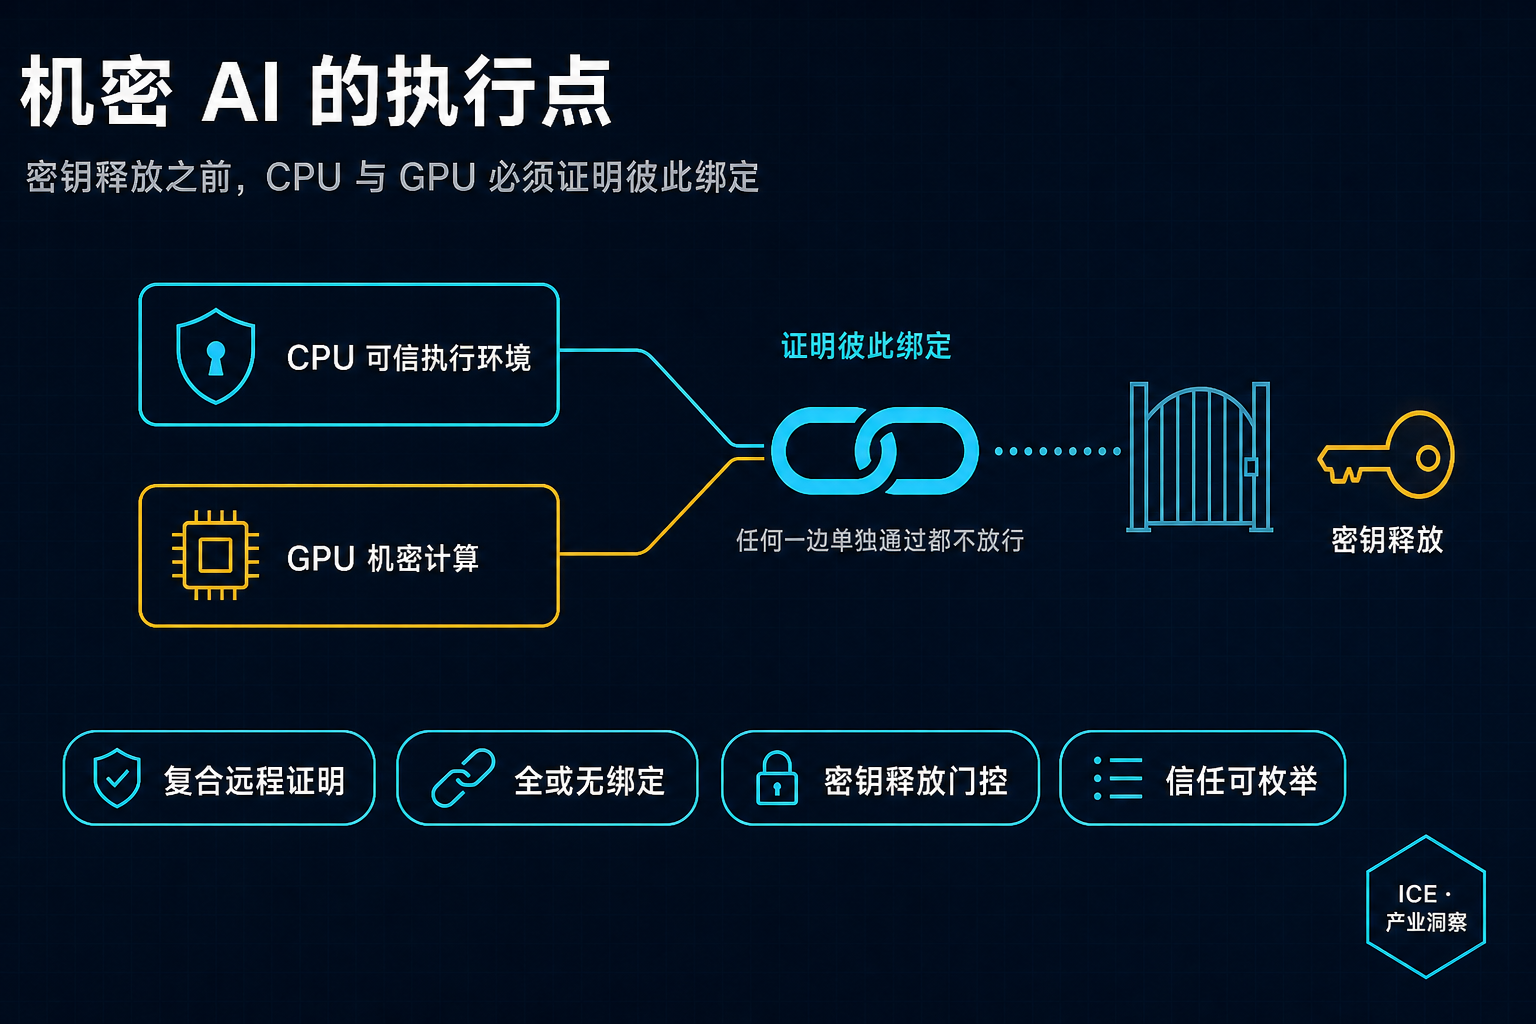
7 月 19 日,一份 IETF 草案(draft-kykdxy-rats-tdx-cgpu-ear-profile-02)由微软、英特尔、NVIDIA 三家的六位作者共同提交,为「TDX 机密虚拟机 + 机密 GPU」定义了统一的证明结果格式。它要解决的事情一句话说得清:在把密钥交出去之前,让 CPU 和 GPU 各自出示硬件签名的证据,并且证明彼此绑定;整体通过才放行,任何一边单独通过都不算。
这套东西的性能账也算清楚了,代价集中在一处:在 B300 上,BF16 矩阵乘法是非机密模式的 0.998 倍——基本无损;但在同一个 CUDA 上下文里,数据从系统内存搬进显存的速度掉到 0.203 倍。
机制成立、代价也可控——到这一步,「机密 AI」听起来已经是个可以签单的方案。但把草案自己写明的那几条信任假设,和过去一年的攻击文献放在一起读,会发现它证明的范围比它给人的印象窄得多。本文分五节:前两节讲机制、声明结构和执行点,第三节算代价,最后两节讲它没有证明什么、以及信任实际去了哪里。
一、光验 CPU 没有意义
机密计算这套体系是围绕 CPU 建起来的:加密内存、度量启动、远程证明,主体都在 CPU 侧。但 AI 推理不在 CPU 上发生——模型权重、激活值、中间计算全都在 GPU 显存里,数据在那里被处理,输出也在那里生成。于是「证明这份工作负载跑在一个未被篡改的环境里」这句话,如果只覆盖 CPU,等于把最要紧的那一段留在证明范围之外。
复合证明的关键不是分别验两边,是把两份证明绑成一条链。 GPU 和 CPU 一样能生成硬件签名的报告,证明自己的身份、固件状态和安全配置。草案采用的模型是:多个由硬件背书的证明方各自提交证据,由验证者核验并合并成一份结果;成功的验证意味着这些组件构成单一、统一的信任域,从而阻止组件替换和部分失陷。语义写得很硬,用的词是 all-or-nothing——依赖方只应在验证者确认「全部组件都已绑定且可信」时才释放秘密。
对应到声明结构上,有两个字段承担这件事。ear_all_submods_bound 说明所有子模块是否可证明地彼此绑定,取值是 true / false / unknown;聚合状态 ear_status 的口径是取所有组件的最低基线——最弱的那一环决定整体结论。
洞见一:难的从来不是验证,是绑定
分别验证 CPU 和 GPU 在技术上早就能做。真正的攻击面在中间——如果两份证明之间没有密码学绑定,攻击者可以拿一台真机的 CPU 证明配上另一处的 GPU 证明,拼出一个从未同时存在过的「可信环境」。所以这份草案的主体不是「怎么验」,而是怎么让「它们是同一台机器上的同一次执行」这件事本身变成可验证的。而它给绑定状态留了 unknown 这个取值,等于承认这一步并不总能做到。
再往下看证据本身。草案把它分成三个子模块,各自证明不同层次的东西。
| 子模块 | 证明什么 | 代表性声明 |
|---|---|---|
tdx | CPU 侧可信执行环境的度量与版本 | tdx_mrtd(初始内容度量)、tdx_mrseam(TDX 模块度量)、tdx_rtmr0–rtmr3(运行时可扩展度量寄存器),均为 48 字节;tdx_report_data 有 64 字节自定义空间,可放 nonce 或公钥;tdx_tee_tcb_svn、platform_instance_id |
cvm_guest | 客户机操作系统的启动与加固状态 | 一长串 TPM 布尔量:secureboot、tpm_hvci_policy、tpm_kerneldebug_enabled、tpm_testsigning_enabled、tpm_signingdisabled、tpm_debuggersdisabled、tpm_dbxvalidated、tpm_elam_enabled 等 |
c-gpu | GPU 的身份、固件与证书链 | ear_nvidia_evidence.signature_verified(SPDM 响应签名是否验过)、cert_chain(从根到端实体逐证书的声明)、ear_nvidia_purpose(防止为其他用途签发的证明被误用) |
tdx_report_data 那 64 字节值得单说:它让证明报告可以把一个公钥「钉」进硬件签名的内容里,于是「这份证明属于这次会话」和「这把公钥属于这个环境」变成同一件事——密钥投递的安全性就建在这上面。而 ear_nvidia_purpose 解决的是另一类问题:同一块 GPU 可以为基础设施证明带外应答,也可以为 CC-TDISP 之类模式带内应答,这个声明让依赖方能确认自己拿到的不是一份为别的用途签发的证明。同一把签名密钥、同样有效的报告,用在错误的语境里就是漏洞。
cvm_guest 那一栏最能说明这套体系的实际形态:它不是一个抽象的「安全/不安全」判断,是二十来个具体开关的当前取值——安全启动开没开、内核调试器关没关、测试签名允不允许加载、代码签名强制有没有被停用。
洞见二:硬件会诚实地为一个不设防的配置签名
tdx 子模块里有一个声明叫 tdx_td_attributes_debug。草案对它的说明是:该布尔值表示信任域是否运行在调试模式,而在调试模式下,CPU 状态和私有内存可被宿主机的 VMM 访问。也就是说,证明报告会用无可置疑的硬件签名,如实告诉你「这台机器的机密性现在是关着的」。签名有效,报告真实,保护为零。
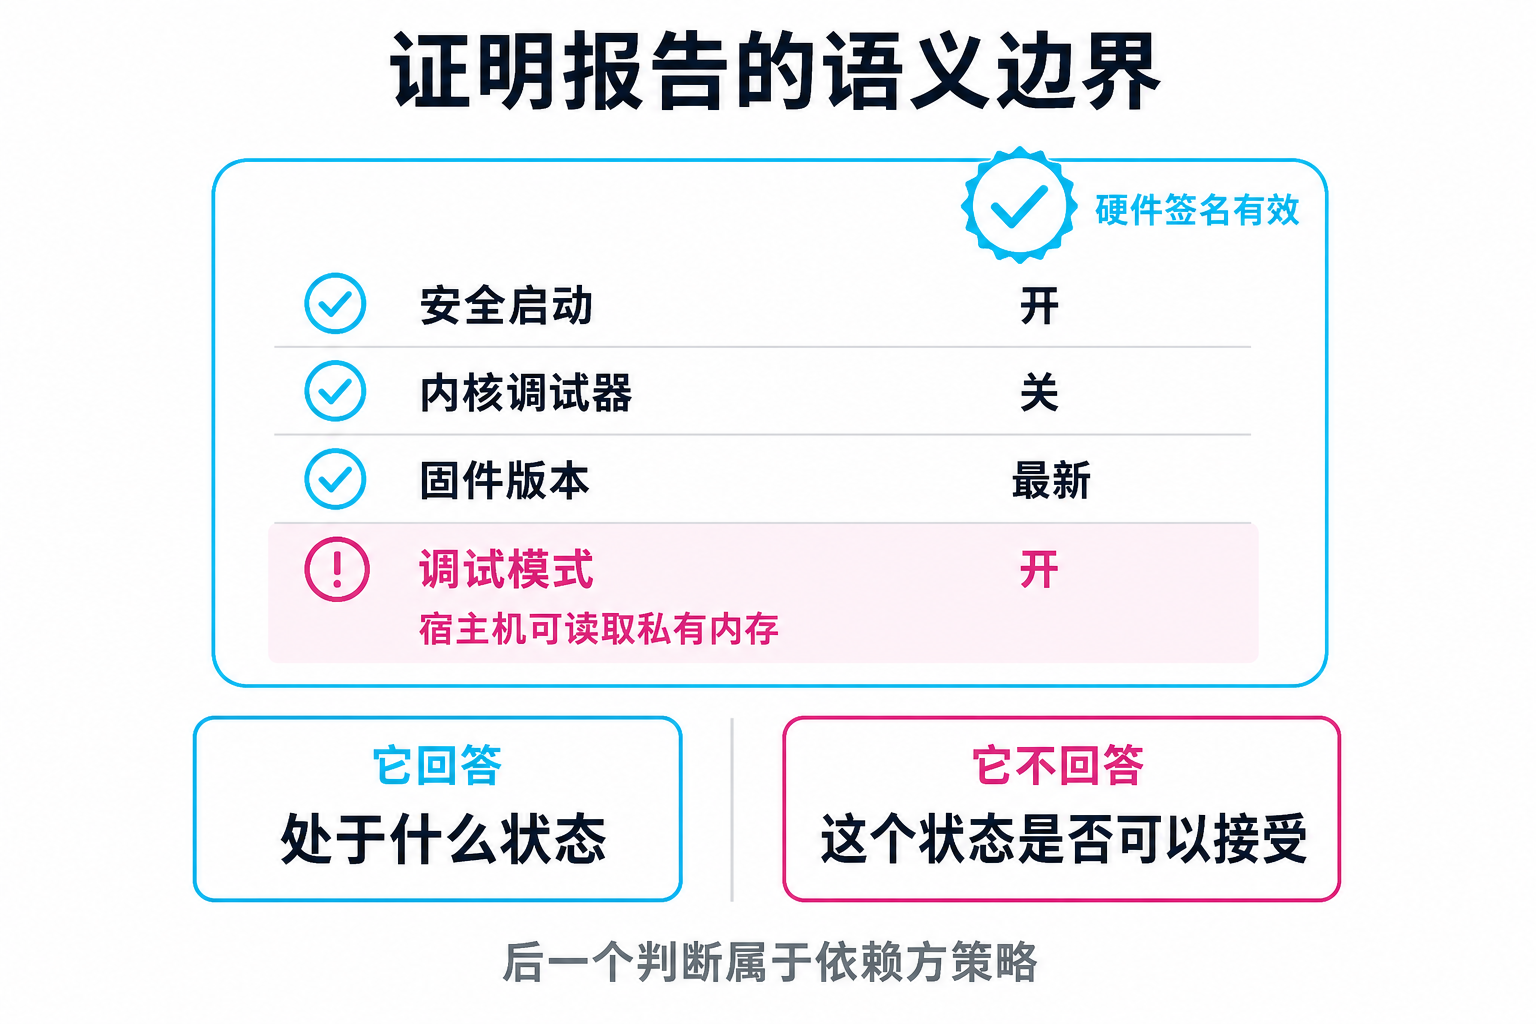
这件事的含义比它看起来大:远程证明回答的是「它处于什么状态」,不回答「这个状态是否可以接受」。后一个判断属于依赖方的评估策略——ear_appraisal_policy_ids 就是给策略留的位置。于是信任并没有被消除,它被搬到了写策略的人身上。一份复合证明全绿、而工作负载跑在调试模式下,在这套体系里是完全自洽的结果。
二、执行点在密钥释放那一刻
这套机制真正咬合的地方,是一个叫 ear_managed_keysets 的声明:验证者代表证明方从证据中提取出一组或多组命名密钥集(例如 ephemeral-transfer-keys,格式是 RFC 7517 的 JWK),供依赖方把秘密投递进已验证的可信计算基。
把这一条和零数据留存那篇的困境对上,就能看出结构上的变化。那篇的结论是,当「不保存」变成「我们看不见」,可验证性就从合同条款挪到了尚未公开的实现细节上。当时 OpenAI 的方案是内容存在客户基础设施、或者存在厂商基础设施但用客户持有的密钥加密。问题在于:客户凭什么相信这把密钥只会在承诺的条件下被使用?
复合证明给出的答案是把条件前移:密钥不是「按承诺使用」,是「不满足硬件证据就拿不到」。「我们看不见」从一句需要相信的话,变成一个在密钥释放之前必须被满足的前置条件。
但草案自己写明了三条信任假设,每一条都是一道缝。
第一条是时间:信任模型假设 TCB 在开通之后是静态的,任何带外变更——它举的例子是热插一块新 GPU——都违反信任契约、必须被阻止,因为复合证明结果只反映取证那一刻的安全状态,不支持异步更新,要更新就得完整重新证明。
第二条是新鲜度的口径:c-gpu 子模块里对 eat_nonce 的说明格外克制,这个 nonce 代表的是证据的新鲜度,不是 NVIDIA 验证者响应的新鲜度。
洞见三:check 的时刻和 use 的时刻之间始终有缝
这是安全工程里的老问题(time-of-check to time-of-use),但在这里它不是实现缺陷,是被写进信任模型的前提。证明说的永远是「取证那一刻它是干净的」,而工作负载要跑几小时甚至几天。这条缝没法靠更好的密码学关掉,只能靠两件工程手段压窄:缩短重新证明的周期,以及把「任何拓扑变更都必须触发重新证明」做成硬约束而不是运维规范。买这套方案的时候,要问的不是「你们支持远程证明吗」,是「多久重新证明一次,以及热插一块卡会不会被拦住」。
第三条假设决定了这套标准现在能盖住多少真实工作负载:为防止横向数据泄漏,TCB 内的每一块 GPU 都把依赖方释放的秘密限制在自己的隔离执行环境内;通过 NVLink 之类点对点接口与其他 GPU 共享机密数据,在这个信任模型里被假定为不允许。
而大模型服务的实际形态正是跨卡——下一节那份基准里,四卡与八卡的张量并行、以及加密集合通信占单步时间的份额,都是主要变量,而 Blackwell 这一代恰恰开始加密 GPU 之间的 NVLink 连接。硬件层面加密 NVLink,和某份 profile 的基础场景不建模跨卡秘密共享,是两个层次的问题,不必然矛盾;但缺口是真实的:草案明确说自己不建模部分信任图,而多卡服务需要的恰好是一张图——哪几块卡属于同一个信任域、秘密可以在其中的哪些边上流动。
洞见四:被标准化的是结果格式,还没被标准化的是多卡的信任图
这份 profile 的价值在于让多个验证者输出同一种结构,省掉依赖方为每家写一套解析——草案自己说的动机就是这个:不同依赖方受不同的业务和监管要求约束,可能需要用不同的验证者。这是实打实的互操作性收益。但它目前给出的是一个「单一、统一的信任域」的全或无判断。从「一台机器可信」到「这八块卡构成一个可信域、且秘密只在域内流动」,是下一版要解决的问题,不是这一版已经解决的问题。
三、账不记在计算上,记在跨越上
性能这块的公开测量在 2026 年才补齐,结论比「机密计算很慢」精细得多。
| 测量对象 | CC 开 / CC 关 | 说明 |
|---|---|---|
| B300 BF16 矩阵乘法 | 0.998× | 计算本身基本无损 |
| 串起 96,000 次矩阵乘法的 CUDA graph | 1.0012× | 长图几乎无损 |
| 1 GiB 显存级搬运 | 0.912× | 大块传输尚可 |
| 同一上下文内 系统内存→显存(H2D) | 0.203× | 掉到五分之一 |
| 同一上下文内 显存→系统内存(D2H) | 0.211× | 同上 |
| 小跨越的固定开销 | 约 330 微秒 / 次 | 与数据量无关的过路费 |
| 推理吞吐损失:配置正确 | 1–3% | MiniMax-M2.7(229B MoE)四卡 B200 约 1.5% |
| 推理吞吐损失:默认配置 | 30–40% | 属于可避免的配置问题,不是能达到的运行点 |
| 出词延迟(ITL)增加 | 约 1% ~ 超过 100% | CC 感知引擎约 1%;CC 无感知且计算受限约 30%;低并发下超过 100% |
| 训练吞吐损失 | 18–32% | |
| 算力、能耗、可用显存 | 不受影响 |
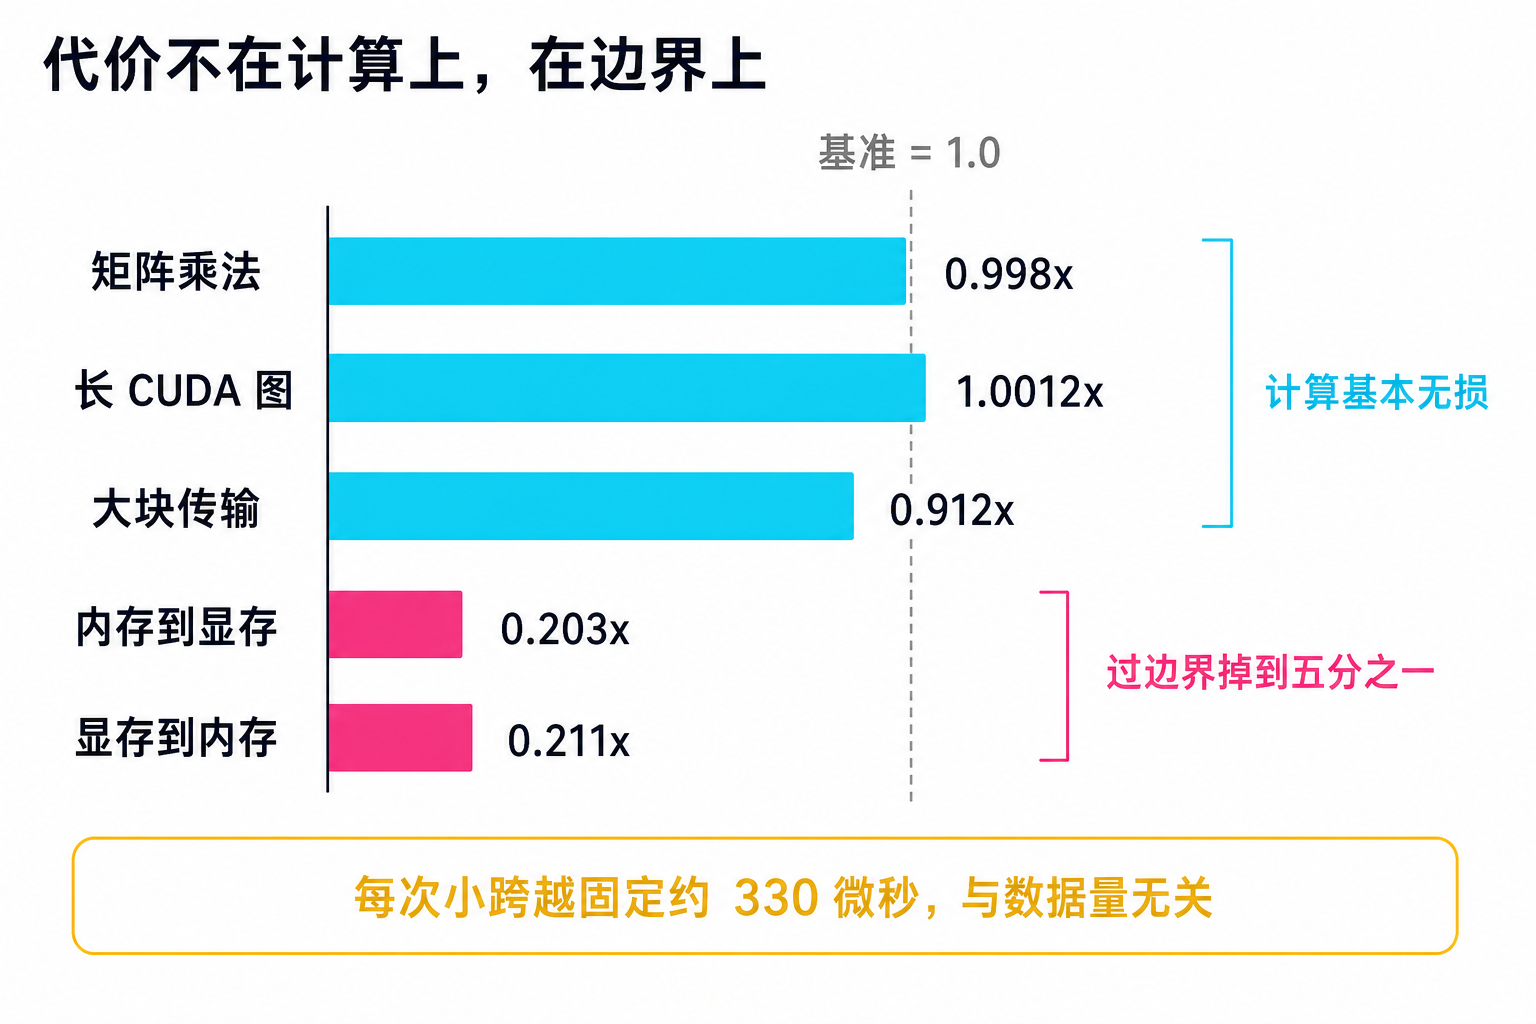
形状很清楚:张量核心和显存带宽基本没有损失,真正变成稀缺资源的是机密虚拟机与 GPU 之间那条桥。同一上下文内、系统内存与显存之间的数据搬运会被串行化,开更多 CUDA 流不会换来更多桥带宽,non_blocking=True 的拷贝在 GPU 机密模式下仍然会阻塞 CPU 线程。
由此带来一个具体后果:现代推理引擎的默认优化在这里会变成负担。vLLM 默认的异步调度本来用输出回传与下一步计算相互重叠来提吞吐;在机密模式下这些重叠的拷贝挤在同一条桥通道上串行,于是重叠的开销还在、重叠的收益没了。B300 上 Qwen3.6-27B-FP8 稠密解码、并发 128 的实测:默认异步路径 3550 tok/s,把异步调度关掉反而升到 4104 tok/s,抹掉了 57% 的机密计算差距,剩余税负约 1%。
同样的逻辑解释了为什么不同工作负载的代价差这么远。按测量:MLPerf 形态的在线服务(GPT-OSS-120B,qps=1.19)只掉 1.1%;稠密 Qwen3.6-27B-FP8 掉 13.0%;稠密 Gemma-4-31B-it 在并发 128 下掉 14.2%;而 MoE 解码掉 24.7% 到 27.6%。KV 缓存热恢复的 TTFT 从 405.4 毫秒涨到 935.2 毫秒,+131%。
洞见五:这是架构问题,不是采购问题
代价的两个轴——每次跨越这条桥的固定开销、以及每份 NVLink 流量的加密开销——都跟边界穿越的频次和位置有关,跟算力规模无关。所以「机密计算要不要开」这个决定,不该由预算表回答,该由架构回答:批量够不够大以摊薄固定开销、张量并行度有没有超过模型实际需要、引擎是不是 CC 感知的。同一份硬件、同一个模型,配置对与不对之间差了一个数量级(1–3% 对 30–40%)。把它当成一笔采购来批的团队,会拿到那个坏数字,然后得出「机密计算不可用」的结论。
四、1000 美元的排线
现在说这套体系没有证明的东西。
2025 年 10 月 28 日披露、发表于 ACM CCS 2025 的 TEE.fail,做法是用现成电子器材搭一个 DDR5 内存总线插入器,成本约 1000 美元,用时约 15 分钟,物理观察服务器内存总线上的全部流量。
它提取到的是 Provisioning Certification Enclave 的 ECDSA 证明密钥——整条 SGX 和 TDX 证明签名链的起点,每颗 CPU 一把,由英特尔的平台注册服务签发 X.509 证书。拿到这把密钥的后果是:
- 可以伪造 TDX 和 SGX 的证明。研究者伪造了一份度量值毫无意义的 TDX quote,它在英特尔的最高信任等级
UpToDate上通过了验证。 - 可以假装代码运行在可信环境里,而实际上完全没有使用机密虚拟机或飞地——工作负载裸跑在任何保护之外。
- 甚至可以在非英特尔硬件(AMD、Apple 的 CPU)上跑「TDX 虚拟机」。
- 影响范围是第四代至强可扩展以来的每一颗支持 TDX 的 CPU。
对这篇文章最关键的一条:论文同时演示了,提取出的证明密钥可以用来攻破 NVIDIA 的 GPU 机密计算。复合证明的整条链锚定在 CPU 侧的证明密钥上,锚点被拔掉,绑定本身就失去意义。
这个攻击需要物理访问,所以它常被归为「适用范围有限」。但这句话有个尴尬的推论:云厂商对它运营的每一台服务器都有物理访问权。
还有一个更结构性的缺口,和攻击手法无关。远程证明报告认证的是 CPU 型号、微码版本和被度量的启动状态,但不提供关于处理器物理位置的任何证据。学术界管这叫「位置无关」(location-oblivious)缺口:一个有决心的运营商可以生成一份完全有效的证明,而把工作负载托管在受控数据中心之外的硬件上。中继攻击和代理拼装都从这里进来。
侧信道那一侧同样没有清干净。TDXdown 演示了对 TDX 信任域的单步执行与指令计数,它需要一个恶意的 hypervisor——而那恰恰是 TDX 被设计来防的那个东西;PortPrint 靠 CPU 端口争用识别执行特征,在 SGX、TDX、SEV 上都成立,而且因为它利用的是指令级并行而非线程级并行,关掉 SMT 也没用。
洞见六:被威胁模型排除的那一方,正好是唯一始终在场的那一方
机密虚拟机把可信执行环境变成了一项基本只存在于云上的技术。而 TEE 厂商的威胁模型明确把「有物理访问权限的攻击者」排除在外。这两件事放在一起就是:你花钱买机密计算,防的是基础设施提供方;而那个提供方拥有的恰恰是被排除在威胁模型之外的那种访问权限。这不是边缘情况,这就是威胁模型本身。
必须说清的是,这不等于结论是「所以别用」。TEE 实实在在地把软件栈层面的攻击挡住了:拿到 root 的 hypervisor 读不到加密内存里的明文。变化的只是宣传口径和工程现实之间的距离——它把攻击成本从「拿到管理员权限」抬到「需要物理接触加专用设备」,这是一次真实的、可观的抬升,但不是一个绝对保证。
五、于是信任去了哪里
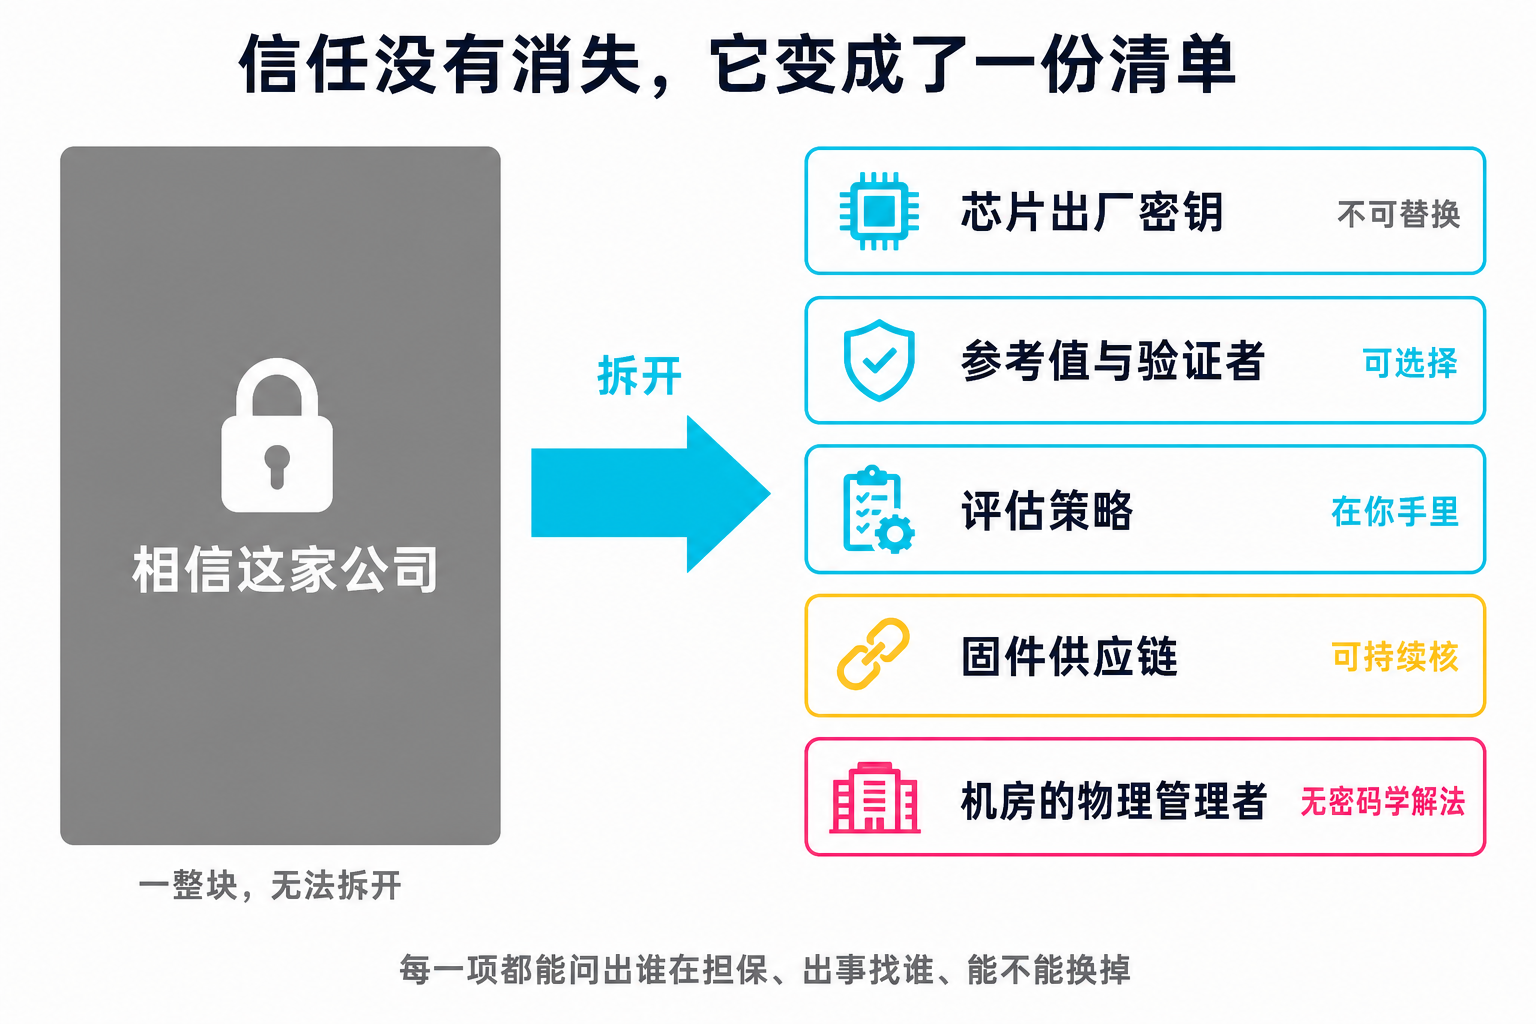
把前面几节的结论摊开,会看到一份清单。
| 你不再需要相信 | 你现在需要相信 | 是否可以被单独处置 |
|---|---|---|
| 厂商「我们不保存」的合同承诺 | 芯片厂商出厂时烧进硅片的签名密钥 | 不能替换,但 TEE.fail 之后可以要求 POE 之类的补强 |
| 厂商「我们看不见」的实现细节 | 参考值服务与验证者(RIM、Intel Trust Authority、NRAS) | 可以选择验证者,可自建离线验证 |
| 运维流程的自律 | 依赖方自己写的评估策略(ear_appraisal_policy_ids) | 完全在你手里,也完全是你的责任 |
| —— | 固件与微码供应链 | 可用 attester_tcb_date、attester_advisory_ids 持续核 |
| —— | 机房的物理管理者 | 这一项没有密码学解法 |
针对最后一项,业界的补救方向是把「物理位置」也纳入证据。英特尔的 Platform Ownership Endorsement(POE) 让运营商用密码学签名声明特定 CPU 归自己保管,绑定的是 DCAP quote 里本来就有的平台实例 ID;DCEA(数据中心执行保证) 走得更远,把机密虚拟机的启动证据绑到 TPM 锚定的宿主机度量上,从而覆盖 hypervisor 这一层。
但请注意 POE 的形状:它让运营商签名声明这台机器在自己的库存里。你从「相信运营商的合同」变成了「相信运营商的签名」。密码学没有消掉那份信任,它把信任变成了一份不可抵赖、可追责、可撤销的凭据——这是真实的进步,而它和「无需信任」是两件不同的事。
同一个模式在别处也在重复。这份号称厂商中立的 IETF profile 里,真正下合规判断的那个声明叫 x_ms_compliance_status,是微软命名空间的(取值例如 azure-compliant-cvm-guestvm)。结构被标准化了,结论仍然由厂商给出。至于依赖 NRAS 这类网络验证服务,英特尔文档里那句提醒很实在:生产环境务必配置 API key,否则服务可用性不作保证、请求可能被限流——你证明自己可信的能力,取决于一个第三方 SaaS 在线且没在限你的流。
洞见七:进步是真的,但它的名字不是「无需信任」,是「信任可枚举」
从 0820 到这里,变化不是信任消失了,而是信任的形态换了:从一句无法检验的整体承诺(相信这家公司),换成一份可以逐条列出、逐条评估、部分可替换、部分可追责的清单。清单更长了,但它是清单——每一项都能问出「谁在担保、出事找谁、能不能换掉」。这正是这个博客反复在写的那条线:0813 的上下文台账让 agent 的行为可追溯,0820 记录了承诺变得不可检验的那一刻,而这一篇是把可检验性重新装回去的机制——代价是你得自己写策略、自己核参考值、自己接受那条 330 微秒的过路费。
结论
第一,复合远程证明把「厂商承诺」换成了「密钥释放的前置条件」,而难点在绑定不在验证。7 月 19 日那份由微软、英特尔、NVIDIA 共同起草的 IETF 草案,核心是让 CPU 与 GPU 的证明可证明地彼此绑定(ear_all_submods_bound),聚合状态取最低基线,全部通过才释放临时供应密钥。它仍是草案,取值里保留了 unknown,且基础场景不建模跨卡秘密共享。
第二,性能代价的形状决定了它是架构决策。算力、能耗、可用显存都不受影响,B300 上 BF16 矩阵乘法是 0.998 倍;但同一上下文内从系统内存搬进显存掉到 0.203 倍,小跨越固定约 330 微秒。推理吞吐损失在配置正确时是 1–3%、默认配置下 30–40%,训练吞吐损失 18–32%,而出词延迟在低并发下能涨一倍以上。落地要看的是批量、张量并行度、以及引擎是否 CC 感知——vLLM 关掉默认异步调度反而更快这件事,就是这条逻辑最直白的例子。
第三,证明的语义比直觉窄:它报告状态,不判断安全。报告里有 tdx_td_attributes_debug 这样一个字段,会用有效签名如实告诉你宿主机的 VMM 现在能读私有内存。判断可不可接受是依赖方策略的事,所以采购时要问的是重新证明周期、拓扑变更是否会被拦住、以及谁来写和审这份评估策略。
第四,把信任清单写出来,然后逐项定责。TEE.fail 用约 1000 美元的 DDR5 插入器提取了证明链根密钥、伪造的 quote 在最高信任等级通过、并且可用于攻破 GPU 机密计算;证明报告对处理器的物理位置一无所知;而 TEE 的威胁模型排除了有物理访问的攻击者——那正好是云上唯一始终在场的一方。这不是不用的理由,是别把它当绝对保证的理由。可跟的方向是 POE 与 DCEA 这类把物理保管纳入证据的补强,但要认清它们的实质:信任从合同挪到了签名,没有挪到零。