数据血缘只能追到表,AI 的答案却产生在上下文窗口里

同一个财务 Agent,上午和下午回答了同一个问题:“本月新增收入是多少?”
两次运行读取的是同一张指标表,模型和系统提示词也没有改变。上午的检索命中了当前生效的指标口径,下午却取回一份仍在索引中的旧版说明;随后工具调用超时,Agent 又走了备用查询。最终,两次答案不同。
传统数据血缘看到的路径仍然完全一致:
原始表 → 转换任务 → 指标表 → Agent
但真正造成差异的两条边——“哪一版口径进入了上下文”和“本次运行走了哪条工具路径”——并不存在于这张图里。
问题不在于企业没有数据目录或血缘平台,而在于它们管理的大多是设计时已经存在的依赖。Agent 的一部分依赖直到运行时才出现:检索返回什么、策略是否放行、模型选择哪个工具、重试后采用哪份结果,都可能逐次变化。
因此,企业需要的下一层不是再建一个更大的数据目录,而是一份上下文账本:为每次运行保存“这条答案实际由哪些版本化对象和执行事件形成”的可查询记录。
一、静态血缘结束的地方,正是 AI 答案开始的地方
传统数据血缘擅长回答两个问题:
- 这张表、这个字段从哪里来?
- 上游变化会影响哪些任务、指标和看板?
它的核心对象是 dataset、job 和 run。即使记录到字段级,图中的主要边仍由 SQL、调度任务和管线配置提前确定。
Agent 的执行图不同。用户问题到达以后,系统先检索文档和数据,再组装上下文;模型可能调用工具、读取新结果、改变计划,也可能把任务交给另一个 Agent。下一条边由上一轮结果临时决定。
这意味着一条 AI 输出同时依赖两张图:
- 声明图:表、字段、指标、文档、工具之间长期存在的设计关系;
- 运行图:本次请求实际选择了哪些对象、采用了哪些版本、经过了哪些策略和调用。
前者可以预先计算,后者只能在执行过程中采集。
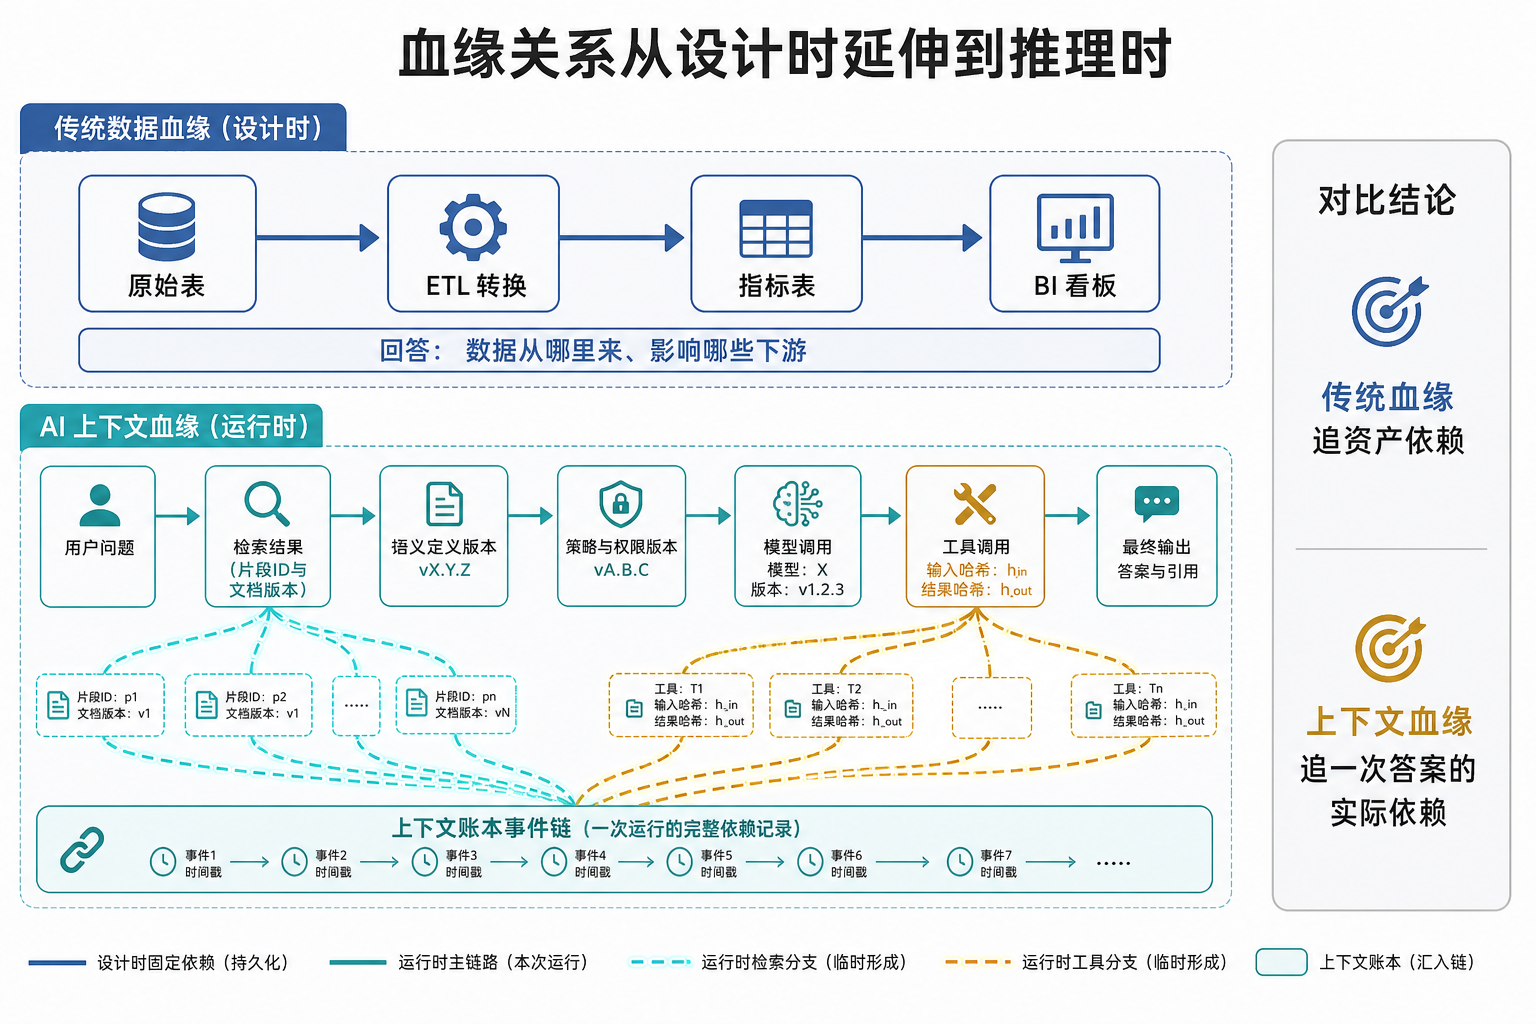
这里所说的“上下文血缘”也不是要求记录模型隐藏的思维链。企业真正需要追踪的是可观测的运行事实:什么被检索、什么被注入、什么策略被执行、什么工具被调用,以及什么结果进入了下一步。
它能证明的是操作上的依赖关系,不是某段文字在模型内部贡献了多少权重。
二、上下文账本记录一条答案的实际依赖
上下文账本可以定义为:
以一次 Agent 运行为边界,把上下文选择、策略判定和执行结果按时间追加,并用稳定标识、版本和父子关系连成的事件图。
“账本”强调的是追加写、可核对和可按时间重建,不意味着必须使用区块链。
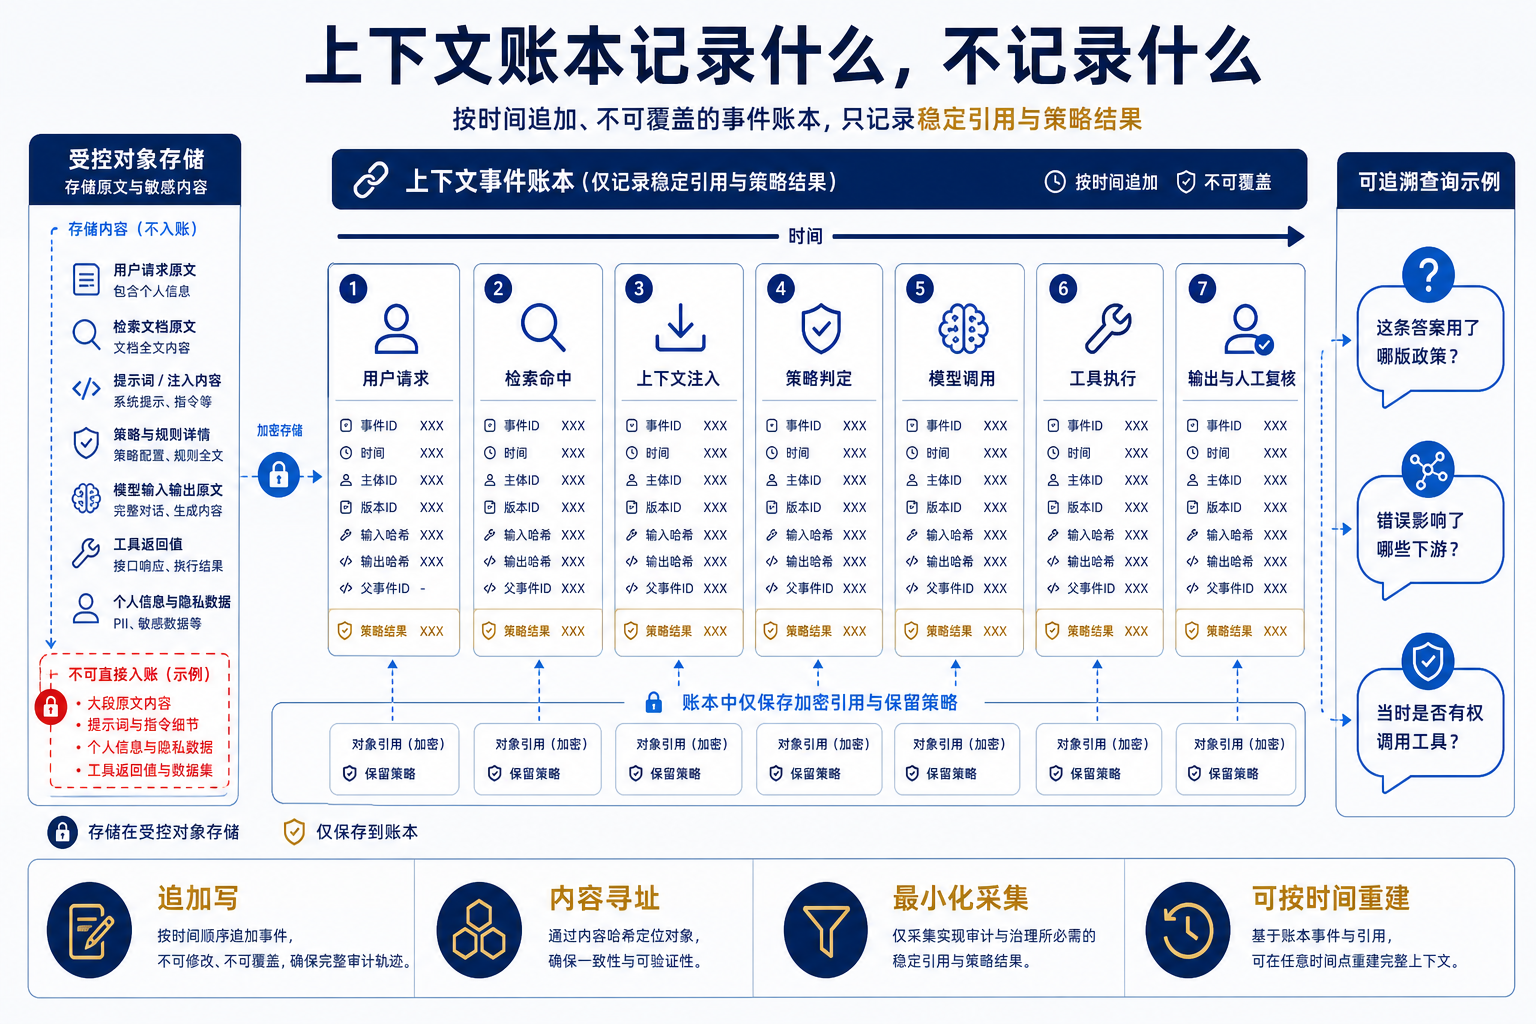
一份最小记录至少应覆盖七类事件:
| 事件 | 需要保留的核心证据 |
|---|---|
| 用户请求 | run ID、主体、用途、请求时间、内容引用或哈希 |
| 检索命中 | 查询、索引版本、候选对象、排序结果、文档与片段版本 |
| 上下文注入 | 实际进入模型的对象 ID、顺序、截断和过滤结果 |
| 策略判定 | 策略版本、权限主体、允许或拒绝、原因码 |
| 模型调用 | 模型与参数版本、输入引用、输出引用、父事件 |
| 工具执行 | 工具与契约版本、参数和结果哈希、状态、重试与回退 |
| 输出与复核 | 最终输出哈希、引用、人工批准、修改或否决 |
这比普通聊天日志多了版本和关系,也比 APM trace 多了数据、语义和策略对象。
更重要的是,账本必须区分几个容易混淆的状态:文档被检索到,不等于被注入;被注入,不等于模型在答案中引用;工具被计划,不等于真正执行;策略配置存在,不等于本次调用确实经过了判定。
只有把这些状态拆开,企业才能回答:“这条答案究竟用了哪版政策?”而不是只能看到“Agent 当时访问过知识库”。
三、Catalog、Lineage 和 Contract 都在改变职责
上下文账本不是要替代现有数据治理,而是把三类能力接到推理运行时。
Catalog:从帮助人找数据,到供 Agent 判断数据是否可用
传统目录主要面向分析师:搜索表名、查看 owner、阅读字段说明。
Agent 需要的不是一页介绍,而是机器可执行的资格信息:当前有效版本、适用业务域、数据新鲜度、允许用途、敏感级别、授权主体、语义定义和契约地址。
因此,Catalog 的输出从“可能相关的资产”变成“此主体在此用途和此时点可以使用的版本化对象集合”。检索仍负责相关性,目录负责资格;两者不能混成一个分数。
Lineage:从静态资产依赖,到逐次运行的上下文血缘
传统血缘图不需要消失。上下文账本应把运行时事件重新连接到既有表、字段、指标和文档节点。
当一份旧政策被撤回时,系统不只要知道哪些索引包含它,还要能反向查询:
- 哪些回答实际注入过这个版本?
- 哪些工具调用由这些回答触发?
- 哪些下游决策需要重算或人工复核?
这时,血缘从“变更影响分析”扩展成了“答案影响分析”。
Contract:从 schema 兼容性,到数据、工具、权限与用途的联合约束
传统 Data Contract 主要约束 schema、质量、时效和 owner。Agent 运行还要同时满足:
- 数据是否满足质量与新鲜度要求;
- 文档和语义版本是否允许用于当前任务;
- 工具参数、返回结构和重试是否符合契约;
- 当前身份是否拥有权限;
- 该数据能否用于这个用途和这个模型。
契约也因此从一个静态 YAML 文件变成两部分:一部分声明约束,另一部分记录本次运行的执行结果。只保存“当时存在一条规则”不够,还要保存“这次规则是否被检查、结果是什么”。
三者的关系可以概括为:
Catalog 声明什么可用,Contract 判断本次能否使用,Lineage 记录本次实际用了什么。
上下文账本把这三个答案按同一个 run ID 连起来。
四、有了 trace,为什么还需要账本
现有标准已经提供了不少积木,但它们还没有自然组成一份完整的上下文血缘。
OpenLineage 的核心模型是 dataset、job 和 run,并允许通过 facet 扩展元数据。它很适合把 Agent 运行接回企业已有的数据血缘图。2026 年 3 月,社区已经有人提出 AgentRunFacet,试图加入模型、系统提示词哈希、检索数据集、工具调用和人工检查点;截至本文写作时,它仍是一项社区 RFC,不是已发布标准。
OpenTelemetry 的 GenAI 语义约定则面向可观测性,可以统一模型调用、Token、时延、Agent 与 MCP 工具的 span。它更擅长回答“哪里慢、哪里错、调用了什么”,但一棵 span 树本身不会自动知道某段检索结果对应企业目录中的哪版政策,也不会判断当时是否有权使用。
PROV-AGENT 走得更接近本文所说的运行时血缘。它扩展 W3C PROV,把 Prompt、AIModelInvocation、Response 和 AgentTool 作为一等对象,用 used、wasGeneratedBy 和 wasInformedBy 等关系连接 Agent 与传统工作流。其 Flowcept 原型已经能包装 LLM 调用和 MCP 工具,在运行时采集提示、响应、模型元数据与工具输入输出。
ContextNest 则解决另一段链路:记录 Agent 消费了哪一版受治理知识、该版本是否获批,以及如何按检查点重建知识状态。但论文也明确把 Agent 身份、能力授权和工具策略执行放在范围之外。
这些工作的边界说明,企业暂时很难购买一个现成标准就结束问题。更现实的架构是:
- 用 OpenTelemetry 采集运行事件;
- 用 OpenLineage 或 W3C PROV 表达跨数据与工作流的依赖;
- 用 Catalog 提供资产与语义的稳定 ID;
- 用策略引擎执行 Contract;
- 用上下文账本保存它们在一次运行中的引用和判定。
观测 trace 是原材料,血缘模型是关系语言,账本才是可长期查询的证据产品。
五、上下文账本应该怎样落地
第一步不是“把所有 prompt 全量存下来”,而是先建立统一身份。
表、字段、指标、文档、片段、语义定义、策略、工具、模型和 Agent 都需要稳定 ID 与版本。没有这些标识,运行日志再多也只能靠字符串猜测,无法与 Catalog 和 Lineage 可靠连接。
第二步是定义一套最小事件封装。每条事件至少包含:
event_id、run_id、parent_event_id、时间、主体、动作、对象引用、对象版本、输入输出哈希、策略结果和保留级别。
第三步是在四个位置采集:检索出口、上下文组装器、策略执行点和工具网关。只在模型 SDK 外包一层日志不够,因为它看不到检索候选为何被过滤,也不知道工具调用前经过了哪条权限决策。
第四步是把“大内容”与“账本索引”分开。提示词、文档片段和工具返回值放在加密、分权、带保留期限的对象存储中;账本保存内容寻址、版本和授权后的引用。这样既能核对内容,又不必让每一个血缘消费者都读取敏感原文。
第五步是先用三个问题验收,而不是先做漂亮的全景图:
- 给定一条答案,能否列出实际注入的文档、语义和策略版本?
- 给定一个撤回的数据或政策版本,能否找出受影响的答案与下游动作?
- 给定一次工具调用,能否证明当时的主体、用途和策略判定?
如果三道查询不能在分钟内完成,这套系统还只是分散日志,不是上下文账本。
六、记录越多,不等于治理越好
上下文账本最危险的误区,是把“可追溯”理解成“永久保存一切”。
用户问题、检索片段、模型输入和工具结果可能包含个人信息、商业秘密与凭证。全量采集会把原来短暂存在于上下文窗口里的敏感信息,复制成一个新的高价值数据仓库。
因此,账本必须同时具备最小化采集、字段级脱敏、分权访问、加密引用和差异化保留期限。哈希可以证明两份内容是否一致,却不能证明内容本身正确,也不能替代访问控制。
可重建也不等于每次都能生成逐字相同的答案。模型、近似检索和外部工具都可能存在非确定性。账本更现实的目标是重建当时的输入依据和执行路径,把差异定位到数据、策略、工具或模型,而不是承诺完全相同的输出。
监管也不应被夸大。欧盟《AI Act》第 12 条要求高风险 AI 系统具备与其预期用途相称的自动事件记录能力,但它没有要求所有 AI 应用保存完整提示词,也没有规定统一的“上下文账本”模式。上下文账本首先是企业自己的质量、事故与责任基础设施,其次才可能帮助满足特定场景的合规要求。
结论
数据目录、血缘和契约没有过时。它们管理的是 Agent 能够看到的世界。
缺失的是另一半:Agent 在一次真实运行中究竟看见了什么、被允许做什么、实际走了哪条路径。
当答案由检索、语义、策略、模型和工具共同形成时,只追到表已经不够。企业需要把设计时的数据资产图与推理时的事件图连接起来,让每一条重要答案都能反向还原到当时的上下文。
这就是“上下文账本”的价值:它不试图保存模型的全部思想,而是为每次 AI 决策保留一条可核对的证据链。
参考资料
- W3C,《PROV-Overview: An Overview of the PROV Family of Documents》。https://www.w3.org/TR/prov-overview/
- OpenLineage,《About OpenLineage》。https://openlineage.io/docs/next/
- OpenLineage 社区,《RFC: AgentRunFacet — OpenLineage Extension for Agentic AI》,2026 年 3 月。https://github.com/OpenLineage/OpenLineage/discussions/4407
- OpenTelemetry,《Generative AI semantic conventions》。https://opentelemetry.io/docs/specs/semconv/gen-ai/
- Renan Souza 等,《PROV-AGENT: Unified Provenance for Tracking AI Agent Interactions in Agentic Workflows》,arXiv:2508.02866v2。https://arxiv.org/html/2508.02866v2
- ContextNest 项目,《ContextNest: Verifiable Context Governance for Autonomous AI Agents》,arXiv:2607.02116v2。https://arxiv.org/html/2607.02116v2
- European Union,《Regulation (EU) 2024/1689》,第 12 条。https://eur-lex.europa.eu/legal-content/EN/TXT/HTML/?uri=CELEX%3A02024R1689-20260727
本文部分内容由 AI 辅助生成,经人工审校和补充后发布。