向量不出表:把 ANN 塞进 Parquet 文件尾,代价是多少
过去三年,向量检索的默认答案是增加一个系统:把嵌入从数仓里取出,复制进专门的向量库,再在那里重建过滤条件、访问控制和数据同步。
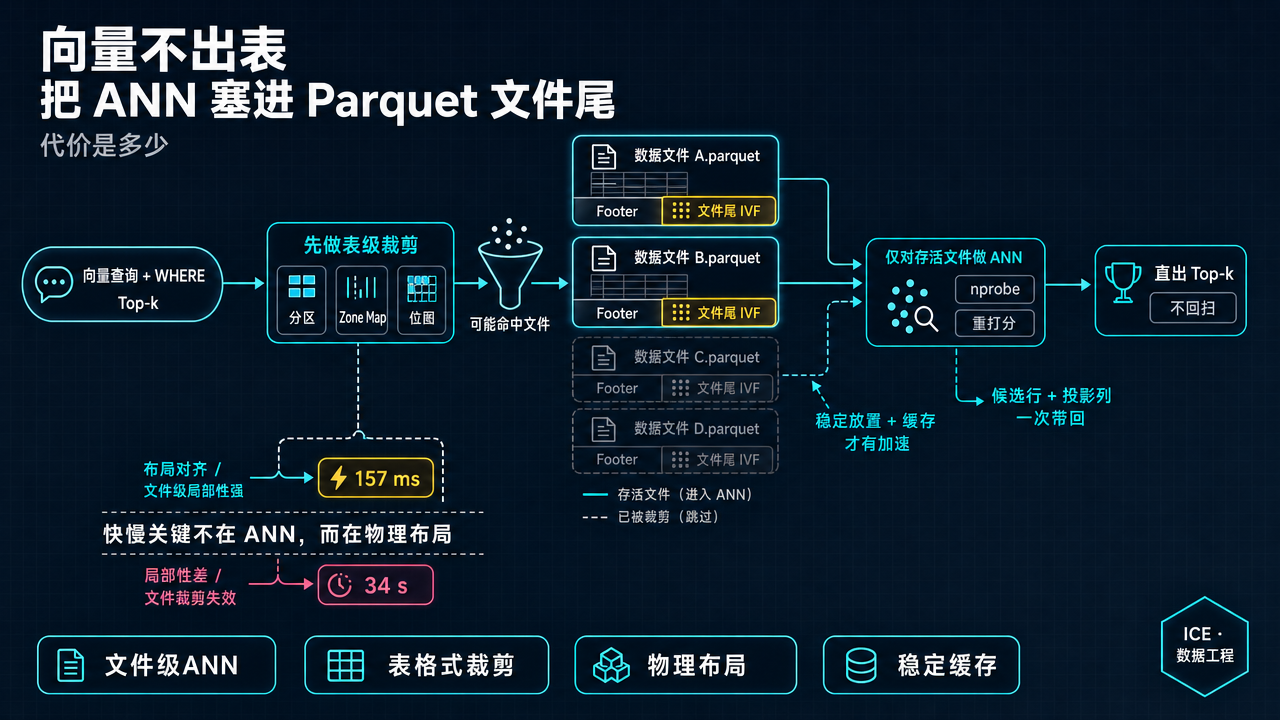
IBM Research 的一篇湖仓论文尝试了相反的方向:向量不出表,IVF 索引直接追加到每个 Parquet 文件尾部。 查询先复用 Iceberg 已有的分区和文件裁剪,只对可能命中的文件执行 ANN(Approximate Nearest Neighbor,近似最近邻搜索)——它不遍历全部向量,而是快速找出大概率最相似的一小批候选。
论文信息 Rakesh Jain, Thomas Griffin, Syed Zawad(IBM Research). Filtered Vector Search in a Disaggregated Lakehouse: Composing Table-Format Pruning with Per-File ANN. arXiv 预印本:2608.05441
本文的实现与量化数据均来自这份完整可读的预印本,尚未经过正式同行评审。
这篇论文最有价值的地方,不是又提出一种 ANN 算法,而是把过滤放回数据所在的层:先用表格式排除不可能命中的文件,再在剩余文件里做近似搜索。 更难得的是,作者没有回避代价——同一套设计既能跑到 157 毫秒,也能退化到 34 秒。
一、复制出去的向量,代价记在别的账上
先把问题定义清楚,否则很容易把它读成“又一个向量索引”。
检索增强生成、语义搜索、推荐,发出的查询形状是同一个:返回离查询嵌入最近的 tenant='acme' 且 lang='en'」。生产数据有两个特征让这件事变得别扭:向量不是孤零零存着的,它旁边就是用户真正用来过滤的那些列(租户、语言、类别、时间戳、权限标签);而这些表越来越多地躺在开放湖仓格式里,Iceberg 加 Parquet 放对象存储,被 Spark、Trino、Presto、DuckDB 一起读。
主流答案是把向量复制进专用向量库或专用列存格式,再在那边重建谓词。这笔账通常只记了三项:数据重复、偏离事实来源、过滤问题要在向量系统内部用专门的过滤型 ANN 算法重解一遍。IBM 那篇补上了第四项,也是最容易被忽略的一项——复制出去的那份数据,离开了湖仓 catalog 管的边界。它需要自己的认证、自己的表级与列级权限、自己的行列掩码、自己的审计链,而且必须和源表的策略保持同步,还随时可能静默漂移。
过滤型向量搜索通常有三种办法:先过滤再搜、先搜再过滤,或者在索引遍历时求值谓词。IBM 选择了第一种,但没有另造一套过滤系统,而是直接复用湖仓已有的数据跳过能力。这样,问题就从“选哪个过滤型 ANN 算法”,转成了“表的物理布局能否先裁掉足够多的文件”。
二、每个 Parquet 文件拥有自己的 ANN
IBM 的改法克制得有点狡猾。
它把一个 IVF 索引序列化成 blob,追加在每个 Parquet 文件的 footer 之后,只在 footer 的键值元数据里留一个很小的指针。标准的 Parquet reader 会定位到 footer,然后永远看不见这个 blob;只有认识这个指针的 reader 才会去跟。索引是每文件独立的:每个文件有自己的质心,召回靠每次查询的候选过取,而不是靠一个全局索引。
配套还有一处很细的写入调优:嵌入列声明成 FLOAT[d],写的时候把页大小上限设成
查询路径是三步,而第三步是全篇最值得记的工程教训。
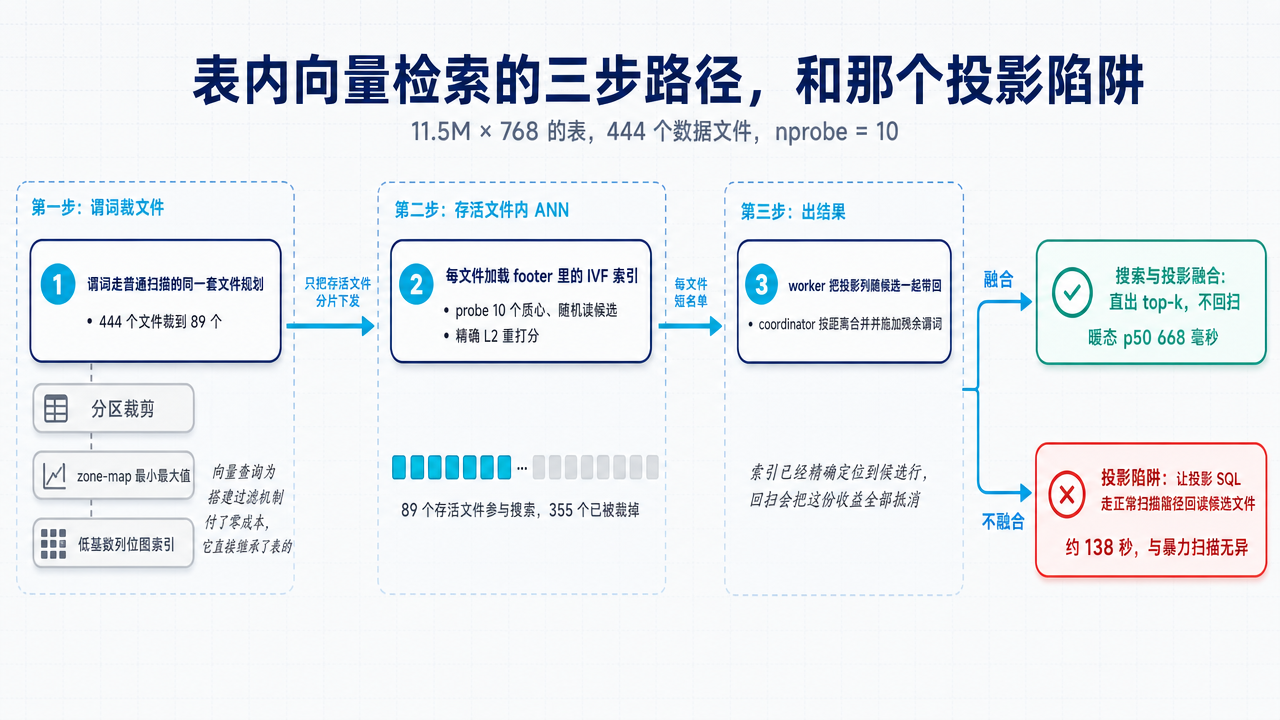
第一步,用查询的 WHERE 走一遍普通扫描用的同一套文件规划:分区裁剪、每列的 zone-map 最小最大值、以及一个为低基数列每快照物化一次的标量位图索引。输出是「可能满足谓词的文件集合」。论文把这一步称为关键所在——向量查询为搭建过滤机制付了零成本,它直接继承了表的。
第二步,存活文件分到各个读计算 pod;每个 pod 对每个文件加载 footer 里的 IVF 索引,找出离查询向量最近的
第三步,直出 top-
这一步为什么值得单独讲?因为他们的早一版设计不是这样:它让投影 SQL 走引擎正常的扫描路径去重读候选文件,结果是整个查询花了约 138 秒——和暴力扫描没有区别,尽管 IVF 那一步早在几秒内就已经精确定位到了候选行。论文把这条教训写得很直接:在每文件 ANN 的设计里,搜索和投影必须融合,否则投影会把索引本想避免的那次扫描重新做一遍。
同一个陷阱在真实语料上又出现了一次,形态稍变。一个同表排序查询如果投影了文档正文这种宽列,就会强制全文件重打分,暖态 p50 是 3.5 秒;改成先按 id 加 category 排序走直出路径,再对
建索引那一侧的设计目标是「不破坏任何东西」。写计算池的 pod 并行读各自分到的文件,训练 k-means,追加 IVF blob,上传成新对象;数据页逐字节复制,所以文件内的行序号——倒排列表引用的正是这个身份——被精确保留。然后 coordinator 提交一次纯元数据的 Iceberg replace:新文件 add、老文件 delete,发布成一个 Replace 快照。老文件仍被父快照引用,时间旅行完好,只在正常的快照过期时才被物理删除。结果是一张普普通通的 Iceberg 表:Spark 或 DuckDB 把新文件当普通 Parquet 读,忽略尾部那个 blob。单个文件构建失败也不致命——那个文件保持未索引状态,查询时退回暴力,重跑一次补洞即可。
三、真正的性能杠杆是文件布局
论文最反直觉的结论是:决定过滤型向量检索快慢的,是表怎么摆,而不是选了哪个 ANN 算法。
IBM 把这个条件写成了一条充要式的判断:过滤型向量检索快,当且仅当过滤列具有文件级局部性——每个值集中在少数文件里,这样表自己的裁剪机制才能在 ANN 被调用之前就干掉大部分文件。这正是 Li 等人那条内存层结论「分区对低选择率有效」在存储层的形态。
论文在同一个引擎上给出了三种结果:
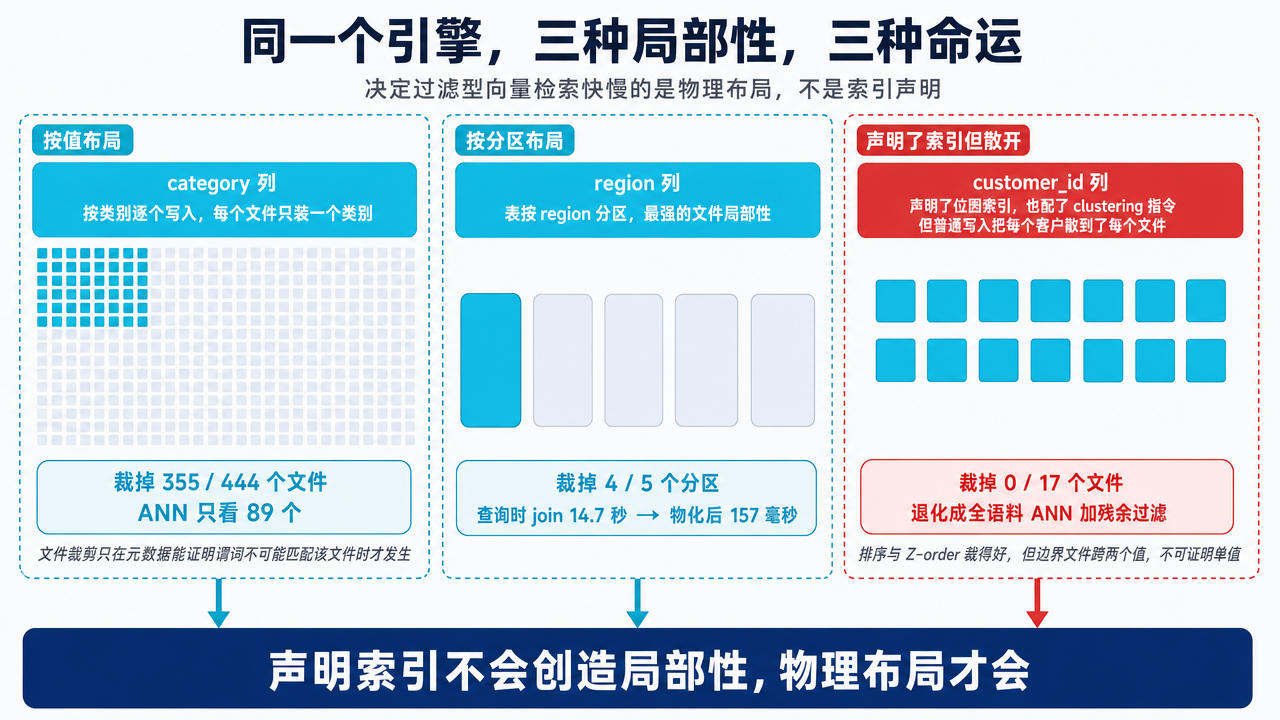
按类别逐个写入、让每个文件只装一个类别时,WHERE category='tech' 让位图索引在读到任何一个向量之前就裁掉了 444 个文件里的 355 个。按 region 分区时,region 谓词裁掉五个分区里的四个。而在真实的 502 万文档表上,customer_id 这一列既声明了位图索引、又配了 write.cluster.columns 聚簇指令,单值谓词 WHERE customer_id=c 却裁掉了 17 个文件中的 0 个——普通写入把每个客户散落到了每一个文件里,于是没有任何文件能被证明不含这个值,位图什么也证明不了。
需要注意的是,前两种高局部性布局是作者主动构造的,正好满足该方案的理想条件;一张自然生长的生产表未必天然具备这种局部性。第三个结果恰好展示了现实中的风险:声明了索引和聚簇配置,不代表实际写入已经把相同值放进少数文件。
作者的结论很硬:声明索引不会创造局部性,物理布局才会。 对于过滤型向量检索的实践者,这意味着要做的功课是一个老得不能再老的物理设计决策——按你常用的过滤维度分区——而不是去挑一个专门的过滤型 ANN 算法。
这里还埋着一个非常容易踩的正确性坑,论文自己也承认没预料到:排好序不等于纯。把残余谓词推进每文件搜索、当作掩码用,只有在存活文件对该列是单值的时候才成立。Iceberg 的 SORT 或 ZORDER 排序会让一列局部连续,它的 zone-map 裁得很好,但值边界上的那个文件同时装着两个值;一个假设了纯度的掩码会静默丢掉合法行或纳入非法行。所以他们把可下推的列集合严格限定为「分区列 ∪ 已物化聚簇规格的列」,把排序和 Z-order 列排除在外——这些列仍然参与第一步的文件裁剪,只是它们的残余谓词不下推。「裁得好」和「可证明单值」是两件事,混为一谈会静默弄错结果。
最后一块是真实查询里更常见的形态:过滤条件往往不在向量表上,而在 join 过来的维度表上——「找最近的文档,其中客户在欧盟」。SQL 引擎在湖仓上有个现成的招:半连接归约。planner 认出 ANN 在一张表上而 join 只是约束它,就把维度谓词求值成一个键集合,再改写成单表形式的 WHERE d.customer_id IN (...)。那个 IN 列表随后就是喂给第一步文件裁剪的又一个普通谓词。这不需要新索引也不需要新算子,用的是引擎为星型模式分析查询早就有的那套维度键物化。
但这条路有个脆弱点,论文测出来了。join 键是高基数标识符,它的文件局部性很脆——一次不走运的重新装箱就能把一个 region 的行散到所有文件里,裁剪随之崩掉。在 502 万条 IBM Granite 真实嵌入上,按查询跑归约仍然裁了文件,暖态 p50 却是 14.7 秒,主要耗在多表候选重打分上。而把归约物化进物理布局——把 region 这个维度属性反范式化到事实表上并按它分区——同一个结果集用 157 毫秒返回,Recall@10 等于 1.00。94 倍,同一个结果集,差别只在布局。
四、算法省了 500 倍,系统只快 30 倍
这一节是论文里最值得引用的部分,因为它把代价摆在了台面上。
先看系统税从哪来。在分离式架构上,每次文件读取都要跨网络到对象存储。IBM 实测:
真正把正确性变成速度的是两个缓存决策,而它们的贡献可以逐项拆开:
| 配置 | IVF p50 | 相对暴力扫描 |
|---|---|---|
| 朴素实现(每次查询重读) | ≈ 暴力扫描 | 1.0× |
| 加每文件缓存(索引 + 嵌入矩阵) | 6.6 s | 4.7× |
| 加 rendezvous 哈希放置 | 1.8 s | 15.6× |
| 加稳定 pod 集(全部修复) | 668 ms | 31.6× |
中间两行来自较早的部署,端点两行来自当前部署,绝对延迟因此不可直接相减;但形状是稳定的——没有缓存时它就是暴力扫描,缓存和稳定放置才是那 30 倍的来源,而这两件事都与 ANN 算法无关。
第二行到第三行那个跳跃值得解释。缓存是每 pod 的,所以「哪个 pod 搜哪个文件」必须稳定,否则读池一自动扩容,文件就被重映射到冷 pod,本已暖好的缓存全部冷启。他们改用 rendezvous 哈希(文件总是落到令
暖态主结果是这样:11.5M × 768 的表,
召回的尾巴也交代得很规矩:spot-check 样本上
现在是代价表。这张表之所以珍贵,是因为作者明确说了他们放进来的动机:读者最想知道的是「把向量留在开放表里,到底要付多少延迟」,而基线的存在就是让读者能给这个取舍定价,哪怕自家系统在原始延迟上输得很难看。
| 系统 | 是否要复制数据 | p50 | Recall@10 |
|---|---|---|---|
| Milvus HNSW(30 万行子集) | 全量复制 | 5 ms | 高(未做同口径对比) |
| 全表 IVF-PQ(同一 1150 万语料) | 单独索引对象 | 175 ms | ≈ 0.88 |
| 本系统,谓词非布局对齐(σ=0.2) | 不复制 | 34 s | ≥ 0.90 |
| 本系统,谓词分区对齐(走快路) | 不复制 | 157 ms | 1.00 |
三个数量级的差距摆在明处。不过 Milvus 那一行只使用 30 万行子集,而且没有报告同口径召回,不能把 5 毫秒与其他行当作严格对照。它更适合说明两种架构的量级差异,以及“复制”换来的低延迟:向量被整体搬出湖仓(光这个子集的复制就花了 138 秒),搬完之后任何 Parquet 或 Iceberg 客户端都读不到它了,而且每次写入都要重搬一次。
中间那行更要紧。论文自己在讨论里承认,一个全表的 IVF-PQ 或 HNSW「在固定候选预算下大概会给出更好的召回」,因为它聚类的是全体而不是每次 2.6 万行。于是他们真的在同一份数据上建了这个全表索引(
但全局索引有一处结构性的短板,正好回到本文的主线:它没有原生办法去组合一个湖仓谓词。倒排列表是按簇组织的,不是按表的分区或 zone-map 组织的,所以查询一旦加上 WHERE region='EU',它要么过取再后过滤,要么退回全扫。这也是为什么第四行那个 157 毫秒才是这个设计的真实卖点:当谓词与布局对齐时,它同时拿到了文件裁剪和快速路径。
至于那个 500 倍与 30 倍的落差,论文自己给了成本模型:
五、为什么这仍是一种实验性设计
Apache Iceberg 规范至今既没有原生向量类型,也没有 ANN 索引。 嵌入只能存成 list、fixed、binary 这类现有类型,相似度检索和索引必须来自表之上的一层。v4 规范仍在积极开发、尚未正式采纳。
因此,论文把索引 blob 放在 Parquet footer 之后,本质上是一个兼容性技巧,不是 Parquet 或 Iceberg 已认可的标准。普通 reader 可以忽略它,但只有定制 reader 才能使用它。
当前原型的功能范围也很窄:一张表只支持一个嵌入列,只实现 IVF 与 L2 距离,余弦相似度需要客户端先归一化,查询向量只能写成字面量,索引缺口也要手工重建。这些限制不影响论文验证核心思路,却说明它距离通用湖仓能力还有明显距离。
Iceberg 社区尚未决定向量索引应该如何进入规范。争议集中在两个问题:索引是否必须与单个数据文件一一对应,以及规范应该定义具体索引,还是只提供通用框架。另一种 Puffin 边车方案选择把 DiskANN 图放在独立文件中,不修改 Parquet 数据文件。两者分别优化过滤组合与全局索引能力,最终哪一种成为标准仍未确定。
结论
- 每文件 ANN 的核心不是 IVF,而是复用表格式的数据裁剪。 查询先通过分区、zone-map 和位图排除文件,再在存活文件内搜索;因此过滤列是否具有文件级局部性,决定了整条路径能否变快。
- 系统工程决定算法收益能兑现多少。 理论上减少约 500 倍距离计算,端到端只有约 30 倍;缓存、稳定的文件到 pod 映射,以及搜索与投影融合,才把第一版的暴力扫描级性能压到 668 毫秒。
- 不复制数据不是免费午餐。 布局对齐时可以达到 157 毫秒,布局不对齐时可能退化到 34 秒,专用向量库仍可能更快。这笔延迟税换来的是单一事实来源、现有访问控制和开放表兼容性。
所以下次有人提议给你的湖仓配一个向量库,不妨先问一句:
你打算按什么维度过滤?那一列,现在是分区列吗?
参考资料
- Rakesh Jain, Thomas Griffin, Syed Zawad(IBM Research). Filtered Vector Search in a Disaggregated Lakehouse: Composing Table-Format Pruning with Per-File ANN. arXiv: 2608.05441
- Artur Borycki. Puffin-Backed Vector Indexes: Attaching Approximate Nearest Neighbor Indexes to Apache Iceberg Snapshots for Compute-Disaggregated Query Engines. arXiv: 2606.04196
- Yannis Chronis, Helena Caminal, Yannis Papakonstantinou, Fatma Özcan, Anastasia Ailamaki. Filtered Vector Search: State-of-the-art and Research Opportunities. PVLDB 18(12): 5488–5492, 2025. DOI: 10.14778/3750601.3750700
- Mocheng Li, Yue Zhang, Chenhao Ma, Xiao Yan, Baotong Lu, James Cheng. Attribute Filtering in Approximate Nearest Neighbor Search: An In-depth Experimental Study. arXiv: 2508.16263
- Apache Software Foundation. Apache Iceberg Table Spec(v4 仍在开发中). iceberg.apache.org
- Apache Iceberg. Support build full-text and vector index for iceberg(社区提案与讨论,issue #12636). github.com
- Hervé Jégou, Matthijs Douze, Cordelia Schmid. Product Quantization for Nearest Neighbor Search. IEEE TPAMI 33(1): 117–128, 2011.
本文部分内容由 AI 辅助生成,经人工审校和补充后发布。