MCP 只是最后一公里:联合国如何把 4400 万个数据点变成 Agent 可用的可信图谱
Deep Research 报告 | 2026 年 9 月 | 面向数据工程师、Agent 开发者与公共数据平台建设者
摘要
2026 年 9 月 17 日,联合国上线 UN System Data Commons。首批 26 个联合国系统实体参与,平台汇集近 4400 万条观测、超过 1700 个统计序列,并允许用户用自然语言跨机构检索、比较和追溯数据。它还通过 Model Context Protocol(MCP)向 AI Agent 开放数据访问。
容易误读的地方是:这不是“给 26 个数据库套一个聊天框”,更不是 MCP 单独创造了可信性。真正困难的工作发生在接口下面——把不同机构的实体、指标、时间、地域、单位、测量方法和来源映射进同一张知识图谱。MCP 负责让 Agent 调用这些能力;知识图谱和来源元数据,才负责让不同数据说同一种语言。
本文拆解这套系统的四层结构:源系统保留治理权,Data Commons 统一语义,MCP 暴露受控工具,Agent 负责规划和表达。结合 DataGemma 的实测结果,文章还会说明它的边界:接入可信数据后,检索到的统计陈述准确率可以接近 99%,但数据覆盖率只有 24%–29%,模型基于正确数据做出的推断仍可能出错。
一、问题不是没有数据,而是数据彼此不认识
要理解 UN System Data Commons 的价值,先要放下“把数据集中到一个库里”的惯性思路。
联合国系统并不缺数据。儿童营养、人口迁移、劳动就业、公共卫生、气候、教育、贸易和粮食安全,分别由不同机构长期维护。问题是这些数据分布在不同门户中,采用不同格式、分类体系、地域编码和更新时间。一个研究儿童营养的分析师,可能需要把 UNICEF 的营养指标与贫困、粮食安全、疾病、教育、气候和流离失所数据连接起来。真正耗时的不是画图,而是确认:
- 两个机构所说的“儿童”年龄范围是否一致;
- “发生率”是人数、比例还是每十万人比率;
- 地域边界和国家名称是否对应同一实体;
- 观测值来自哪次调查,使用什么测量方法;
- 同一指标存在多个来源时,应该选哪一条时间序列。
Google 对项目背景的描述很直接:在平台出现之前,跨机构连接数据往往意味着数据分析师要做数月的手工整理。联合国自己的预备材料也强调,这个平台不取代各机构的源系统,而是在保留既有所有权、治理安排和使用条款的前提下,为关键公共数据建立统一入口。
这一区别很重要。Data Commons 不是新的数据仓库,而是一层跨组织语义基础设施。 数据可以继续由原机构生产和治理,但对外呈现时,需要拥有可连接的实体、变量和来源描述。
从时间线上看,这也不是突然出现的项目:
| 时间 | 关键进展 | 解决的问题 |
|---|---|---|
| 2017–2018 | Data Commons 项目启动,并于 2018 年公开 | 为异构公共数据建立统一图模型 |
| 2023–2024 | UN Data Commons for the SDGs 扩展到更多联合国机构 | 从单一 SDG 门户走向跨机构连接 |
| 2025-09 | Data Commons 发布 MCP Server | 让 Agent 通过标准协议查询知识图谱 |
| 2026 | 托管版 MCP 上线 Google Cloud | 降低本地安装与运维门槛 |
| 2026-09-17 | UN System Data Commons 正式发布 | 26 个实体、近 4400 万条观测统一开放 |
| 2027 目标 | 纳入联合国系统 80% 的统计数据集 | 从首批平台扩展为系统级公共数据入口 |
这个演进顺序说明了一件事:先有语义基础设施,后有自然语言和 MCP;不是反过来。
二、它究竟是什么:四层,而不是一个聊天框
理解系统边界的最好方式,是把数据治理与 Agent 执行拆成四层:源系统生产并审核数据,语义图谱统一实体与指标,MCP 暴露受控查询工具,Agent 最后才负责规划、调用和表达。每向上一层,使用门槛下降,但底层治理责任并不会消失。
2.1 源系统仍是权威来源
UN System Data Commons 的设计不是把所有机构的数据复制后重新定义一遍。各参与实体保留原有系统、所有权和治理安排,Data Commons 通过映射与来源链接建立统一访问层。这样做避免了“为了统一入口,再造一个新的数据孤岛”。
2.2 知识图谱提供共同语言
Data Commons 将世界表示为一张有向带标签图。节点可以是国家、城市、学校、事件、统计变量或统计观测;边表示类型、包含关系或其他属性。每个节点都有唯一的 Data Commons ID(DCID)。
统计数据被拆成两个核心对象:
- StatisticalVariable(统计变量):定义测量什么。例如“18—24 岁女性高中毕业生人数”,其中包含人口类型、测量属性、统计类型和约束条件。
- StatVarObservation(统计观测):记录某个实体、某个时间点上的具体数值。
这比“指标名称 + 数值”多了一层结构。一个观测不仅是 42.7,还要知道它测量的变量、对应实体、时间、单位、周期、测量方法和来源。
2.3 MCP 把能力收敛成有限工具
Data Commons MCP 并没有把整张图直接扔给模型。它提供的是一组边界明确的工具:
search_indicators
  → 找到某个地点或主题下可用的指标

get_variable_metadata
  → 查看候选指标的来源、可用年份等元数据

get_observations
  → 获取某个地点与指标的时间序列

get_child_observations
  → 比较某个区域下的国家、省州或城市

get_multi_entity_observations
  → 查询贸易、援助等带方向的多实体关系
这类接口设计的价值,不是“少写几个 REST 请求”,而是把 Agent 的行动空间限制在经过定义的统计查询上。模型负责决定何时搜索指标、何时检查元数据、何时取数;真正的数据选择和返回由确定性工具完成。
2.4 Agent 仍然承担不确定推理
Agent 会把“比较南亚各国预期寿命与教育完成率”拆成指标搜索、实体解析、元数据核对、观测提取和结果表达。但哪怕每个数值都有来源,Agent 仍可能选择错误的指标、混用不同口径,或从相关性跳到因果判断。
所以更准确的表述不是“Data Commons 消除幻觉”,而是:它把一部分容易幻觉的事实检索,从模型参数转移到可查询、可追溯的数据基础设施。
三、核心架构:可信性是怎样一层层传上来的
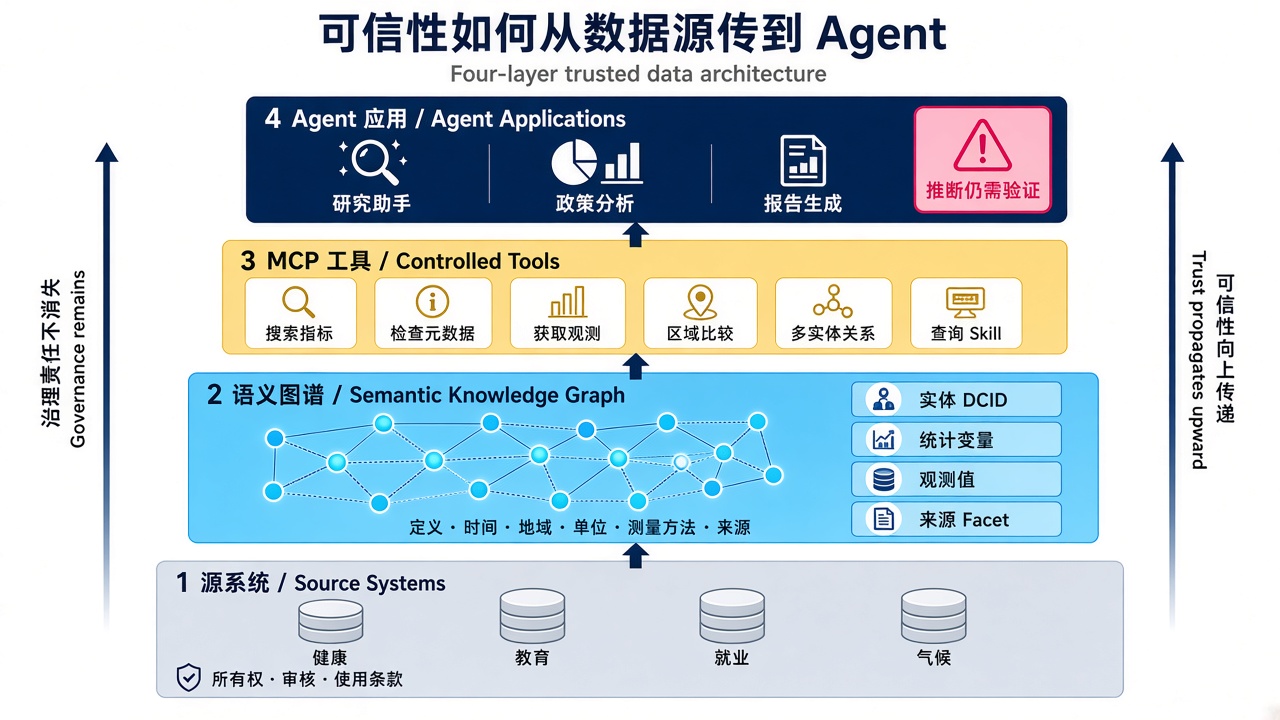
四层结构中,真正决定可信性的不是最上面的对话入口,而是中间两层如何保持语义和来源。
3.1 指标不是字符串,而是可组合的变量
传统数据目录常把指标当作名称相似的字段。Data Commons 则把统计变量建模成节点,并显式记录人口类型、测量属性、统计方式与约束维度。例如“西班牙裔女性人口”可以拆成:
populationType = Person
statType       = Count
gender         = Female
race           = HispanicOrLatino
这样,跨机构查询不再只依赖模糊字符串匹配,而是可以比较变量的结构是否一致。代价是数据接入方必须先完成映射:复用已有变量,或用 MCF(Meta Content Framework)定义新节点。官方文档特别提醒,随意创建重复变量会产生误导性的查询结果。
3.2 Provenance 与 Facet 解决“同名指标有多个答案”
同一个统计变量可以有多个来源。例如“预期寿命”可能来自不同国家普查、世界银行、OECD 或联合国机构,测量方法、单位和覆盖时间并不相同。
Data Commons 用三层来源对象描述这件事:
- Source:提供数据的组织;
- Dataset:组织发布的数据集;
- Provenance:一次物理导入对应的细分来源,近似关系数据库中的表。
在观测查询中,Facet 进一步携带来源 URL、测量方法、单位、观测周期等信息。官方文档明确警告:如果不指定 facet,同一时间序列可能混合不同来源或测量方法。换句话说,知识图谱提供了追溯能力,但应用仍要主动选择一致的数据切片。
3.3 MCP Skill 把正确查询顺序交给 Agent
Data Commons MCP 除了工具,还把操作步骤打包成 MCP resources 中的 skills。例如,单地点查询、区域内子地点比较、多实体方向关系查询,分别有不同的 playbook。
这是一种值得关注的设计:协议只定义“能调用什么”,skill 则补充“应该按什么顺序调用”。对于公共统计,正确流程通常不是直接取数,而是:
- 搜索候选指标;
- 检查定义、来源和可用年份;
- 选择一致的 facet;
- 获取观测;
- 在答案中保留来源与口径说明。
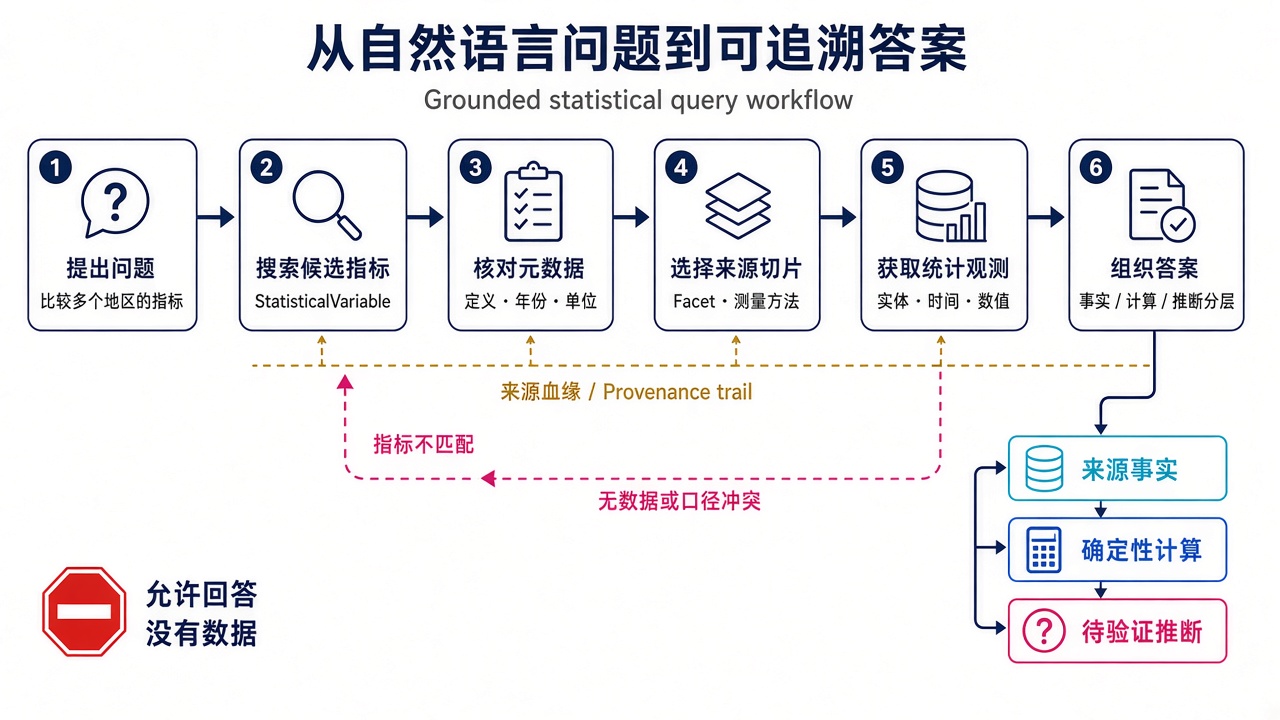
这条链路里,MCP 是运输层,skill 是查询策略,知识图谱是语义与来源底座。三者缺一,Agent 都可能“正确调用了错误数据”。
四、谁在用,效果如何
平台刚发布,成熟的生产案例还不多。现阶段最可靠的证据来自联合国上线规模、Google 的 DataGemma 实验,以及 ONE Data Agent 的真实应用。
4.1 联合国:六个月连接 26 个实体
联合国案例的独特价值,是它验证了跨组织语义整合能否在真实治理边界下推进,而不仅是技术 demo。
| 指标 | 发布时数据 |
|---|---|
| 参与实体 | 26 个联合国系统实体 |
| 数据规模 | 近 4400 万条统计观测 |
| 统计序列 | 超过 1700 个 |
| 建设周期 | 约 6 个月;项目在 9 个月内交付 |
| 访问方式 | 自然语言搜索、浏览、下载、开发者接入 |
| 扩展目标 | 2027 年覆盖联合国系统 80% 的统计数据集 |
项目由 UN DESA、UNICEF 与联合国秘书长执行办公室共同推进。平台并没有取消各机构原有门户,而是通过共享基础设施让用户跨机构搜索,同时保留来源回链。
UNICEF 在发布会上给出的营养分析场景很典型:全球约有 2 亿五岁以下儿童受到营养不良影响,但解释原因需要把营养数据与贫困、食物安全、疾病、教育、气候和流离失所数据组合起来。Data Commons 的价值不是替分析师给出因果答案,而是把“先花几个月找数据、对编码、拼表”的成本压缩到可交互查询范围。
核心教训:跨机构平台首先是治理与语义工程,其次才是 AI 产品。
4.2 DataGemma:接入可信数据后,准确率与覆盖率同时暴露
DataGemma 实验提供了“接上知识图谱后究竟改善多少”的量化证据,也给出了很容易被宣传材料忽略的反面数据。
| 指标 | 结果 |
|---|---|
| RIG:原始模型事实准确率 | 4.9%–16.7% |
| RIG:Data Commons 返回统计值准确率 | 57.7%–58.8% |
| RAG:检索后统计陈述准确率 | 98.6%–98.9% |
| 基础 Gemini 1.5 Pro 统计陈述准确率 | 39% |
| RAG:含统计陈述的查询覆盖率 | 24%–29% |
| RAG:推断性陈述准确率 | 71.9%–76.4% |
当相关表格被成功检索并放进上下文后,模型引用统计数字的准确率接近 99%,显著高于基础模型的 39%。但这不是端到端 99%:在 101 个评测问题中,只有 24%–29% 的查询最终生成了基于 Data Commons 的统计陈述。
覆盖不足有两类主要原因:一是 Data Commons 没有对应数据,二是模型生成的查询不完整或不正确。更重要的是,引用正确数字不等于推断正确。模型基于表格做出的推断,准确率只有 71.9%–76.4%;它仍可能漏掉应进入前五名的国家,或把“中位年龄 35 岁”擅自解释成“拥有大量年轻专业人士和家庭”。
核心教训:可信检索能修复数字,不能自动修复推理。
4.3 ONE Data Agent:把数千万条卫生融资数据交给普通用户
ONE Data Agent 是 Data Commons MCP 的首批公开应用之一,面向卫生融资研究与倡议人员。
| 维度 | 公开信息 |
|---|---|
| 数据规模 | 数千万条卫生融资数据点 |
| 交互方式 | 自然语言搜索 |
| 结果形态 | 可视化与可下载的清洁数据集 |
| 目标用户 | 政策研究、倡议、报告团队 |
| 已公开评测 | 未披露端到端准确率或节省工时 |
这个案例说明 MCP 确实降低了公共数据产品的开发门槛:团队不必让用户理解底层 API 与变量编码,就能构建面向领域的查询 Agent。但公开材料尚未提供准确率、任务完成时间或人力节省等正式评测,因此不能把“数秒查询”直接等同于生产价值。
核心教训:易访问是采用的前提,但效果评估仍要回到任务准确率与人工复核成本。
五、核心洞见
把三组证据放在一起,真正值得带走的不是“MCP 很方便”,而是数据、协议与模型之间的责任边界。
| 结论 | 证据 | 工程含义 |
|---|---|---|
| 语义整合先于 Agent 接入 | UN 项目先建统一图谱,再开放自然语言与 MCP | 不要先做聊天框,再补指标口径 |
| 来源可追溯不等于来源已选对 | 同一变量可以有多个 facet | 查询必须显式检查来源、单位和测量方法 |
| 可信检索显著提高数字准确率 | 统计陈述 98.6%–98.9% | 把数值事实移出模型参数 |
| 数据覆盖仍是主要瓶颈 | 只有 24%–29% 查询产生检索统计陈述 | 没有数据时,Agent 应承认缺口而非补全 |
| 正确数字仍可能导出错误结论 | 推断准确率 71.9%–76.4% | 区分“来源事实”与“模型推断” |
| MCP 目前只开放部分图能力 | 不支持事件、自定义实体、图关系探索 | 标准接口不等于完整数据能力 |
洞见一:MCP 是插座,不是发电厂
MCP 统一的是连接方式:Agent 知道有哪些工具、参数如何传递、结果怎样返回。它不会自动统一“失业率”定义,也不会替你选择正确的调查口径。插座标准化之后,电从哪里来、质量如何,仍由后面的数据系统决定。
洞见二:Agent-ready 数据的最小单位不是表,而是“带来源的统计断言”
一张表只告诉模型列名和数值;一个可用的统计断言还应包含实体、指标定义、时间、单位、测量方法和来源。Data Commons 把这些元素建模成图节点、观测与 facet,才使 Agent 有机会判断两个数值能否比较。
洞见三:减少幻觉的第一步,是允许系统回答“没有数据”
DataGemma 的低覆盖率不是单纯的失败,它揭示了一项必要能力:外部数据源不可能覆盖所有问题。可靠系统必须区分“没有找到”“没有收录”和“指标不存在”,并阻止模型把缺口补成一个听起来合理的数字。
洞见四:事实层与推断层必须分开审计
即便统计数字有权威来源,模型仍可能在排名、相关性解释和政策建议中犯错。最终答案应区分可回链的来源事实、确定性计算结果和模型生成的解释,让复核者知道哪部分可以直接引用,哪部分只是待验证推断。
六、行业影响:数据平台要从“可查询”走向“可委派”
当查询者从人变成 Agent,数据平台的设计目标会发生结构性变化。
数据目录将演化为行动约束。 过去的数据目录服务人类搜索,字段描述不完整时,人还能询问同事。Agent 会把模糊定义直接转化为工具调用,因此目录必须提供机器可读的实体解析、指标结构、来源和版本信息。
数据工程师会更多地维护语义资产。 管道稳定只是底线。变量是否复用、地域实体是否正确映射、facet 是否混源、测量方法是否一致,会直接决定 Agent 输出能否引用。数据工程工作将从搬运数据延伸到维护可组合的统计语义。
公共数据会成为 Agent 时代的重要基础设施。 联合国数据过去面向下载和人工研究;MCP 让它可以直接进入研究助手、政策模拟、新闻核查与教育工具。但这种能力也放大了错误解释的传播速度,因此来源回链、使用条款和人工复核必须与访问能力同步开放。
企业会重新评估语义层与知识图谱。 很多企业把 MCP 项目理解成给数据库加工具接口。UN System Data Commons 提供了相反的参照:如果底层没有稳定的实体、指标和来源模型,MCP 只是让 Agent 更快地访问一组含义不一致的表。
七、实践入门:企业怎样复制这条路径
不需要从 4400 万条观测起步。更实际的做法,是选一个跨系统、口径冲突明显的业务主题逐层建设。
L1:可追溯查询
适合已有 API 或数仓、准备接入 Agent 的团队。
- 为每个指标建立唯一 ID、定义、单位和负责人;
- 返回数据时强制携带来源、时间与版本;
- 将“无数据”与“查询失败”设计成不同状态;
- 先提供只读工具,不开放写入和自动决策。
交付标准:任何一个答案都能回到具体数据集与观测时间。
L2:统一语义
适合存在多套指标平台、跨部门分析困难的企业。
- 建立客户、产品、地域、组织等核心实体映射;
- 将指标拆成测量对象、属性、统计方式和约束维度;
- 为同一指标的多来源数据建立 facet 或等价机制;
- 在 MCP 取数前增加指标搜索与元数据确认步骤。
交付标准:Agent 能解释为什么选择某个指标和某条来源。
L3:可委派分析
适合高价值、受监管或需要自动生成报告的场景。
- 将标准查询流程封装成 Agent skill;
- 分离来源事实、确定性计算与模型推断;
- 对推断性陈述设置人工复核或独立验证器;
- 持续统计覆盖率、指标选择准确率、引用准确率和推断准确率。
交付标准:团队不仅知道最终答案对不对,还能定位错误发生在检索、口径、计算还是推断。
实施时最容易踩的坑有三个:
- 只封装 SQL,不封装指标定义。 Agent 可以稳定调用一个语义含混的接口。
- 默认选择 preferred facet,却不记录选择过程。 结果看似连续,实际可能跨来源拼接。
- 把来源可信写成结论可信。 官方数据可以支撑事实,但模型生成的因果解释仍需独立验证。
可直接使用的资源包括:
| 资源 | 适用场景 | 备注 |
|---|---|---|
| Data Commons MCP 托管服务 | 查询公共统计数据 | 免费 API key,连接 api.datacommons.org/mcp |
| Data Commons Agent Toolkit | 自定义 Agent 与 skill | 开源,含 MCP 工具和操作 playbook |
| Custom Data Commons | 企业或机构自建知识图谱 | 自建实例需自托管 MCP |
| Data Commons REST / Python API | 确定性数据应用 | 适合绕过自然语言层直接取数 |
| MCF 与 CSV 导入工具 | 接入自有指标与观测 | 应优先复用已有 StatisticalVariable |
八、未来展望
UN System Data Commons 目前更像一块刚铺好的公共底座,它的后续价值取决于覆盖率、语义治理和机器访问能力能否同步扩展。
第一,Agent 会成为公共数据的主要新用户。 数据门户过去围绕网页浏览与 CSV 下载设计,未来会同时服务人和机器。变量元数据、来源和使用条款需要成为 API 的一等对象,而不是网页脚注。
第二,MCP 服务器会从工具目录变成语义网关。 当前 Data Commons MCP 主要支持地理实体与统计观测,不支持自定义实体、事件和一般图关系探索。随着能力扩展,服务端需要承担更强的策略约束,避免 Agent 在巨大图空间里进行不受控遍历。
第三,覆盖率会比模型尺寸更决定体验。 DataGemma 已经说明,在检索成功时统计陈述可以非常准确;真正限制端到端效果的是数据缺口和查询生成失败。未来竞争力更多来自谁能持续接入、清洗并维护高质量数据,而不只是换一个更强模型。
第四,可信数据也会需要可信推理。 当事实层逐渐标准化,错误会向推断层迁移。下一阶段的重点将是可验证计算、声明级引用、因果边界提示和人机协同复核。
结语
“This knowledge is a global public asset, held in trust for humanity.”
——联合国秘书长 António Guterres,UN System Data Commons 发布会
UN System Data Commons 最值得关注的,不是联合国终于支持了 MCP,而是它证明了一条更可靠的建设顺序:先把数据变成带语义、带来源、可比较的公共资产,再让 Agent 来使用。
协议可以降低接入成本,模型可以降低交互门槛,但可信性最终仍来自数据定义、来源治理和对推断边界的诚实表达。你的企业数据平台如果明天接入一个 Agent,它拿到的是一组可调用的表,还是一套能够解释“这个数字是什么、从哪里来、能否比较”的可信断言?
参考资料
- António Guterres,United Nations,2026-09-17,Secretary-General, at Launch of UN System Data Commons, Urges All to Join Single Gateway for Public Access to Trusted, Verified Data, Statistics. https://press.un.org/en/2026/sgsm23285.doc.htm
- United Nations,2026-09-17,Briefing on the United Nations System Data Commons. https://transcripts.un.org/en/asset/k1d/k1dzd1svin
- United Nations,2026,UN80 Initiative: Data — Pre-briefing Materials. https://www.un.org/un80-initiative/sites/default/files/2026-04/260402_Pre-briefing-materials_WP16_Final 2.pdf
- Prem Ramaswami,Google,2026-09-17,Making global data easier to explore. https://blog.google/innovation-and-ai/technology/ai/google-un-data-commons-platform/
- Data Commons,2026,Key concepts and common tasks. https://docs.datacommons.org/data_model.html
- Data Commons,2026,MCP — Query data interactively with an AI agent. https://docs.datacommons.org/mcp/
- Data Commons,2026,Prepare and load your own data. https://docs.datacommons.org/custom_dc/custom_data.html
- Data Commons,2026,Get statistical observations. https://docs.datacommons.org/api/sdmx/data.html
- Prashanth Radhakrishnan, Jennifer Chen, Bo Xu, Prem Ramaswami, et al.,Google,2024-09-12,Knowing When to Ask — Bridging Large Language Models and Data. https://docs.datacommons.org/papers/DataGemma-FullPaper.pdf
- Alex Martin,Google Developers Blog,2025-09-24,Introducing the Data Commons Model Context Protocol Server. https://developers.googleblog.com/datacommonsmcp/
- Google Developers Blog,2026,Access public data insights faster: Data Commons MCP is now hosted on Google Cloud. https://developers.googleblog.com/en/access-public-data-insights-faster-data-commons-mcp-is-now-hosted-on-google-cloud/