AI 原生研发(下·判断篇):真实瓶颈不是写,是验证和删除
上篇《AI 原生研发(上·机制篇)》整理的是 Anthropic 那份《The Claude Code guide for startups》里可以照着动手的部分:材料 8 月 20 日发布,正文带署名引述的一共十三家高速增长的创业公司,从数据库(ClickHouse)到医疗编码(Cainex)、法律(Crosby)、临床记录(Heidi)、居家护理(Zingage)都有,另外还引了 Harvey 和 Cognition 在五月 Code with Claude 活动上的现场发言。
但清单本身不解释因果。材料开头挂了四个数字,最扎眼的是 Artemis Security 的每周 6000 多个 PR——如果只看这个数字,结论很容易滑向“AI 让写代码变快了”,然后你会按这个理解去排优先级,排错。
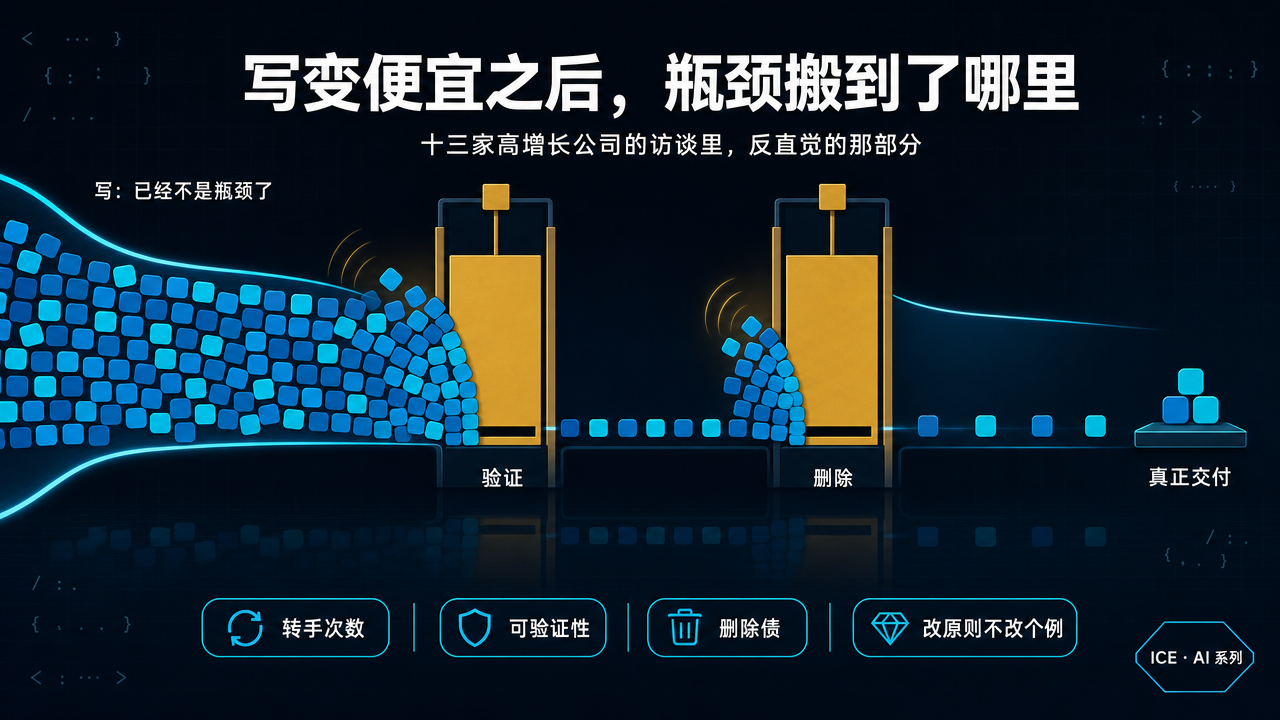
因为把十三家公司的原话连起来读,会发现一件反直觉的事:他们花最大力气解决的,几乎都不是“写”。写这件事在这些团队里已经不是问题了。真正被反复提到、被投人投时间去做基础设施的,是另外两件过去永远排不上优先级的活——怎么确认 agent 干对了,以及怎么把旧的东西删干净。
这篇要讲的就是这个错位:增益到底从哪来、瓶颈搬到了哪里、这份材料哪部分能信,以及哪几条国内团队明天就能抄。
一、四个数字说的不是同一件事
先看这四个自报指标。它们经常被放在一起当成“AI 提效”的证据,但其实衡量的是研发链条上完全不同的环节。
| 公司 | 自报指标 | 实际衡量的环节 |
|---|---|---|
| ClickHouse | 交付特性数 +30% | 产出总量 |
| Omni | 工程效率 2–3 倍 | 单人产能 |
| Clay | bug 分诊 100% 自动化 | 一类流程被整体接管 |
| Artemis Security | 每周 6000+ PR | 变更吞吐量 |
四个数字里,只有 Clay 那条是“一个流程从此不再需要人排队”,其余三个都是产量或速度。而变更吞吐量这种指标最容易被 agent 抬高——agent 天然倾向于把一件事拆成很多个小 PR,所以 6000 这个数量级更适合读作“他们的合并链路能承受多大流量”,而不是“他们的产出是别人的多少倍”。
真正解释了增益来源的,反而是 Heidi 联合创始人兼 CEO Thomas Kelly 的一段话。他没提任何倍数,说的是“传声筒问题”:
一个新想法过去在团队里是怎么流动的?有想法的人告诉 PM,PM 告诉设计,设计再告诉工程……想法的精髓在这条链上必然走形。等东西真的上线,往往已经不像最初那个人脑子里的样子了。而且要花好几周。Claude Code 把这条链压掉了。
这句话把增益的来源从“打字速度”换到了“转手次数”。一个想法在组织里每转一手都会掉一点信息,掉的那部分不会体现在任何研发效能报表里,但它是返工和“做出来不是我要的”的主要来源。如果收益主要来自减少转手,那 2–3 倍这个量级就不奇怪了——省掉的不是编码时间,是沟通折损和排队等待。
这也解释了为什么这些公司的做法看起来都不太像“引入一个编程工具”,更像在改组织。Artemis 联合创始人兼 CEO Shachar Hirshberg 那句话说得最直接:
所有人都在抢着造 AI 产品,很少有人在重造公司自己怎么运转。第二件才是更大的解锁。
二、自动化的天花板是验证能力,不是模型能力
访谈里最值得抄的一条因果,方向和大众直觉是反的。
一般的叙述是“用了 AI,所以快了”。但 Artemis 另一位联合创始人 Dan Shiebler 解释 6000 PR 时,因果是倒过来的:
这个速度之所以成立,是因为我们在测试基础设施、代码库组织、团队知识系统上投入很深,才让 agent 能端到端地交付。这就是我们和 Claude 一起建起来的飞轮:把代码库、知识库和团队结构做对,之后每一次贡献都会复利。
换句话说,不是 agent 让他们快,是他们先把“可验证”这件事做扎实了,agent 才敢放开跑。你能自动化多少,取决于你能自动确认多少。 这条约束是硬的,跟模型换成哪一代关系不大。
Zingage 联合创始人兼 CEO Victor Hunt 给了反面的经验。他们早期给了 Claude 完全的自主权,结果是“它做了 AI 会做的事:飞快地产出看起来很合理的代码”,问题是这些代码在偏离架构的方向上偏得看不出来。他们的解法是把每一条不变量都写下来——怎么定义问题、什么必须永远成立、怎么证明一个东西真的成立而不是去信任一个听起来很自信的答案,最后成了“567 行这个团队怎么思考”。
而把这件事做到最完整的是 Cainex。他们做医疗编码,联合创始人兼 CTO Uriah Israel 一句话就把约束条件讲清楚了:
在医疗编码里,一个错的码不是笔误,是一次计费和合规事件。这一个事实决定了我们怎么构建系统。
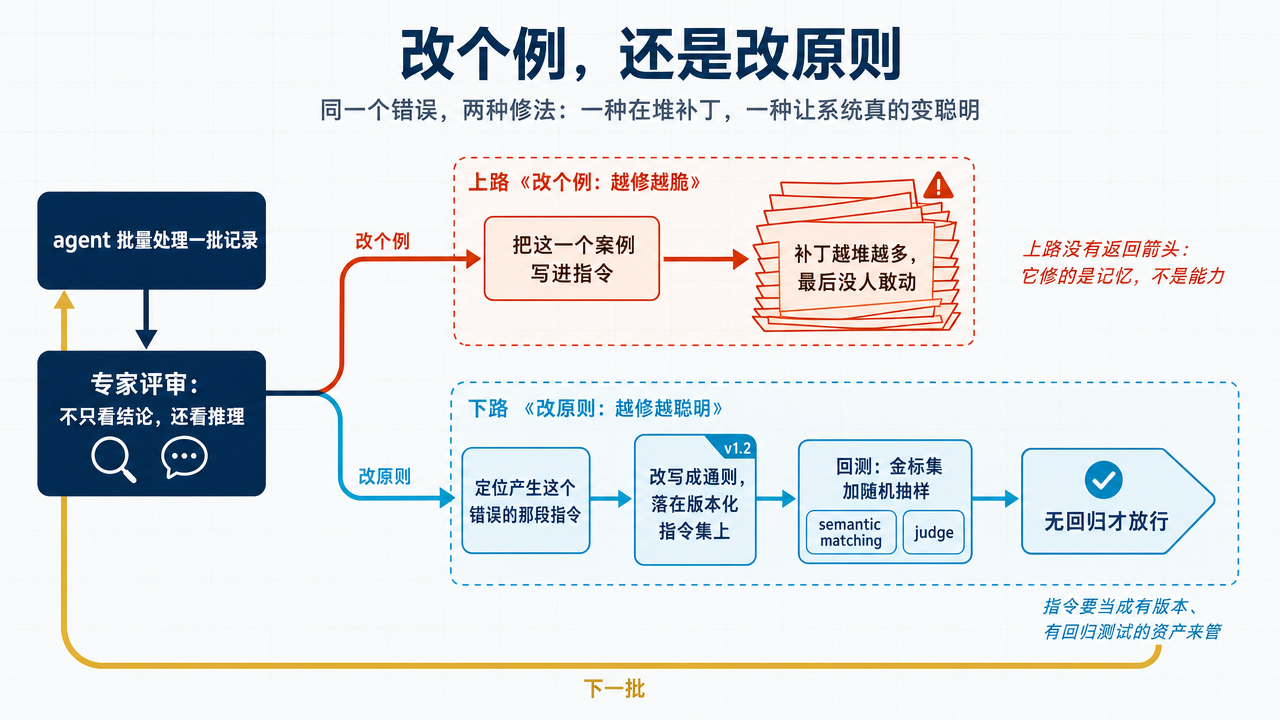
他们的闭环大致是这样:agent 批量处理记录,审计员在内部应用里评审输出——注意,审计员看到的不只是最终编码,还有模型的推理过程,并且可以对推理本身留评论。然后 Claude Code 接手,从数据库里读原始预测加上每一条修正和评论,每条修正都按码的类型打了标签,所以它知道自己在看的是诊断类问题还是操作类问题,能直接去找管着这一类编码的那份指引。
关键的一步在这里:它找到产生这个错误的那段指令去改写,或者在案例确实全新时写一条新指引。所有改动都落在一份版本化的指令集上,并且用曾经失败过的那些记录做测试。Uriah 把这条规则总结成一句:
fix the principle, not the example.(改原则,不改个例。)
然后是回测。一条记录可能有多种可以接受的编码方式,所以不能用字符串匹配,他们的做法是语义匹配加一个 judge,专门判断“这到底是真错,还是另一条同样有效的路径”;候选改动要在一个 golden set 加随机抽样上跑一遍,把任何回归暴露出来才允许上线。
最有价值的是他承认第一版不长这样:
我们最初那版过拟合了。它“修问题”的方式是把那个具体案例编码进去,结果我们在积累补丁,而不是变得更聪明。后来我们改了方法,强制上升为通则,并且限制单次改动里最多能进入多少具体案例。
这段话值得任何在做 agent 的团队贴在墙上。绝大多数团队现在的提示词维护方式,就是他说的第一版:出一个问题补一句话,出一个问题补一句话,三个月后没人敢动那份提示词。区别不在于用了什么模型,而在于有没有把指令当成有版本、有回归测试的资产来管。
顺带说一个 Anthropic 自己的数据点,因为它是同一条逻辑:Claude Tag 已经做了几个月 CI/CD 的 on-call 第一响应,近期每一次有情况报告的事故,第一份都是 Claude 写的,通常在 15 分钟内发出。它能这么干的前提不是模型强,而是权限、工具访问和常驻指令这三样都被当成工程资产管起来了——具体怎么配的在上篇。
ClickHouse 那个例子则给出了一个很实用的选题标准。他们两个专门修 flaky test 和补测试覆盖的 agent,现在是仓库里第二和第三大贡献者。为什么是这两件事先跑通?因为它们的停止条件明确——把测试重跑到通过就是通过,agent 可以自己验证自己。这比“实现一个新功能”清晰得多。想找第一个能真正托付给 agent 的活,就从有明确停止条件的地方找。
三、写变便宜之后,“删”成了新瓶颈
第二个反直觉的地方,是这些团队对“重建”的态度。
常规的工程直觉是尽量少推翻,因为重写有成本、有风险、还不产出新功能。但 Clay 联合创始人兼 CEO Kareem Amin 的说法是:
我们在 Clay 的做法是,你建一遍,然后再建一遍,再建一遍。建到第四遍,你就知道全部需要什么了,你会做对。所以我们并不是把东西丢掉,我们只是重建,而这次更清楚。
Harvey 的应用 AI 负责人 Niko Grupen 在五月的活动上讲的是同一件事的架构版本:每一波模型能力(涌现推理、agentic 自动化、规划与编排)都逼着他们整体重构平台。他说如果六个月前问他们架构什么样,答案和今天完全不同,“如果我们当时不愿意说『这个得推掉,去做 agent 原生』,现在平台里就不可能有这些能力”。Cognition 联合创始人 Walden Yan 说得更狠:现在做 AI 的生存方式,就是接受你今天造的东西六个月到一年内很可能被扔掉。
但真正把这件事讲到点子上的是 Commure 的创始人兼 CEO Tanay Tandon:
一次重建不是新路径上线就算完,是旧路径消失才算完。拆除工作以前总是输掉优先级之争——它又琐碎,又不产出任何新功能。
这句话点出了变化的实质。AI 让“写”变便宜,暴露出来的是“删”一直很贵。 而删除工作的贵不在技术难度,在于它永远排不上优先级:没有需求方,没有 demo 可看,做完了汇报里也不好写。
Commure 现在的做法是一个 skill:对每一个已经全量放开的 feature flag,开一个 PR 把它和相关代码删掉,然后由工程师审查返回的结果。过去要吃掉大量开发周期的迁移,现在是一次规划加一次扇出,几个小时完成。同一位创始人还提到,他们有工程师用子 agent 并行推进一个大约十三个工单的项目,每个 agent 负责一个工单和它的 PR。
这里有一个企业侧的连带影响,值得单独点出来:如果架构的有效期真的缩到六到十二个月,那么“系统按三到五年摊销”这个财务和采购假设就开始失效了。国内很多组织的 IT 预算、招标周期和验收方式,都建立在“建成即稳定”的前提上。当上游的模型能力每几个月抬一次,验收标准里就得有一条“这套东西怎么被替换掉”,否则每一次升级都会变成一次立项。
Higgsfield 联合创始人兼 CEO Alex Mashrabov 描述的正是这种节奏下的生存状态:新的视频和图像模型不断出现,每一个都需要新的 skills、评测、路由逻辑和生产测试才能上线,Claude Code 把这个周期从几天压到几小时,让他们能在同一个会话里定位生产问题并部署修复。他的结论是:“当你在跟人手是你十倍的公司竞争时,这种杠杆改变一切。”
四、“人人都能发版”其实是分工换了位置
第一条原则叫 Everyone ships,最容易被读成“以后不需要专业分工了”。原文其实明确否掉了这个理解:
我们得到的答案是,分工依然存在。市场的人还在做市场,开发的人还在做开发。但把一个想法变成能跑的原型这至关重要的第一步,也就是 0 到 1 那一段,对所有人开放了。
所以变的不是“有没有分工”,而是分工的起点被往后挪了。过去的门槛在“谁能把想法变成代码”,现在的门槛在“谁能把第一版变成产品”。
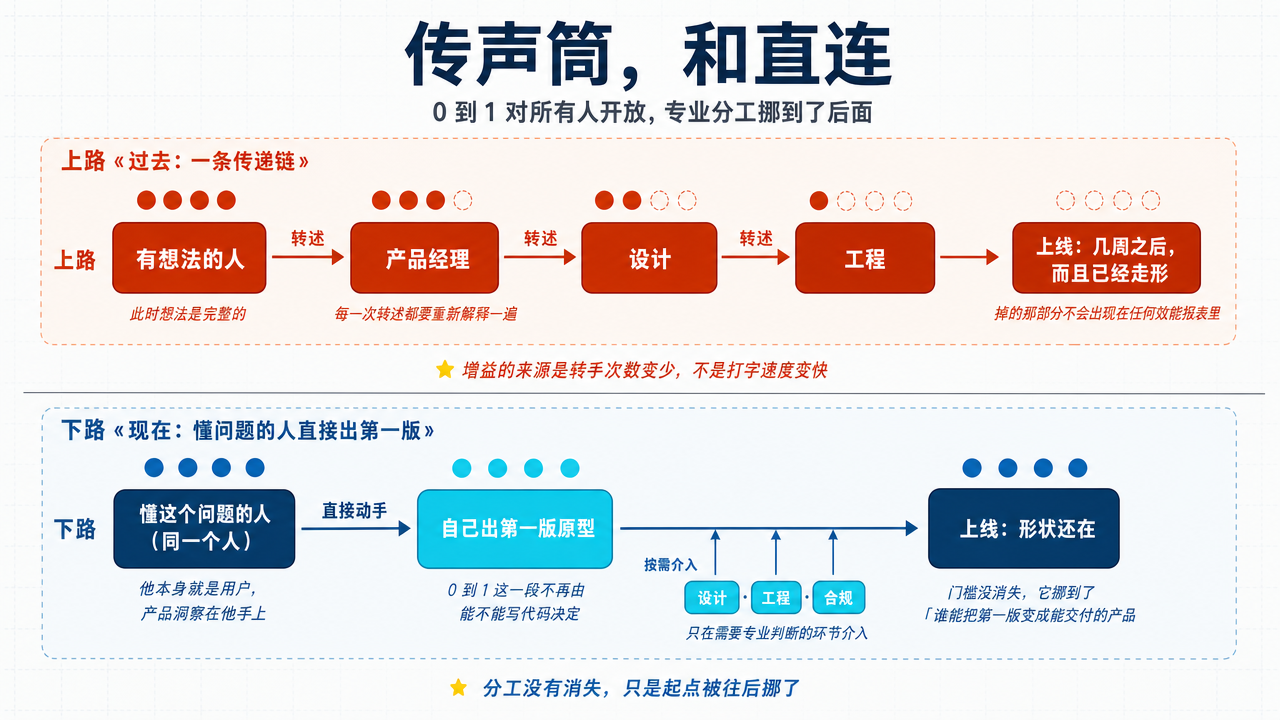
Crosby 的例子最能说明落地方式。联合创始人兼 CEO Ryan Daniels 说 Claude Code 改变了“在 Crosby 当律师意味着什么”,因为律师有最好的产品洞察——他们本身就是用户。但更值得注意的是他们的做法:团队不是把律师带到 Claude Code 面前,而是把 Claude Code 接到律师每天在用的那些工具和系统里。
这个细节对国内落地特别有参考价值。多数企业推 AI 工具的方式是培训加考核,本质上是要求业务人员迁移到一个新工具里去。Crosby 的方式反过来:工具去找人。这不只是姿态问题——一个每天要复制粘贴才能把上下文喂进去的流程,注定只有最积极的那几个人会长期坚持,而接进去之后所有人的默认路径就变了。(接进去的具体判断标准,比如什么时候用 MCP、什么时候直接授权命令行工具更省,上篇第二节有。)
光有入口还不够,这些公司都建了机制让贡献变成常态而不是碰运气。Clay 的做法是季度评审,原型在这里被评估、能进正式路线图——他们一个市场增长同事就这么做出了一个 agent,自动访问网站、填写线索表单、计时响应速度、给体验打分并生成报告。Omni 有一个专门收 Claude 生成原型的 Slack 频道,资深工程师也在里面发;他们还反过来执行“所有人都跟客户聊”,故意把工程师推到客户面前,因为这样反馈闭环更快。
约束的部分靠 skills 和 CLAUDE.md 承担。Emergent 联合创始人兼 CEO Mukund Jha 讲的一个细节很成熟:他们有一个装 skills 的 GitHub 仓库当共享知识库,用来快速把公司上下文、数据库和数仓位置、部分表结构注入一个新会话;新人第一天把 Claude 指向对应的 markdown 文件就能自助搭好开发环境,Claude 如果在过程中撞到过期或者坏掉的地方,就顺手更新那份文件。他特意加了一句:
与其在这件事上追求完美,不如接受上下文文件稍微过期——只要 agent 能快速核实并自我纠偏就行。
这句话消解了很多团队做知识库时的心结。共享上下文不需要是一份永远正确的文档,它只需要好到让 agent 能自己发现哪里不对。Translucent 创始人兼 CEO Jack O'Hara 描述的则是这套东西长大之后的形态:工程师用 Claude Code 搭了一个内部 agent 市场,按角色组织,工程、交付、销售各有自己那套工具。
顺着这条线还有一个更早的观察值得放在一起。去年 11 月 Anthropic 那篇访三家 YC 公司的文章里,HumanLayer 创始人 Dexter Horthy 说:一旦团队里有多个人都在发 AI 写的代码,你面对的就是完全不同类型的问题——那是沟通、协作、工具和管理问题,你得把团队构建软件的方式整个重接一遍。九个月后这份新材料里的十三家公司,做的基本都是这件事。
五、这份材料该打几折
得说清楚它的性质:这是厂商发布的客户访谈,同时也是分发动作——配了 PDF、结尾附 checklist、导向自家的 startup program。受访者是愿意公开站台的成功客户,没有对照组,也没有失败样本。
具体到那四个数字,口径都是模糊的:ClickHouse 的“+30% 特性”是同比还是相较引入前?Omni 的“2–3 倍工程效率”用什么衡量?Artemis 的“6000+ PR”如前所述更像吞吐量而非价值。这些都属于自我报告的信号,不能当基准线。谁要拿这几个数字去立项,大概率会在验收时被问住。
方向上倒是有独立佐证。Business Insider 在 5 月 23 日发过一次调研,访了两打以上的创业者和投资人,结论是 Claude Code 已经成为初创公司里的默认 AI 编程工具,Cursor 被普遍描述为在退成次要工具。里面还有个挺有画面感的细节:安全公司 Tenzai 会议室的视频系统在 Zoom 里花屏,团队没叫 IT,直接把 Claude Code 装到控制器上、给了系统级权限让它自己查,大约 25 分钟定位到硬件不兼容并给出了修法。样本仍然偏硅谷初创,但至少不是厂商自己的口径。
所以我的读法是:倍数当信号看,做法可以直接抄。 那些结构性的东西——版本化的指令集、golden set 加回归回测、把不变量写进仓库根、用 hooks 做硬门禁、worktree 并行跑重建、专职删除的 agent——不依赖任何倍数是否真实。它们在效率只提升 20% 的团队里同样成立,而且成本低得多。
六、国内团队现在能抄哪几条
按可迁移性把访谈里的做法过一遍,大致是这样:
| 做法 | 可迁移性 | 主要卡点 |
|---|---|---|
| 把不变量写进仓库根的 CLAUDE.md | 高,近乎零成本 | 很多团队的架构约定本来就没落成文字 |
| golden set + 回归回测,改原则不改个例 | 高,性价比最高 | 缺人维护评测集,也缺愿意投时间判定对错的领域专家 |
| 专职删除的 agent(清 feature flag、清死代码) | 高 | 测试网不全,删了不敢合 |
| 有明确停止条件的 agent(修 flaky test、补覆盖) | 高 | 需要 CI 本身足够稳,否则 agent 在噪声里打转 |
| 用 hooks 做硬门禁(lint 不过不许写、测试不过不许提交) | 高 | 几乎没有,属于最该先做的一条 |
| agent 做 CI/CD on-call 第一响应 | 中 | 监控系统的服务账号和权限由谁审批 |
| 把工具接进业务系统(Crosby 式) | 中,要投人 | 内网隔离、数据出域、连接器的合规审查 |
| 非技术同事直接发 PR | 低到中 | 代码库准入、审批链和合规流程;更现实的落点是内部工具和报表,而不是主产品 |
真正的分水岭不在工具选型,而在有没有人愿意为“验证”买单。修 flaky test、维护 golden set、清理死代码,这三件事在多数国内团队的考核体系里都不算业绩。而按这十三家公司的经验,恰恰是这三件事决定了 agent 能被托付到什么程度。
一个可操作的起点是:不要从“让 agent 写业务功能”开始。先找一件有明确停止条件、且当前正在浪费大家时间的活——flaky test、缺失覆盖、过期 feature flag、on-call 第一份情况报告——把它的验证方式先写清楚,再交给 agent。这件事跑顺了,你会顺手拿到测试基础设施和一份可复用的上下文,而这两样恰好是下一步的前置条件。往后的完整推进顺序,上篇结论里排了五步,逻辑就是本节这条:每一步都在为下一步准备验证能力。
结论
读完这份访谈,我会带走四条:
- 增益的主要来源是转手次数,不是打字速度。 Heidi 的“传声筒问题”比任何倍数都更能解释为什么效率是 2–3 倍而不是 20%——省掉的是信息在组织里传递时的折损和排队。
- 自动化的上限由验证能力决定。 Artemis 的因果是“先有测试基础设施和知识系统,才有每周 6000 个 PR”,不是反过来。想放开 agent,先问自己能自动确认什么。
- 写变便宜之后,删成了新瓶颈。 拆除工作过去永远输掉优先级之争,现在它是重建能否闭环的关键一步。顺带一提,如果架构有效期真的只有六到十二个月,“三年摊销”这个采购假设需要重新想。
- 提示词要当资产管,不是当补丁堆。 Cainex 那句“改原则,不改个例”加上版本化指令集与 golden set 回测,是这份材料里最可迁移、也最少人真正在做的一条。
至于“人人都能发版”,它不意味着专业分工消失,只意味着 0 到 1 这一段不再由能不能写代码来决定。门槛还在,只是搬到了后面——从“谁能把想法变成代码”,变成“谁能把第一版变成能交付的产品”。
这四条判断都指向同一个动作:先把验证能力建起来。具体建什么、按什么顺序建、每一层放什么,上篇《AI 原生研发(上·机制篇):把 agent 接进流程,十三家公司在用的那些机制》整理成了清单,包括原文那份 checklist 的中文版。
参考资料
- Michael Segner,Anthropic,《The Claude Code guide for startups》,2026 年 8 月 20 日。文中十三家公司的引述、四个自报指标、Claude Tag 的 15 分钟数据均出自此文。https://claude.com/blog/claude-code-guide-for-startups
- Anthropic,《How three YC startups built their companies with Claude Code》,2025 年 11 月 17 日。HumanLayer、Ambral、Vulcan 三家的访谈。https://claude.com/blog/building-companies-with-claude-code
- Business Insider,《Inside startups, Claude has already won the AI coding wars》,2026 年 5 月 23 日。两打以上创始人与投资人的独立调研。https://africa.businessinsider.com/news/inside-startups-claude-has-already-won-the-ai-coding-wars/nm4fp3j
- Anthropic,《The Founder's Playbook: Building an AI-Native Startup》(36 页白皮书),2026 年 5 月。https://cdn.prod.website-files.com/6889473510b50328dbb70ae6/69fe2a55b93bb0732b1fe33c_The-Founders-Playbook-05062026_v3 (1).pdf
本文部分内容由 AI 辅助生成,经人工审校和补充后发布。