查数别再切一堆控制台:Data Agent Kit 把数据工作台搬进编辑器
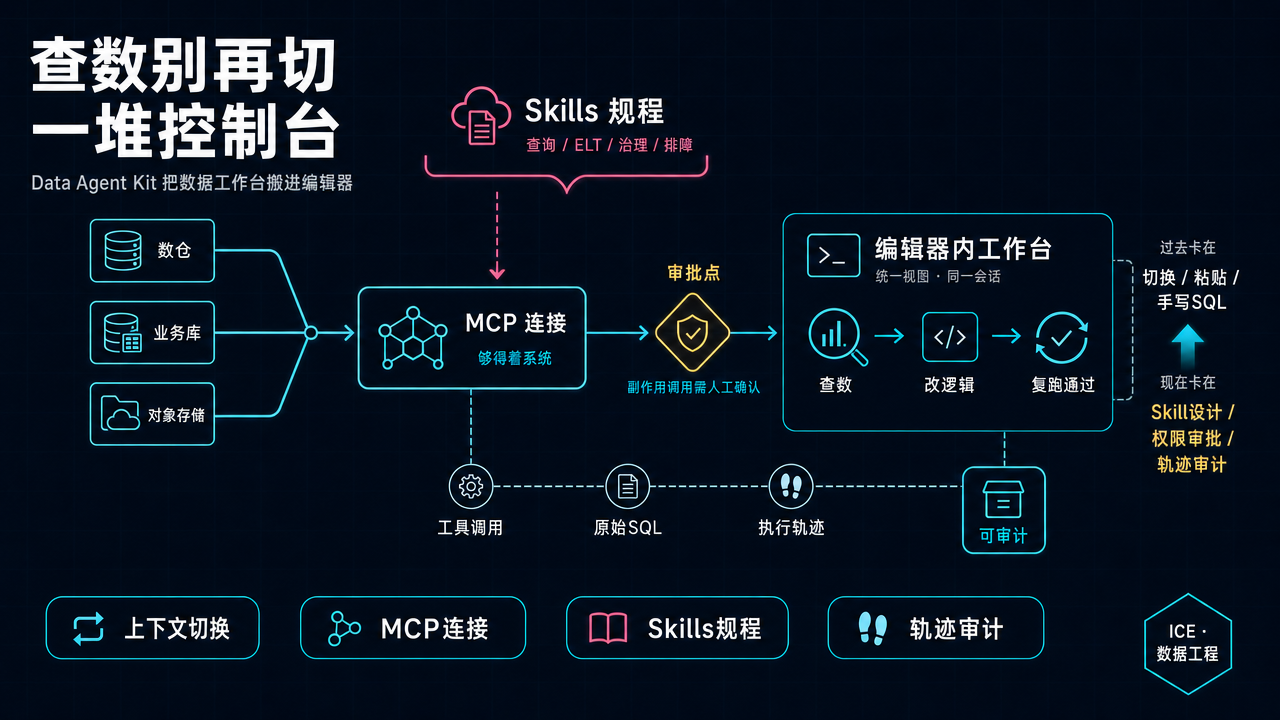
数据工程师一天里最耗神的,往往不是“会不会写 SQL”,而是上下文切换:异常在数仓里,客户属性在业务库,活动规则在对象存储的 JSON 里;要答一个业务问题,得在控制台、CLI、编辑器之间来回跳,把 schema 手工糊进提示词,再把生成的 SQL 拷到别处执行。
Google Cloud 把解决这个问题的产品线,收成了一个开源预览包:Data Agent Kit。官方定位很直白——让数据科学家、数据工程师和数据应用开发者,在自己惯用的开发环境里管完整条数据工作负载生命周期,而不必在 Google Cloud 控制台、命令行和 IDE 之间反复切换。
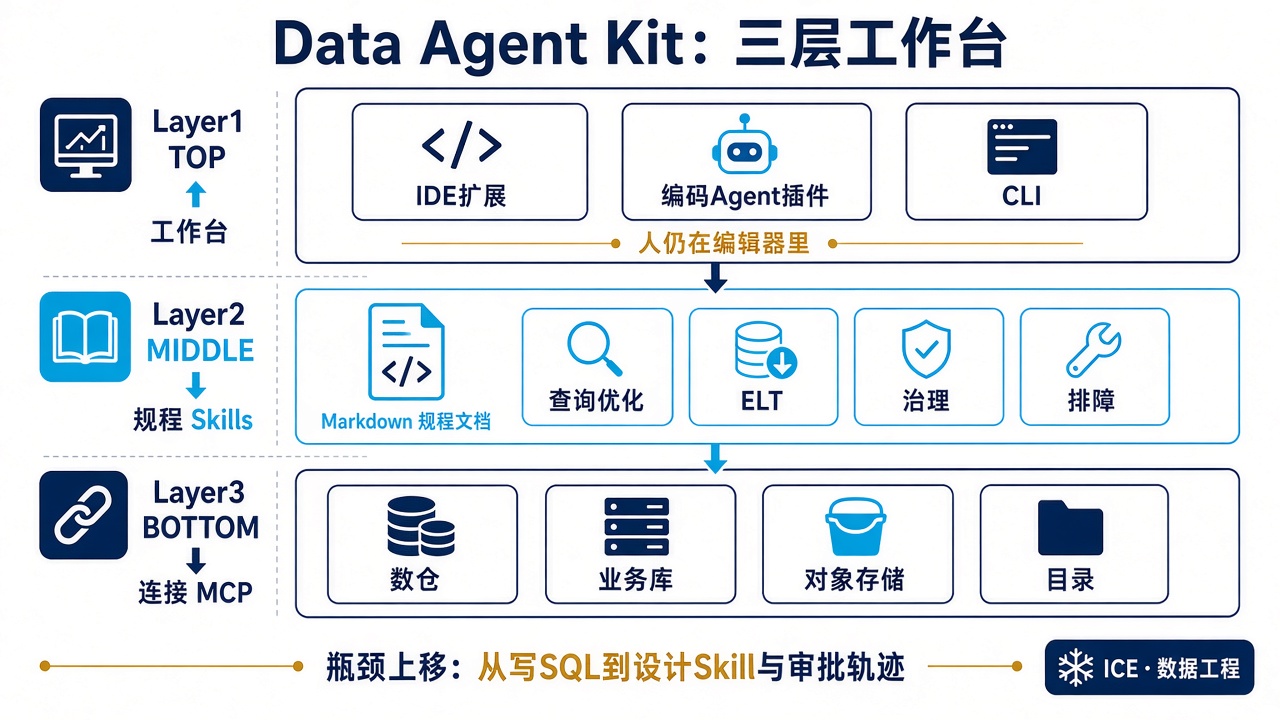
它不是又一个聊天式 BI。核心组合是三样东西:Agentic Skills(规程)、MCP 工具(连接)、IDE 扩展 / 编码 Agent 插件(工作台)。
一、它到底装了什么
按官方文档,Data Agent Kit 有两扇门:
- IDE 扩展:面向 VS Code 及兼容 IDE(含 Cursor、Antigravity 等),提供数据资产与工作负载的统一视图;Cloud Workstations 默认安装,并接入 Cloud Code。
- 编码 Agent 插件:把自然语言提示接到 Google Cloud 数据上;支持 Antigravity CLI、Claude Code、Codex CLI、Gemini CLI 等。
底下撑着的能力,可以拆成两层:
MCP 负责“够得着”。 远程 MCP Server 把 BigQuery、AlloyDB、Cloud SQL、Spanner、Cloud Storage、Knowledge Catalog、Managed Spark 等接到 Agent。例如 BigQuery 的端点是 https://bigquery.googleapis.com/mcp。Agent 不再只生成一段让你粘贴的 SQL,而是在授权后直接执行、查看结果;开发环境仍可在只读查询等动作前暂停,要求人工批准。
Skills 负责“怎么做”。 Skills 是预编码的 Markdown 规程——查询优化、ML 实践、数据校验、漂移检查、治理、排障、ELT 等——把 Google Cloud 侧的数据工程 / 数据科学经验,注进 IDE 或 CLI 的 Agent,而不是指望通用模型每次临场发挥。
官方博客还点了一个痛点:搭跨复杂数据架构的 Agent 应用时,常有 context window tax——开发者要把大量 schema 元数据手工贴进提示,吃掉 token、拉高延迟。Data Agent Kit 的意图,是用 MCP + Skills 把“estate 可见性”和“操作规程”从提示词里挪到工具与文件里。
支持的服务覆盖分析与治理(BigQuery、Dataflow、Spark、Airflow、Knowledge Catalog)、数据库(AlloyDB、Cloud SQL、Spanner)和存储(Cloud Storage)。预览阶段也有硬边界:AlloyDB / Cloud SQL 若走内置认证或 Auth Proxy,扩展侧不支持,须开 IAM 认证;编排流水线的自动部署目前只接 GitHub Actions。
二、一个跨系统排查长什么样
IT Brief 转述的零售案例,比功能清单更说明问题。场景是:收入持平,但客单价(AOV)下跌。 分析销售在 BigQuery,客户档案在 Cloud SQL PostgreSQL,营销活动规则是 Cloud Storage 里的原始 JSON。
流程大致是:
- 在 IDE 里用自然语言要求按订单表算月度 AOV;批准工具调用后,Agent 查 BigQuery:约 8–12 月 AOV 约 $110,1 月跌到约 $103。
- 追问按订单类型拆开:线上、线下仍接近 $110,新出现的 B2B-Wholesale 渠道约 $75。
- 转到 Cloud SQL,核对批发单关联客户:100 个批发账户都是近 30 天新建的企业主体。
- 再到 Cloud Storage 读活动文件:约 92% 的 B2B 订单用了某促销码,对应 25% 折扣——客单价被拉低,总收入却可以不掉。
同一会话里,用户还可以让 Agent 起一个 dbt 项目:把 BigQuery staging 与 Cloud SQL 客户 / 宠物画像拼起来,加 order_id 唯一性测试并跑 dbt build。第一次失败——客户可有多只宠物,直接挂到订单上会炸出行;Agent 读终端输出,改逻辑,再跑到测试通过。
这暴露了产品真正卖的工作方式:调查型分析 + 当场沉淀成可重复工程,而不是一次性聊天答案。人也没被撤掉——仍要审生成代码、仍要质量门禁;只是“读一段陌生 schema 上的查询”通常比“从零写”便宜。
Google 特别强调可见性:可在开发环境里检查执行轨迹,包括单次 MCP 工具调用,以及打向 BigQuery 的原始 SQL。对团队来说,这才是 Agent 能进生产数据面的前提——看得见它调了什么,才能批、才能追。
三、对数据团队意味着什么
过去,数据岗的熟练度很大一块花在“熟悉各控制台、记住连接方式、手写跨系统胶水”。Data Agent Kit 把熟练度往上挪了一层:
| 过去卡在哪 | 现在更可能卡在哪 |
|---|---|
| 会不会写某张陌生表的 SQL | Skill 有没有把约束、口径、禁区写清楚 |
| 能不能找到正确的控制台入口 | MCP 权限是否最小、审批是否卡在正确动作上 |
| schema 怎么塞进提示词 | 轨迹是否可审计、失败能否复盘 |
三条可操作的判断:
- Skill 是新的“规范文档”,而且会真的被执行。 写糊了的 Markdown,以前只误导阅读者;现在会误导带工具权限的 Agent。治理、敏感字段、跨环境禁写,应写进 Skill,而不是写进口头习惯。
- 审批点要设在“有副作用的工具调用”上,而不是设在“生成文字”上。 产品已演示只读 SQL 前可暂停;团队应盘点:哪些 MCP 动作默认可批、哪些必须人点。
- IDE 内轨迹是最低审计面;仓内可查询轨迹是加分项。 Kit 强调编辑器里可见 MCP 调用与原始 SQL。若还要用 BigQuery 做长期评估,Google 另有 Agent Analytics 一类能力(ADK / LangGraph 插件把事件写入 BigQuery)——别和 Data Agent Kit 混成同一个产品,但方向一致:Agent 碰数据,就必须留痕。
智能路由(自动选 BigQuery 还是 Spark)听起来省事,落地时仍要问:路由决策有没有记进轨迹?选错引擎是 Agent 的锅,还是 Skill 没写清任务类型?
结论
- Data Agent Kit 卖的是工作台迁移,不是又一个 NL2SQL 演示。 MCP 解决“够得着哪些系统”,Skills 解决“按什么规程碰数据”,IDE/CLI 插件解决“人还在不在原来的编辑器里”。
- 数据岗的瓶颈会上移。 从手写跨系统 SQL,转向 Skill 设计、工具审批策略、以及“这次 Agent 到底查了什么”的可审计性。
- 预览期就要用边界清单验收。 IAM 认证要求、编排仅 GitHub Actions、人工仍须审代码——这些不是脚注,是能不能进真实项目的门槛。
如果你团队已经在 Cursor / Claude Code / Codex 里用 Agent 写数仓代码,值得问一句:现在跨 BigQuery、业务库和对象存储的排查,还要开几个浏览器标签?如果答案大于一,Data Agent Kit 这类“规程 + 连接 + 工作台”组合,就是在抢你的日常路径。