当付费客户成为模型窃取者:API 时代的能力泄露
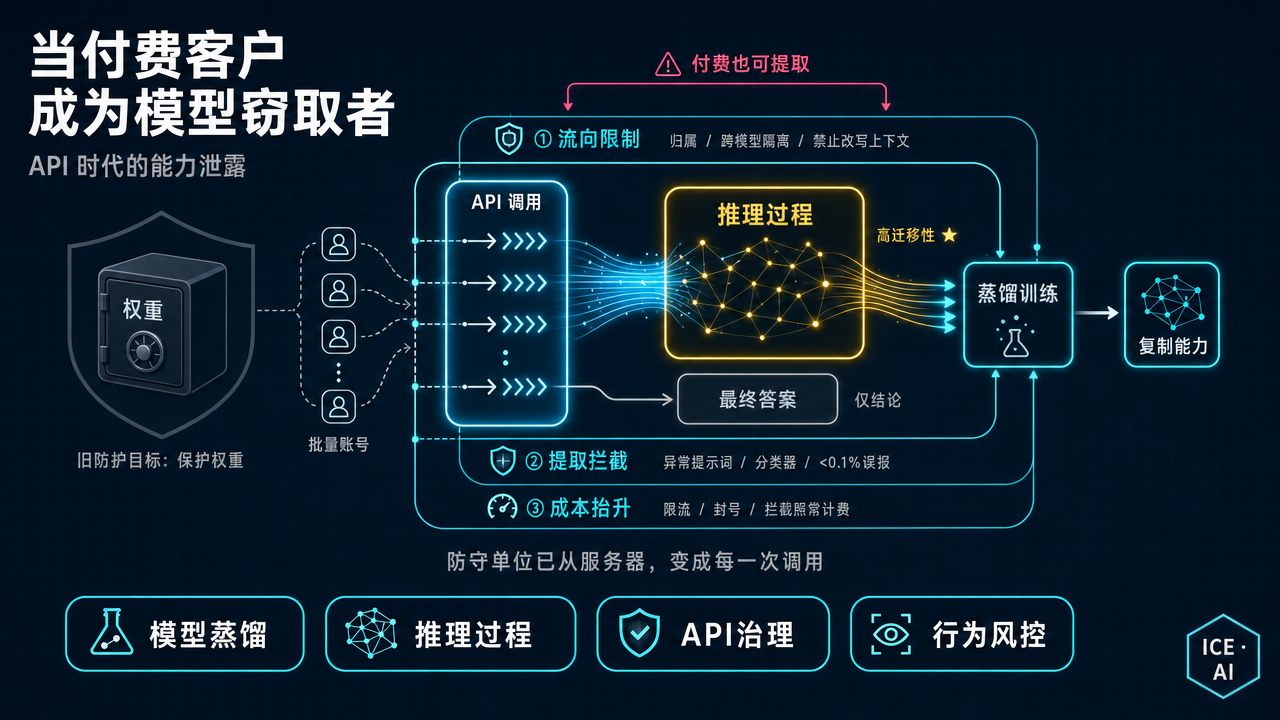
一家靠卖 Token 赚钱的公司,主动拒绝了数万亿 Token 的付费流量。
通常,付费流量意味着收入,异常流量才意味着风险。但在模型 API 里,同一笔流量可以同时具备两种身份:它表面上是正常调用,背后却可能在批量复制模型能力。
Anthropic 在 10 月 12 日公布了最新的反蒸馏进展。按它的估算,新措施让蒸馏者从 Claude 提取的推理数据减少了约 90% 到 99%。代价是放弃可观收入,并要求一部分合法开发者修改集成方式。
这件事改变了“模型被偷”的含义。过去保护模型,主要是守住服务器和权重文件。现在,攻击者无须侵入服务器,只要注册账号、付费调用、批量提问,再用收集到的回答训练自己的模型。
模型资产的边界,正在从权重扩展到模型表现出的行为,尤其是推理过程。API 不只是销售渠道,也可能成为能力外泄的通道。 防守的单位,随之从“一台服务器”缩小到“每一次调用”。
被拿走的不是权重,而是“怎么想”
蒸馏本身是一项正常技术:用大模型的输出训练小模型,让小模型以更低成本接近大模型的表现。问题不在蒸馏,而在未经授权、隐蔽采集和工业化复制。
Anthropic 所说的蒸馏攻击,是攻击者利用大量虚假账号,持续采集另一家模型的输出,把对方投入巨资训练出的能力转移到自己的模型中。
其中最有价值的数据,不只是最终答案,还有模型在回答前生成的推理记录。答案告诉学生模型“结论是什么”,推理记录还展示“怎样走到结论”。
Anthropic 给了一组对照实验:用 Claude Opus 4.8 的完整推理记录训练一个模型,它在 SWE-bench Verified 编程评测上得到 80.4%;只使用摘要化的推理记录,得分降到 71.8%。
这只是一项特定设置下的单项评测,不能说明推理记录在所有任务中都有同样的价值。但将近 9 个百分点的差距,足以解释攻击者为什么执着于提取完整推理:权重被锁在服务器里,推理记录却可能以文本形式,随着一次次正常调用流出去。
攻防怎样一步步升级
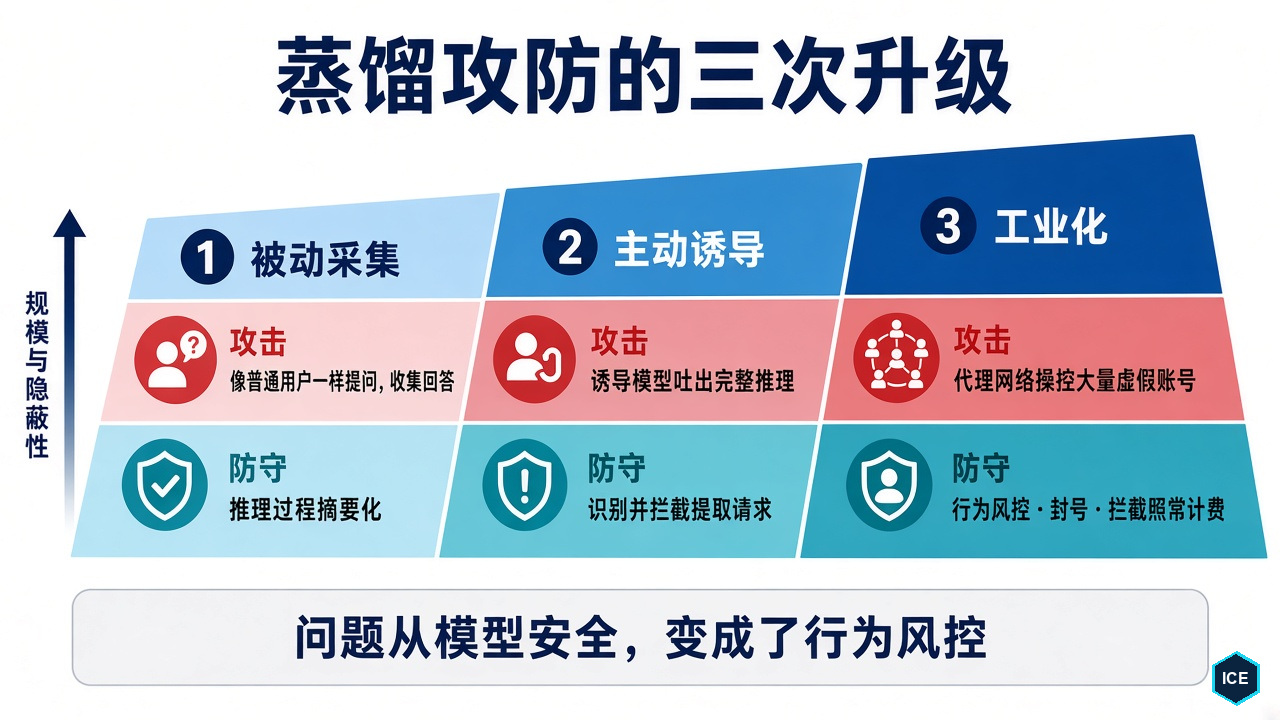
这场攻防不是一次完成的,而是沿着“采集—绕过—规模化”逐步升级。
第一阶段:被动采集。 攻击者像普通用户一样发请求,收集回答后用于训练。Anthropic 的应对,是先把 Claude 的推理过程摘要化,再展示给用户。上面的 80.4% 和 71.8%,体现的正是完整推理与摘要推理之间的差距。
第二阶段:主动诱导。 摘要化之后,攻击者开始诱导模型吐出完整推理。手法从“逐字输出之前的推理”,发展到自动化批量试探。按 Anthropic 的描述,有一家实验室测试了 1.2 万种请求写法。
第三阶段:工业化。 早期规则被绕过后,攻击者开始用代理网络控制大量虚假账号,把请求分散出去,躲避单账号检测。这些网络还会在 Claude 未开放的地区转售访问权限,用虚假身份和盗来的支付信息注册。Anthropic 此前披露过,其中一个网络同时管理着 2 万多个虚假账号。
到了第三阶段,问题的性质已经改变:它不再只是模型安全问题,而变成了与反欺诈、反爬虫、反刷单相似的行为风控问题。攻击者付得起钱、换得起身份,还会不断试探规则边界。
三道新防线
针对这条攻击链,Anthropic 把防线布在三个位置:限制流动、识别提取、提高成本。
第一层:控制推理能流向哪里。 攻击者常用的手法,是把受保护的推理内容挪到别处:挪到另一段对话里,让模型以为对方已经看过完整推理;挪给防护更弱的旧模型去读;或者在账号被封之后,换一个账号接着试。
为此,2026 年 8 月 31 日及之后注册的 API 账号,不能再编辑 Claude 之前的上下文;新模型的推理内容,不能被防护较弱的旧模型读取;Claude Sonnet 5.5 的推理记录,也只有发出请求的组织可以访问。
这很像数据治理:推理过程被视为有归属、受流向限制的数据资产。谁产生、谁可见、可以流向哪里,都有明确规则。
第二层:拦截提取请求。 普通用户很少要求模型写出完整的隐藏推理,这让识别成为可能。Anthropic 构建了一套两阶段分类器,用蒸馏者的真实请求做内部和外部红队测试,并修补发现的漏洞。按它的说法,这套防护的稳健程度,已经和防止 Claude 协助制造生物武器的防护相当,误报率低于 0.1%。
规则也在持续更新。攻击者曾要求模型把推理翻译成另一种语言,或者放进特定标签里随答案输出;这些新手法被发现后,又会成为下一轮规则补丁。
第三层:抬高重复尝试的成本。 反复提取推理的账号会受到更严格的用量限制,持续尝试则直接封号。Anthropic 称已封禁数万个相关账号,很多账号在蒸馏活动开始后两小时内就被处理。
从 9 月 24 日起,在误报率低于 0.1% 的特定领域,包括蒸馏,被拦截的请求也照常计费。这一步很关键:如果每次试错都免费,攻击者就可以无限逼近规则边界;持续计费,则把绕过过程变成一项不断烧钱的实验。
三层叠加之后,在 Anthropic 自己的平台上,蒸馏者能提取的推理 Token 数量降到原来的十分之一至百分之一,有些天甚至少到无法测量。
防护不是免费的
效果之外,更值得注意的是 Anthropic 对代价的承认。
今年 2 月,它曾提出在“不影响合法用户”的前提下防蒸馏。现在它明确表示,这个目标没有完全实现:
- 新的上下文规则,迫使部分开发者修改集成方式;
- 分类器仍会以不到 0.1% 的概率误拦正常请求;
- 即使请求被误拦,用户也可能照常付费。
Anthropic 也不知道当前效果能维持多久。蒸馏会是一场长期的猫鼠游戏,而它自己承认,尚未遇到过一次“高度复杂且持续”的绕过尝试。
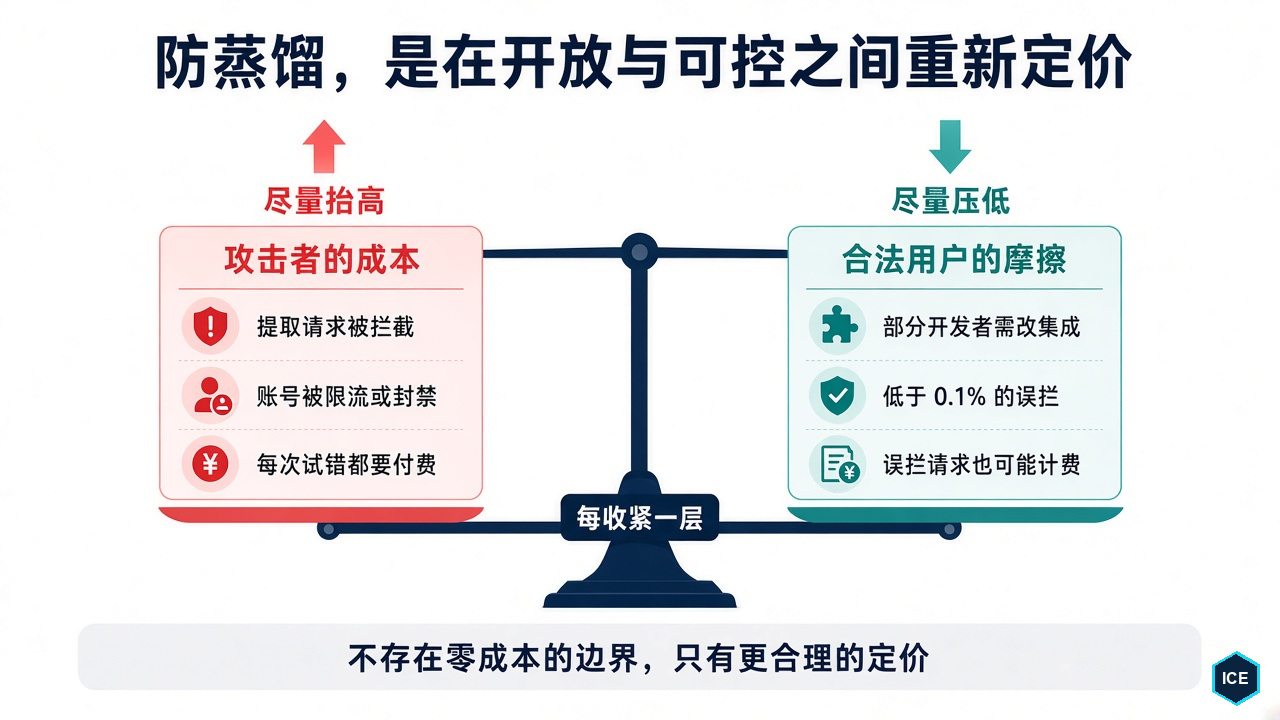
所以,防蒸馏并不是找到一条零成本的边界,而是在开放与可控之间重新定价。每收紧一层,攻击者的成本会上升,合法用户也会承担更多摩擦。真正的目标,是让前者高到难以承受,同时让后者低到仍可接受。
为什么这是一个行业问题
Anthropic 把防蒸馏与生物安全、网络安全和国家安全联系在一起,并点名指控智谱和月之暗面存在相关行为。这里需要保持审慎:这些是 Anthropic 的单方面说法,外界目前无法独立核实,叙事中也有明确的地缘政治立场。
但抛开具体指控,一个结构性判断仍然成立:防蒸馏只靠一家模型公司做不成。
蒸馏者会把流量分散到模型厂商自己的 API、第三方云平台和各类推理服务商。只要其中一个环节防护薄弱,其他环节的投入就会被抵消。这和支付行业很像:一家银行风控做得再好,如果别家银行放任盗刷,资金还是会从最薄弱的地方流出去。
真正困难的是激励。防护需要持续投入,而蒸馏者也在付费。对平台来说,识别并拒绝这些流量,意味着主动放弃收入;什么都不做,短期财务表现反而更好。
这也是 Anthropic 公开方法的另一层含义:它不仅在展示防御效果,也在试图把“平台应该识别并拒绝蒸馏流量”变成行业的默认责任。
这对模型之外的人意味着什么
这件事表面上只关乎头部模型厂商,但它揭示的问题会扩散得更广。
第一,任何把能力封装成接口的组织,都面临类似风险。 如果企业把资深专家的经验做成智能体,再对客户或合作伙伴开放,别人同样可以批量提问、系统收集回答,逐步复制其中的能力。能力一旦变成服务,每一次回答都是一次小规模的授权。
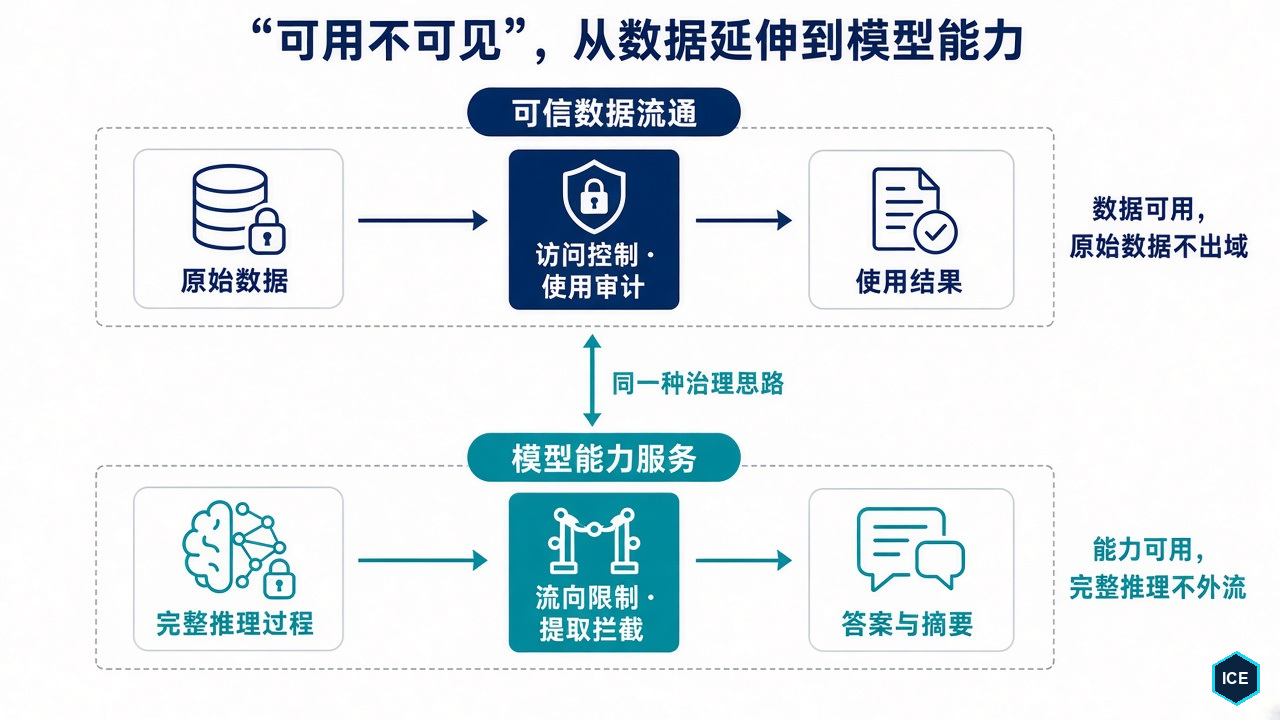
第二,“可用不可见”正在从数据延伸到模型能力。 可信数据流通强调:允许使用数据,但不交出原始数据。反蒸馏追求的是类似目标:允许调用模型能力,但不交出完整推理过程。访问控制、使用审计、流向限制,这些数据治理方法正在进入模型服务。
第三,可见性和安全之间会形成新的张力。 开发者需要推理过程来调试,企业希望用它审计和追责,反蒸馏却要求尽量少暴露。Anthropic 的折中办法,是按主体限制可见性:推理记录只对产生它的组织开放。
这可能成为一种通行设计,也意味着依赖完整推理轨迹的调试、评测和审计工具,需要适应更有限、更有边界的可见性。
结语
当能力可以通过回答被复制,每一次回答就不只是一笔交易,也是一次授权。
模型厂商正在面对银行和支付行业早已熟悉的问题:开放接口需要身份核验、行为风控、成本约束和行业协作。区别在于,这次被保护的不是钱,而是模型“怎么想”。
如果你的团队正在把经验和能力封装成对外的智能体或接口,你想过它会被怎样“问”走吗?
参考资料
- Anthropic,《Strengthening our defenses against distillation attacks》,2026-10-12 — https://www.anthropic.com/research/distillation-defenses
本文部分内容由 AI 辅助生成,经人工审校和补充后发布。