DataSpace 最高只有 66.34 分:企业分析真正难的不是 SQL
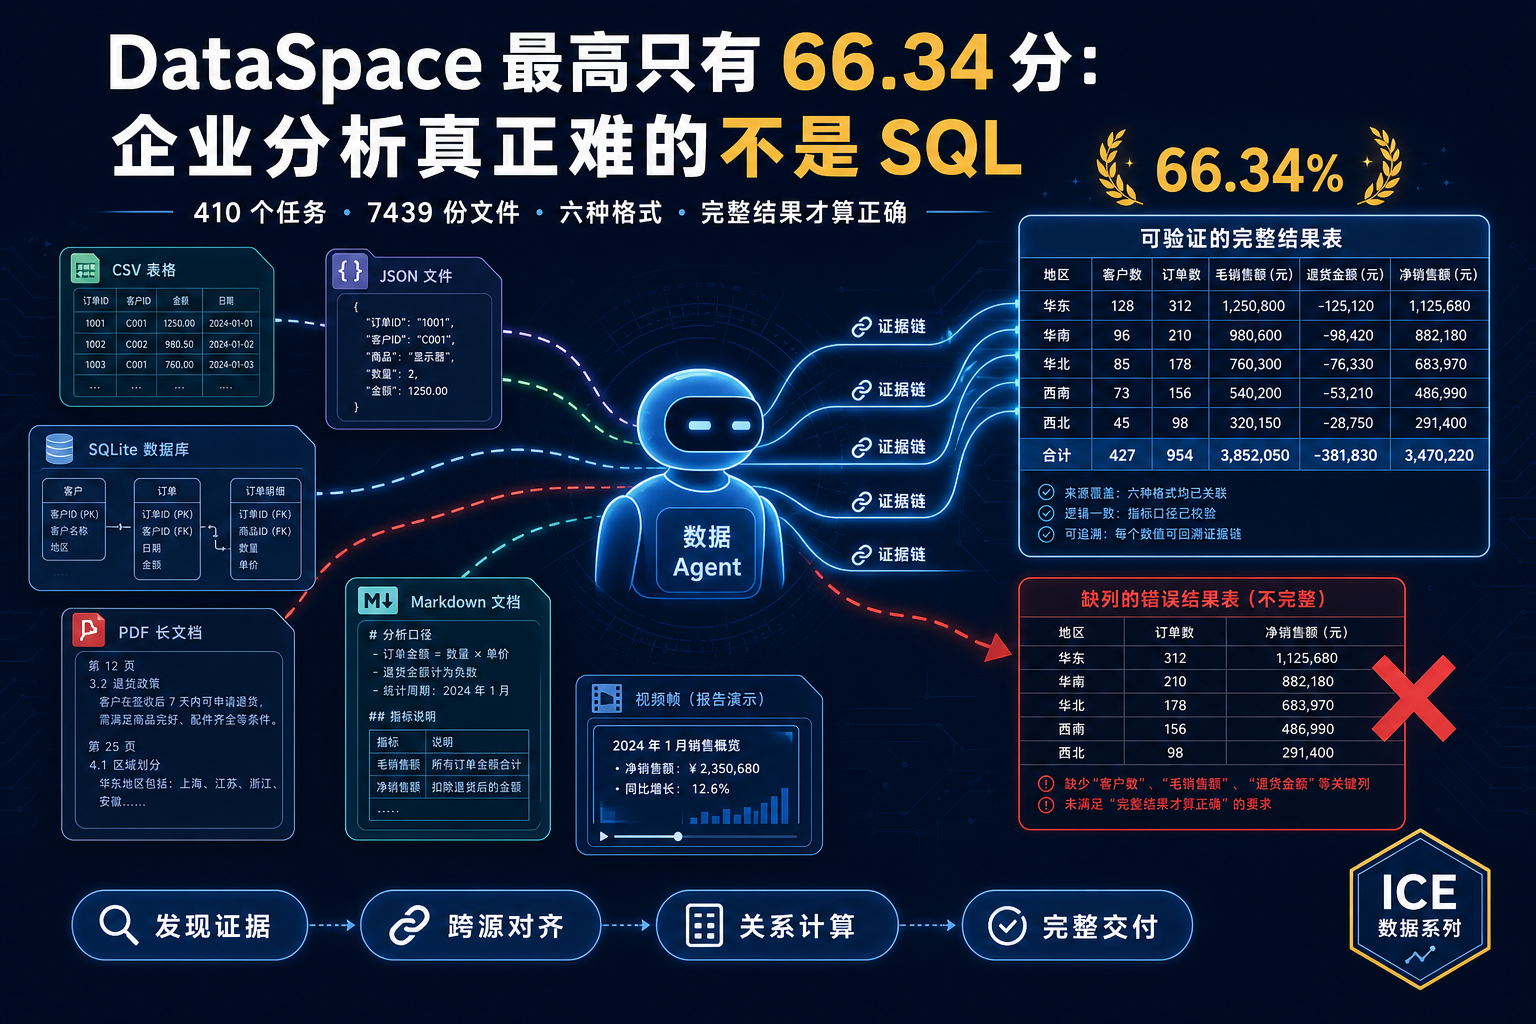
一项基金风险分析,需要从视频里读取预警规则,从长 PDF 中提取同类基金基准,再到 SQLite 查询每日净值,最后对齐基金名称、计算指标并输出完整名单。
这不是一个复杂 SQL 能解决的问题。
SQL 只负责其中一段。Agent 还要先找到正确文件,理解视频和文档,把不同来源中的实体、单位和时间对齐,完成跨源 Join,最后交付一张列、行和精度都符合要求的表。
DataSpace 把这类任务做成了 410 道可验证测试。在同一套 Agent 设计下,表现最好的 Grok 4.5 完整答对 272 道,准确率 66.34%。
真正值得注意的不是还有三分之一没做对,而是失败发生在哪里:很多时候,Agent 已经找到证据、算出中间结果,却没有把最终表交对。
一、企业数据分析不是在一张表里找答案
传统 NL2SQL 评测通常提前指定数据库。模型的主要任务,是把问题转换成可执行 SQL。
真实企业工作区没有这么整齐。指标可能在数据库里,业务规则写在 PDF,补充条件出现在会议视频,映射关系藏在 JSON,旁边还有大量合法但与当前问题无关的文件。
DataSpace 因此没有给 Agent 一份预选 schema,而是提供一个任务工作区:
| 项目 | DataSpace 设置 |
|---|---|
| 任务数 | 410 |
| 文件数 | 7439 |
| 总体积 | 15.01 GB |
| 格式 | CSV、JSON、SQLite、Markdown、PDF、视频 |
| 格式组合 | 13 种 |
| 语言 | 中文、英文及跨语言组合 |
| 业务领域 | 金融、宏观经济、医疗 |
其中包含 2809 个 CSV、1927 个 JSON、402 个 SQLite 数据库、1024 篇 Markdown、1088 份 PDF 和 189 个视频。
Agent 只拿到自然语言问题和工作区根目录。它必须自己完成四件事:
- 发现哪些文件包含所需证据;
- 对齐实体、字段、单位、语言和时间;
- 执行过滤、Join、聚合、排序与时序计算;
- 输出用户要求的完整结果表。

这也是 DataSpace 最有价值的定义:Data Agent 不是 SQL 生成器,而是 Workspace Solver。
二、66.34 分到底怎么计算
DataSpace 的 66.34 不是 LLM 裁判给出的主观分数,而是 Task Accuracy:410 个任务中,有多少最终结果表完整匹配标准答案。
评测器允许无关紧要的表达差异:
- 列名可以不同;
- 列顺序可以不同;
- 数值按照指定类型和精度比较;
- 单位和行顺序按任务配置处理。
但它不接受不完整答案。少一行、多一列、粒度错误或漏掉部分记录,整道任务都算失败。一个数字正确不等于完成分析,完整结果集合才是交付物。
在固定 DataSpace-Agent 的情况下,六个模型结果如下:
| 模型 | 答对任务 | Task Accuracy |
|---|---|---|
| Grok 4.5 | 272 | 66.34% |
| GPT-5.6 Sol | 265 | 64.63% |
| Kimi K3 | 219 | 53.41% |
| MiMo-V2.5 | 161 | 39.27% |
| Claude Sonnet 5 | 135 | 32.93% |
| MiniMax M3 | 117 | 28.54% |
六个模型共同答对 56 道题,共同失败 76 道。把六个模型各自做对的题合并,最多可以覆盖 334 道,也就是 81.46%。这说明失败既有共同硬点,也有明显的模型互补。
执行框架同样会改变结果。固定 MiMo-V2.5 后,Grok Build 得到 46.34%,Smolagents 只有 30.98%,相差 15.36 个百分点。模型决定上限,harness 决定 Agent 能否把能力稳定转化为结果。
三、最难的不是读 PDF,而是跨源 Join
多模态通常被理解成“模型能不能看懂 PDF 和视频”。DataSpace 给出的结果更具体。
与单一格式任务相比,多格式任务让所有六个模型下降 1.8—14.0 个百分点。但某种格式是否出现,并没有一致影响:视频对部分模型有帮助,对另一些模型有害;文档也不是所有模型的共同短板。
真正稳定的难点是整合。需要 Join 的任务让六个模型全部下降,幅度达到 9.7—19.8 个百分点。
原因并不神秘。跨源 Join 需要 Agent 同时解决:
- “华东区”和
east_region是否为同一实体; - PDF 中的“净值”与数据库的
nav是否同一指标; - 视频中的阈值适用于哪一版数据;
- 百分比、万元和原始数值是否需要换算;
- 两个文件的时间粒度能否直接连接。
单个文件读对,只是取得一块证据。只有实体、语义、单位与时间同时对齐,证据才能进入同一张结果表。
这意味着企业 Data Agent 的主要基础设施不会只是向量检索和 SQL 工具。它还需要语义层、实体解析、单位系统、版本信息和可执行的 Join 规则。
四、最大失败发生在最后一公里
论文人工审查了最强组合 Grok 4.5 的 136 个失败轨迹。
结果与“模型找不到数据”的直觉不同:
| 主要失败来源 | 数量 | 占受审失败比例 |
|---|---|---|
| 结果物化 | 71 | 52.2% |
| 任务意图与输出定义 | 31 | 22.8% |
| 提取与语义对齐 | 21 | 15.4% |
| 选错证据源 | 3 | 2.2% |
60 个物化失败发生在所需中间结果已经存在之后:Agent 最后漏掉一列、加入多余列,或者没有按要求投影结果。另有 17 个失败来自一开始就误解了输出结构或行粒度。两类合计占受审失败的 56.6%。
这揭示了 Data Agent 与聊天机器人的根本差别。
聊天回答可以给出几个关键数字,再补一句解释;数据分析任务要求交付一个有明确 schema、grain 和 completeness 的结果集。用户要“全部符合条件的客户”,返回五个示例不是部分正确,而是没有完成任务。
因此,输出契约不能留到 Agent 最后自由发挥。任务开始时就应明确:
- 每一行代表什么;
- 必须包含哪些列;
- 单位、精度和空值如何处理;
- 是否允许重复;
- 排序是否具有业务含义;
- 如何证明结果没有漏项。
先定义结果表,再规划证据和计算路径。 这比生成结束后检查 CSV 格式更重要。
五、企业需要重做 Data Agent 的评测方式
如果评测仍然只问“SQL 能不能执行”或“回答看起来是否合理”,就会掩盖真正的生产失败。
一套可上线的 Data Agent 评测至少要覆盖四层:
发现层。 Agent 是否找全相关来源,并排除同目录中的干扰文件。
对齐层。 实体、指标、单位、语言和版本是否统一,Join 是否建立在正确键上。
计算层。 过滤、聚合、排序和时序逻辑能否由代码或查询复算。
交付层。 最终结果是否满足 schema、行粒度、完整性和精度契约。
最后一层必须尽量使用确定性评测。DataSpace 的做法值得借鉴:不是让另一个模型判断报告“像不像正确答案”,而是把输出规范化后逐列、逐行比较。
对于企业内部评测,标准答案也不应该只有一段自然语言。应同时保存:
- 冻结的数据快照;
- 预期结果表;
- 列语义和数值精度;
- 行顺序与去重规则;
- 生成结果所依据的可执行查询或代码。
这样才能判断一次失败究竟发生在检索、对齐、计算还是交付,而不是统一归结为“模型幻觉”。
DataSpace 由 EHRSQL 和 BULL 转换而来,并由 11 名专家复核,因此 66.34% 不是所有生产系统的统一上限。但受控工作区已经让最好组合丢掉三分之一任务,真实企业还会增加权限、版本漂移、脏数据和系统延迟。企业不能再用“模型会写 SQL”推导“模型会做数据分析”。
结论
DataSpace 把数据分析拆回了它原本的样子:不是从一张干净表里生成查询,而是在混乱工作区中找到证据、建立关系、完成计算并交付完整结果。
66.34% 暴露的最大问题也不是某个模型不够聪明,而是当前 Data Agent 仍容易在完整链路中丢失信息。它可能读对 PDF、查对数据库、算对数字,却在最后一张表里漏掉一列。
所以,企业建设 Data Agent 时,真正应该问的不是:
它能不能回答这个问题?
而是:
它能不能把全部证据变成一份可以复算、可以核对、可以直接交付的结果?
参考资料
- Boyan Li 等,《DataSpace: Benchmarking Data Agents for Verifiable Analytics over Heterogeneous Workspaces》,arXiv:2608.03451,2026 年 8 月。https://arxiv.org/html/2608.03451
- HKUSTDial,《DataSpace》项目仓库。https://github.com/HKUSTDial/DataSpace
- DataSpace,《Data Agent Leaderboard》。https://dataspace-bench.github.io/
- HKUSTDial,《DataSpace Dataset》。https://huggingface.co/datasets/HKUSTDial/DataSpace
- KDD Cup 2026,《Data Agents for Complex Data Analysis》。https://dataagent.top/
本文部分内容由 AI 辅助生成,经人工审校和补充后发布。