人类数据正在成为稀缺资源
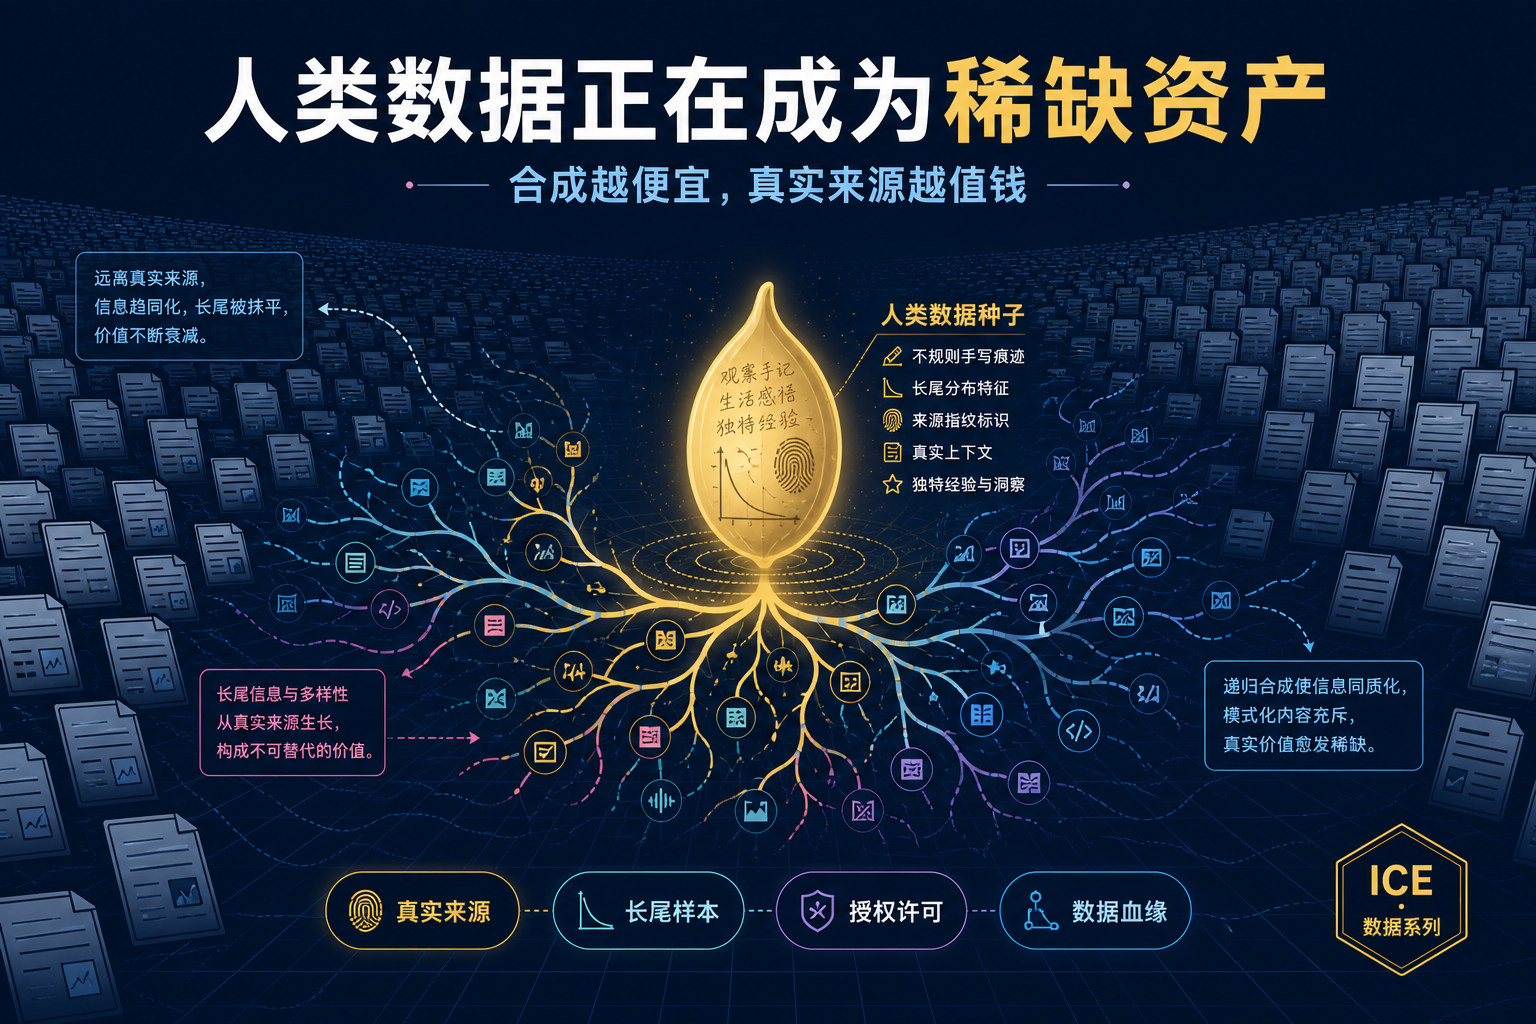
互联网上的文字和图片从未如此充裕,但适合训练下一代模型的数据,可能正在变少。
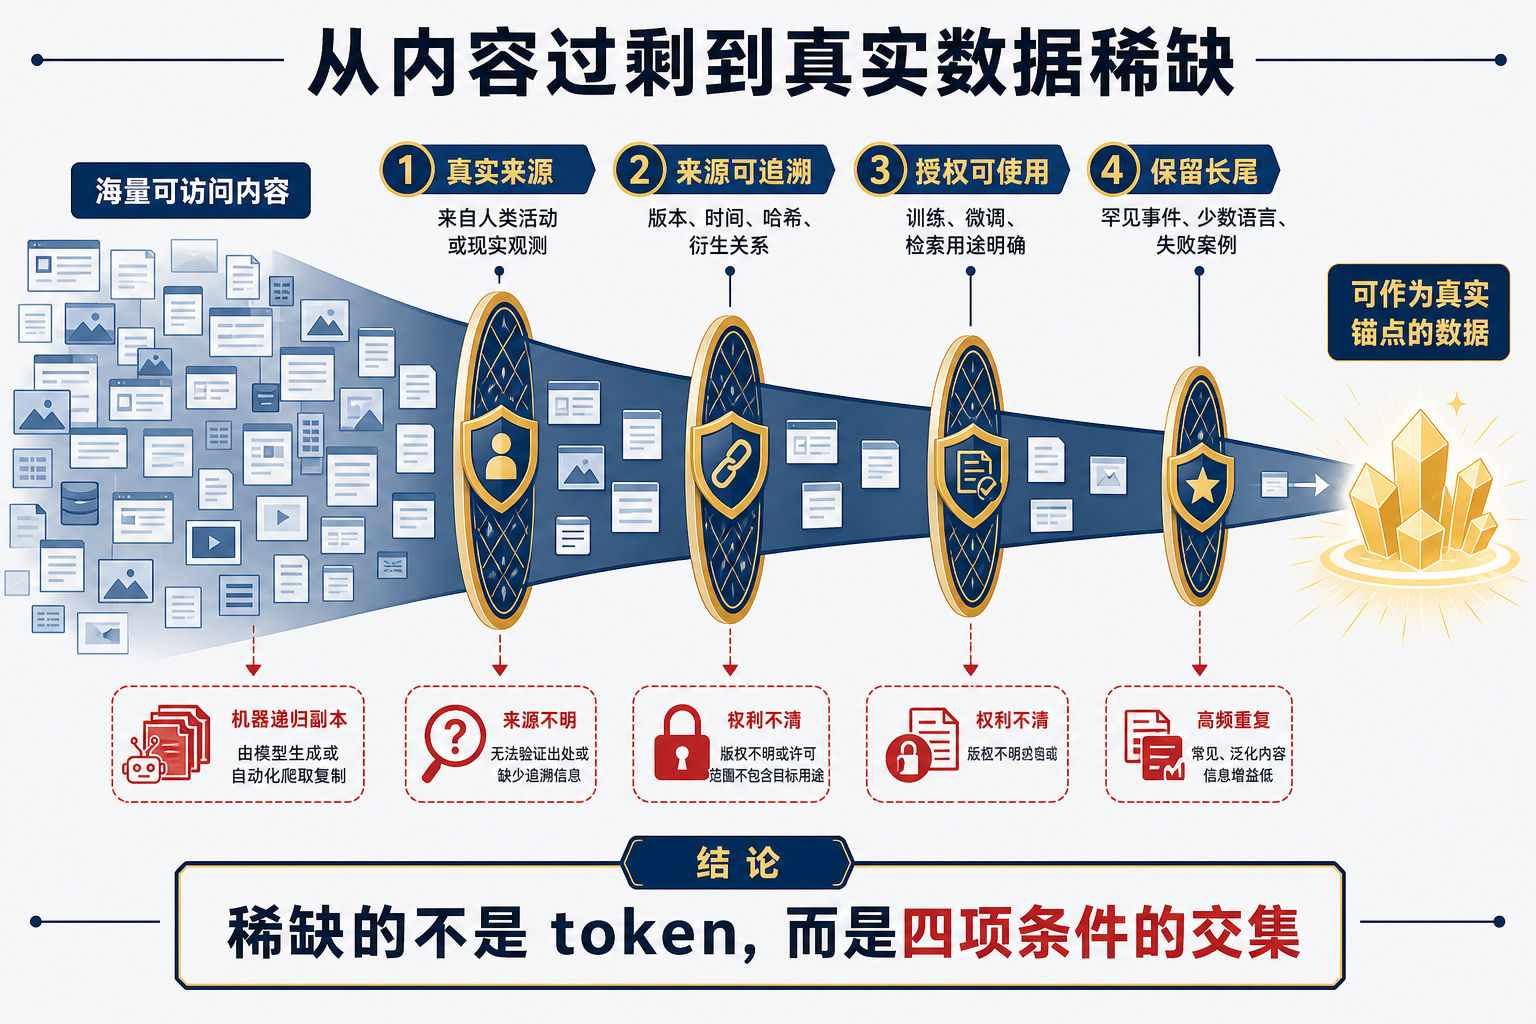
这里的“变少”不是网页数量下降,而是四种条件越来越难同时满足:内容由真实的人或现实过程产生,来源与版本可追溯,使用权明确,并且没有被上一代模型的输出大面积污染。缺少其中任何一项,数据都还可以被下载,却未必还能被安全地放进训练集。
另一边,合成数据正在快速成熟。它能批量制造数学题、代码、分类样本和边缘案例,微软在 Phi-4 中生成了约 4000 亿个未加权合成 token;NVIDIA 的一条金融数据管线生成了 50 多万条去重后的标题。看起来,人类数据的短缺似乎可以用机器数据补上。
但这些实践给出的答案恰恰相反:合成数据越强,人类数据越像一种不可替代的母本。 它不再负责提供全部训练量,而是负责提供真实分布、长尾事件、生成种子和最终评价尺度。AI 能够放大这份母本,却不能凭空恢复母本里已经丢失的信息。
一、稀缺的不是 token,而是可用的真实来源
理解这场变化,首先要把“网上有多少内容”和“模型能合法、可靠地使用多少内容”分开。
Data Provenance Initiative 在 NeurIPS 2024 发表的研究审计了 1.4 万个训练语料来源域名,并纵向比较它们在 2023—2024 年间的 robots.txt 和服务条款。结果不是整个互联网突然关门,而是优质、活跃和持续更新的来源率先收紧:
| 信号 | 研究结果 |
|---|---|
| C4 中被 robots.txt 完全限制的 token | 5% 以上 |
| C4 中最活跃关键来源被完全限制的比例 | 28% 以上 |
| C4 中受到网站服务条款限制的 token | 45% |
| C4、RefinedWeb、Dolma 的条款限制相对增幅 | 26%—53% |
robots.txt 只是机器可读的意愿表达,服务条款也不等于技术上无法抓取。因此,这些数字不能直接解释为“45% 的 C4 已经不可用”。它们说明的是另一件事:过去可以被默认当作公共原料的网页,现在附带了越来越多不同、甚至互相矛盾的使用条件。
这种收缩还有明显的选择偏差。研究团队发现,新闻、评论、论坛和社交内容等新鲜、高质量来源限制得更快;更少设置限制的剩余网页,可能更旧、更杂,也更缺乏持续维护。如果模型只尊重可见的拒绝信号,它获得的并不是原数据集的一个随机子集,而是一个分布已经发生偏移的子集。
到 2026 年,访问限制开始从声明变成市场。Cloudflare 公布的网络数据显示,用于 AI 训练的请求占可识别爬虫请求的比例,从 2025 年春季的 22% 增至 2026 年 6 月的 52%;搜索、agent 和训练混用的爬虫又占 36% 以上。该公司同时称,2023 年以来出版商与 AI 企业已签署超过 50 份重要内容协议。
这些是基础设施厂商基于自身网络得出的数据,不代表完整互联网,也带有推动其内容计费产品的商业立场。但趋势足够清楚:训练数据供给正从“能抓就抓”转向按来源、用途和授权关系分层。 大公司可以购买内容,小团队和学术机构却未必承担得起同样的许可成本。数据收紧不只可能保护创作者,也可能提高新模型进入市场的门槛。
二、合成数据确实有用,但它不是无中生有
如果只讲模型坍塌,很容易把合成数据说成一种有害杂质。事实不是这样。合成数据已经证明,它在目标明确、结果可验证的任务上可以比原始网页更高效。
Phi-4 是一个有代表性的案例。它只有 140 亿参数,架构相对 Phi-3 没有大改,但在多个推理任务上达到或超过更大的模型。其技术报告明确说,合成数据构成训练数据的主体:团队设计了 50 类生成管线,使用多阶段提示、自我修订、指令反转和执行验证,累计产生约 4000 亿个未加权 token。
真正值得注意的不是“4000 亿”,而是这些 token 从哪里开始。Phi-4 团队先从网页、授权图书、论文、教育论坛和代码仓库中筛选真实材料,再把它们转化为练习、讨论和推理链。技术报告还给出了两个不那么适合营销的结论:
- 真实问题明显比合成问题更有效;
- 少量错误会在衍生的合成文档中造成严重质量退化,因此干净、正确的自然数据对生成种子“绝对关键”。
也就是说,Phi-4 展示的不是机器数据替代人类数据,而是高质量人类材料经过结构化放大以后,提高了每个训练 token 的教学密度。合成数据承担的是编排和扩展,知识边界与真实性仍然来自种子。
NVIDIA 2026 年公布的金融标题实验提供了另一种观察。团队想生成 50 万条覆盖 13 类事件的标题,第一次直接生成 5 万条时,有 65% 被语义去重判为近似重复,只留下 17348 条。最后的生产管线经历 82 轮“生成—过滤—全局去重—选择最远样本—修正类别权重”,在一台八卡 B200 节点上运行约 6 天,才得到 502536 条唯一标题。
| 公开案例 | 合成规模 | 被忽略时最容易失败的环节 |
|---|---|---|
| Phi-4 | 约 4000 亿未加权 token、50 类管线 | 真实种子质量、任务多样性、可执行验证 |
| 金融标题管线 | 502536 条、82 轮、约 6 天 | 近似重复、类别失衡、稀有事件覆盖 |
| ForTIFAI | 可容忍合成数据量提高 2.3 倍以上 | 递归训练中的高置信度合成模式 |
单次批量生成很容易得到大量措辞不同、语义相似的样本。把数量变成覆盖度,需要持续与已有语料比较,并主动寻找分布中尚未覆盖的位置。生成的边际成本很低,证明新增样本确实增加了信息的成本并不低。
三、模型坍塌首先丢掉的是长尾
人类数据为什么不能被彻底替代,核心原因不在于“人写得更自然”,而在于生成模型只能从自己已经学到的分布中采样。
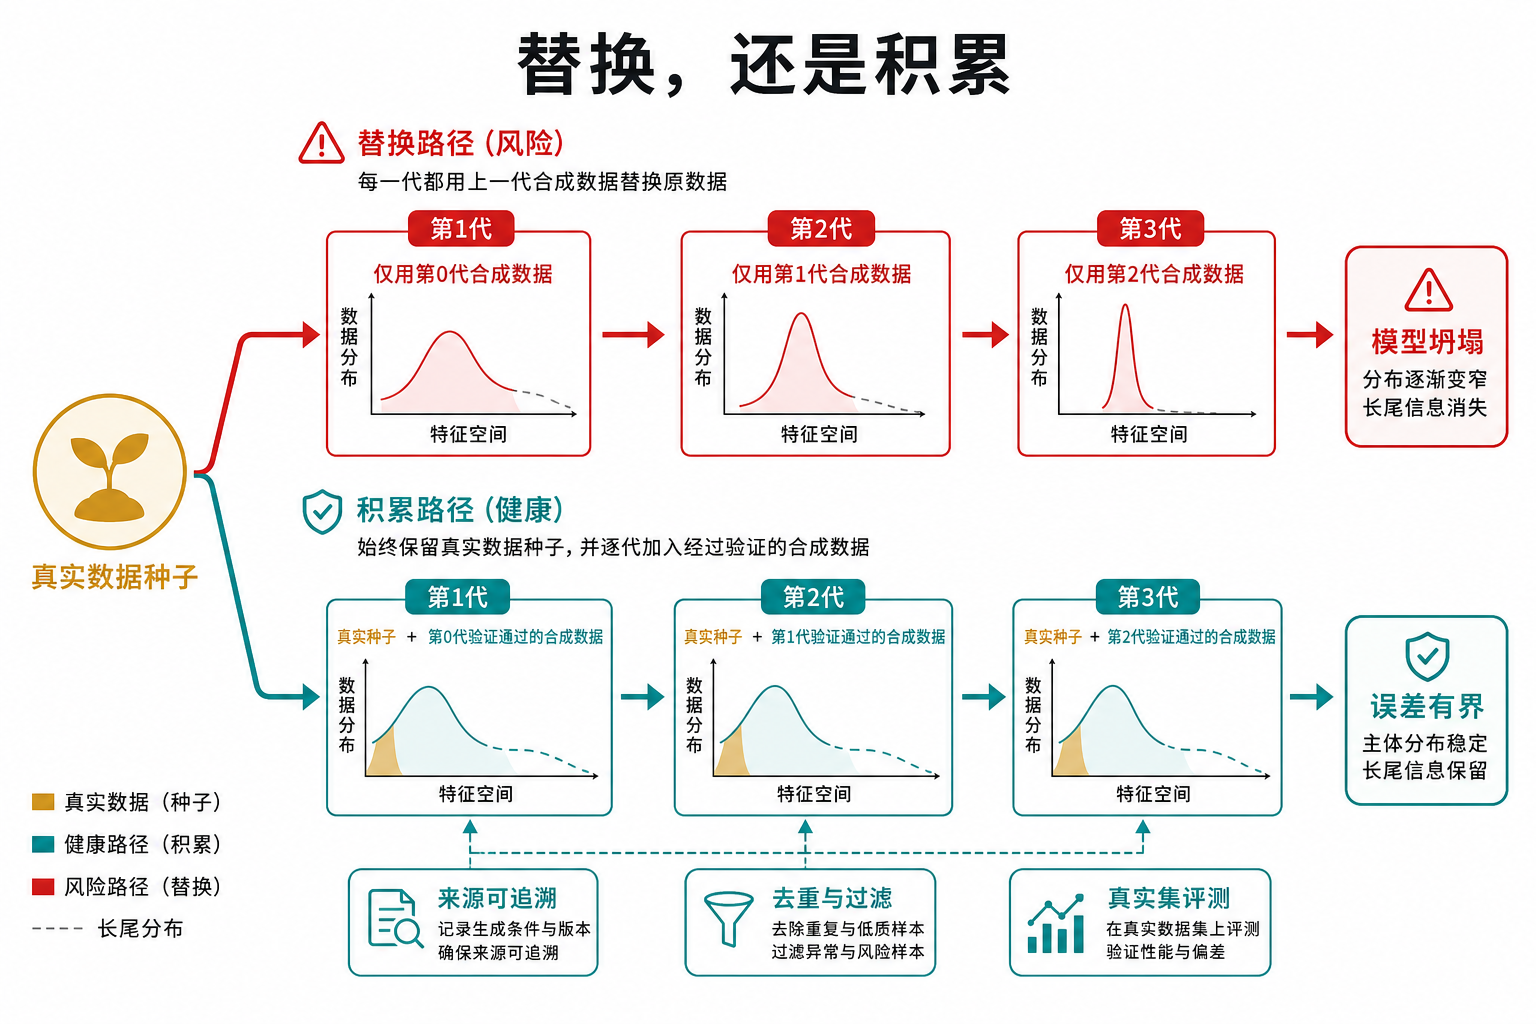
2024 年发表于 Nature 的模型坍塌研究,把问题设为连续多代训练:后一代模型使用前一代生成的数据。研究覆盖高斯混合模型、变分自编码器和语言模型,观察到低概率事件最先消失,随后分布方差继续收缩。研究者把前者称为早期坍塌,把最终与真实分布相去甚远的状态称为晚期坍塌。
长尾消失并不神秘。假设一种事件在真实世界中的概率低到有限样本里平均不到一次,那么某一代没有采到它并不奇怪。一旦这一代把它漏掉,下一代就没有来源可以重新学回这个事件。递归多次以后,常见模式不断自我复制,罕见但有效的模式逐渐退出训练集。
不过,“使用合成数据必然坍塌”也说得太满。后续研究区分了两种完全不同的数据策略:
- 替换:每一代丢掉旧数据,只用上一代模型的输出训练;
- 积累:保留原始数据,并把新一代合成数据加入已有集合。
在语言、图像和分子构象实验中,替换路径的测试误差随代数上升;积累路径则能让误差保持有界或显著放慢退化。研究者同时提醒,不同架构和数据设置下仍有相反结果,积累不是无条件保证。
2026 年 7 月发表的 ForTIFAI 又给出一种缓解方法。作者发现自回归模型倾向于为自己生成的模式赋予较高置信度,于是通过置信度感知损失降低这类 token 的训练权重。实验中,模型在出现坍塌前可容忍的合成数据量提高了 2.3 倍以上。
这个结果应该按原意理解:2.3 倍意味着坍塌被推迟,不意味着真实数据已经不再需要。过滤器仍然要判断哪些模式值得降低权重,而模型最终是否退化,也仍需在独立、真实的数据上评价。
四、人类数据的价值正在从“产量”转向“锚点”
过去衡量训练数据,最显眼的指标是 token 数量。进入合成数据时代以后,数量仍然重要,但已经不足以描述一份数据的价值。
一份可充当“真实锚点”的数据,至少要回答四个问题。
它是不是来自现实。 这里不只包括人写的文章,还包括真实交易、设备观测、实验记录、用户行为和经过人工确认的任务结果。关键不是作者一定是人,而是数据与模型自身输出之间存在独立来源。
它来自哪个版本。 同一篇文档可能被转载、改写、机器翻译或模型润色。只记录 URL 无法证明训练时使用的是哪份内容,需要保存抓取时间、内容哈希、处理步骤和衍生关系。
它能否被使用。 “公开可访问”不等于“允许用于训练”。训练、微调、检索和结果展示可能对应不同权利。一份无法说明许可范围的数据,即使质量很高,也会把法律不确定性带进模型资产。
它保留了什么长尾。 高频样本可以由模型批量生成,真正难补的是失败案例、少数语言、罕见事件、非主流表达和反常结果。这些样本数量少,却决定模型能否看见平均值之外的世界。
因此,人类数据的稀缺不是一种简单的“数据枯竭”。互联网上仍会有海量人类内容,企业内部也持续产生业务记录。稀缺发生在交集里:真实、优质、新鲜、获准使用、可追溯,并且覆盖模型尚未掌握的分布。
这也解释了为什么数据血缘会从后台治理能力变成数据定价能力。如果购买方无法确认一份语料是原始内容还是经过多代生成的副本,就无法判断自己买到的是新信息,还是已有模型分布的又一次采样。
五、企业需要建立“真实数据储备”
面对这种稀缺性,正确策略不是拒绝合成数据,而是重新设计真实数据和合成数据之间的分工。
第一,把原始数据视为不可覆盖的母本。 原始记录、人工标注和经过验证的失败案例应当版本化保存。清洗可以产生新版本,但不能只留下处理后的结果。模型坍塌研究中,“替换”和“积累”的差别,落到工程上就是能否回到真实来源。
第二,给每条合成数据保留生成血缘。 至少记录种子、生成模型、提示模板、采样参数、验证器、过滤原因和生成时间。没有这些信息,团队无法在模型升级后判断旧样本是否需要重做,也无法追查一个错误是来自真实种子、生成器还是过滤器。
第三,把真实评测集从训练循环中隔离。 合成训练数据可以持续扩张,判定它是否有效的尺子却不能跟着一起合成。保留不参与生成提示、不反馈给训练管线的真实数据集,才能判断模型究竟学到了新能力,还是只学会了生成器偏好的表达。
第四,按信息增量采购数据,而不是按字节采购。 对一份新数据,最有价值的问题不是“有多少 token”,而是它增加了哪些此前缺失的领域、事件和表达方式。重复网页的存储量很大,信息增量可能接近零;一小批真实事故记录的体量很小,却可能覆盖模型从未见过的失效路径。
第五,把使用权拆到具体用途。 训练基础模型、内部微调、RAG 检索和向终端用户展示原文,不应被一个模糊的“AI 使用权”覆盖。用途级许可不仅降低合规风险,也使内容所有者能够对不同价值链环节分别定价。
这套做法会改变数据团队的工作重点。未来最有价值的资产不一定是最大的语料湖,而可能是一套能够证明来源、许可、版本和真实分布覆盖度的数据储备。生成模型负责扩大样本,数据工程负责确保扩大过程中没有把现实本身冲淡。
结论
现有证据支持四个判断:
- 开放网页没有消失,但高质量训练来源正在主动收紧。 C4 中 28% 以上最活跃关键来源已通过 robots.txt 完全限制抓取,条款限制覆盖的 token 更多。
- 合成数据已经成为有效的训练工具,但成功案例都不是无源生成。 Phi-4 依赖高质量真实种子,金融数据管线依赖多轮去重、平衡与筛选。
- 递归训练的风险不等于“碰到合成数据就坍塌”。 替换真实数据会使长尾逐代消失;保留真实数据并积累、验证合成数据,可以让误差保持有界或显著延缓退化。
- 真正稀缺的是可证明的真实性。 数据的来源、版本、许可和长尾覆盖,会比单纯 token 数量更能决定它的训练价值。
过去,真实数据是训练集的主体,合成数据只是补充。未来两者的位置可能反过来:合成数据提供大部分数量,真实数据负责定义边界、校准方向和判定结果。
当机器可以无限生产看起来正确的数据时,你的组织是否还保存着一份能够证明“现实原本是什么样”的母本?
参考资料
- Ilia Shumailov 等,《AI models collapse when trained on recursively generated data》,Nature,2024 年 7 月。https://www.nature.com/articles/s41586-024-07566-y
- Elvis Dohmatob 等,《Is Model Collapse Inevitable? Breaking the Curse of Recursion by Accumulating Real and Synthetic Data》,ICLR 2025。https://arxiv.org/html/2404.01413v2
- Soheil Zibakhsh Shabgahi 等,《ForTIFAI: fending off recursive training induced failure for AI model collapse》,npj Artificial Intelligence,2026 年 7 月 4 日。https://www.nature.com/articles/s44387-026-00127-w
- Shayne Longpre 等,《Consent in Crisis: The Rapid Decline of the AI Data Commons》,NeurIPS 2024 Datasets and Benchmarks Track。https://proceedings.neurips.cc/paper_files/paper/2024/file/c3738949a80306cc48a8ea8ba0560f9d-Paper-Datasets_and_Benchmarks_Track.pdf
- Microsoft Research,《Phi-4 Technical Report》,2024 年 12 月。https://arxiv.org/html/2412.08905
- NVIDIA,《Synthetic Data Generation for Financial AI Research with NVIDIA NeMo》,2026 年。https://developer.nvidia.com/blog/synthetic-data-generation-for-financial-ai-research-with-nvidia-nemo/
- Cloudflare,《Content Independence Day, one year on—building the business model for the agentic Internet》,2026 年。https://blog.cloudflare.com/agentic-internet-bot-report/
本文部分内容由 AI 辅助生成,经人工审校和补充后发布。