上下文层之争:给 Agent 表、给答案,还是给结果
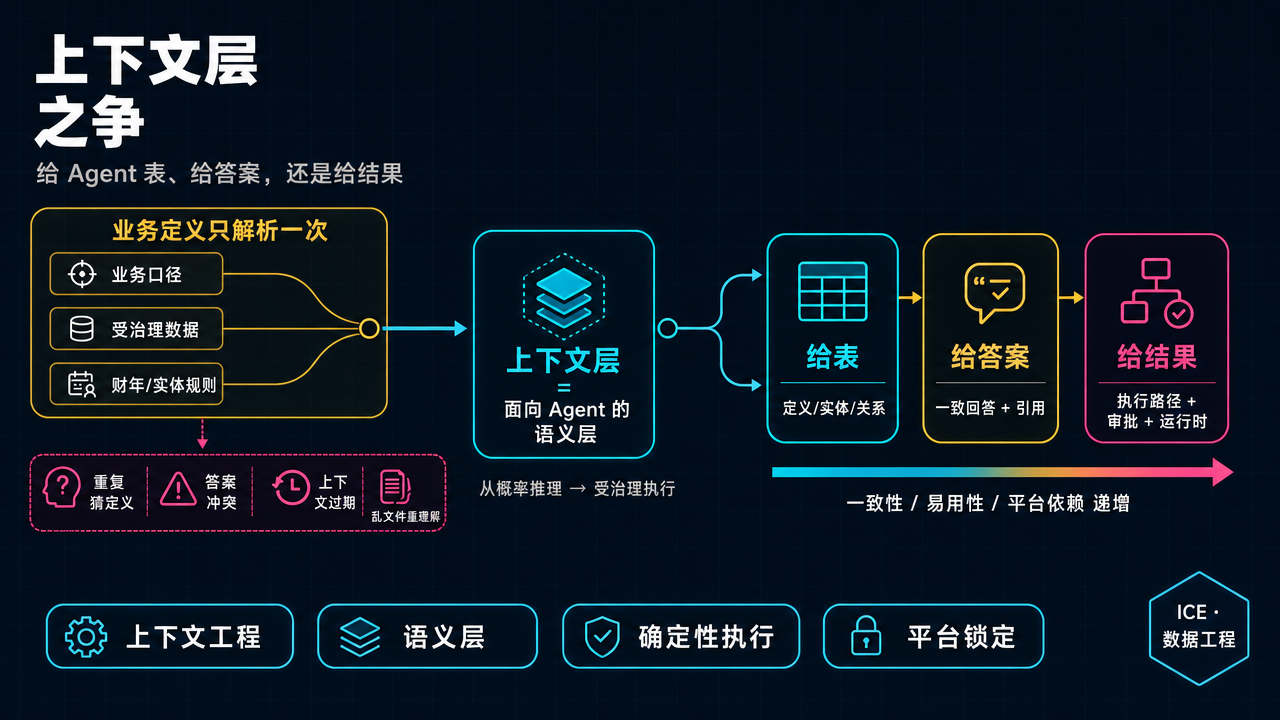
9 月 16 日到 22 日这一周,三家数据厂商几乎前后脚发了同一类产品:
- Fivetran 发布 Context Layer(有限公开预览),把上下文建在客户自己的数仓里;
- Databricks 宣布 Genie One MCP 正式 GA,让任何 Agent 通过一个 MCP 入口拿到基于 Genie Ontology 的答案;
- Teradata 把 Tera 升级成"agentic coworker",推出 Tera Context Engine、Tera Harness 和 Agent Skills(Q4 可用)。
同一周,Manifold 还上线了一个 Data Prep Agent,专门解决"Agent 每次都要把乱文件重新理解一遍"的问题。
名字各不相同,要解决的却是同一件事:Agent 不缺推理能力,缺的是"你们公司说的收入到底是哪张表"这种业务口径。 昨天那篇文章讲的是榜单分数带不进真实 BI;今天这批产品,就是厂商给出的解法。
有意思的是,三家都同意问题在哪,却在"上下文该放在哪、以什么形态交给 Agent"上走了三条完全不同的路。这篇文章把三条路拆开看,再讨论选型时真正该问的几个问题。
一、先把问题说清楚:Agent 为什么总是"看起来对"
在谈产品之前,值得先看一个具体的例子,因为它比任何定义都能说明上下文层要解决什么。
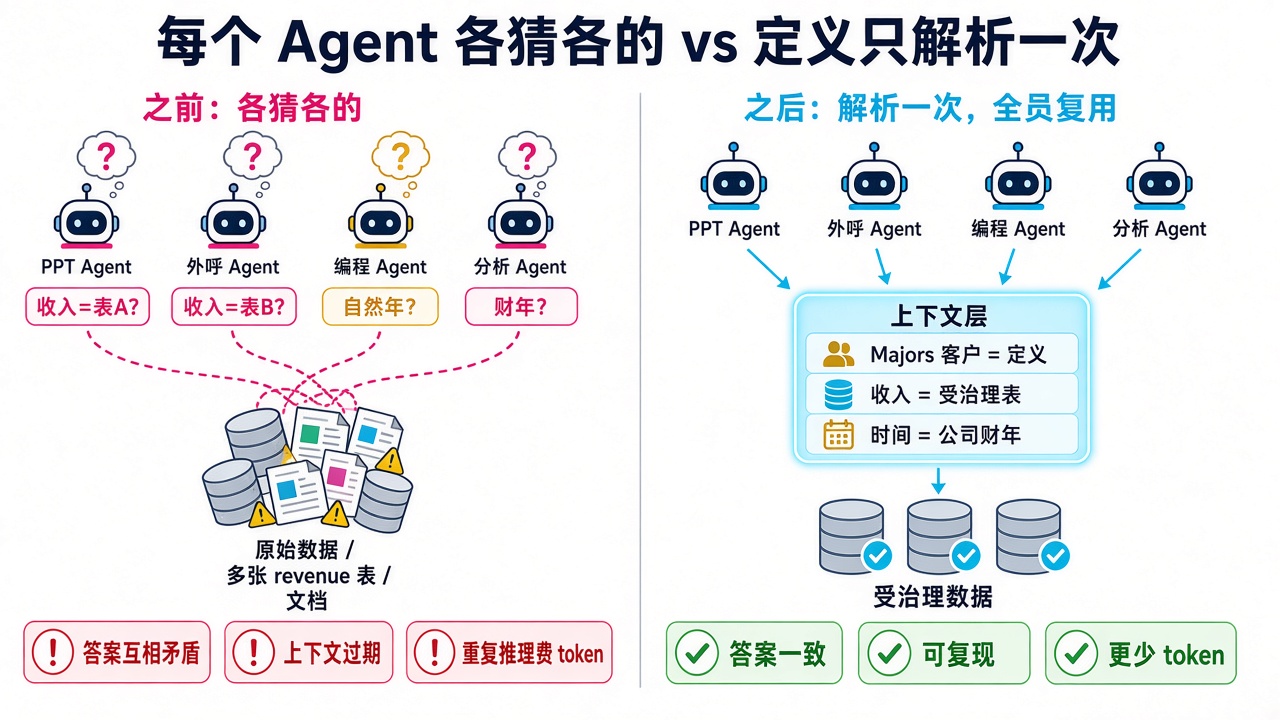
Fivetran 在发布文里举了一个问题:"去年财年,东北区前三大 Majors 客户的收入增长是多少?" 要答对这句话,Agent 至少要知道三件事:
- 你们公司怎么定义"Majors 客户";
- 数仓里有好几张表都叫 revenue,哪一张才是受治理的那张;
- "去年财年"要按公司自己的财年日历算,而不是自然年。
任何一项搞错,Agent 都会给出一个格式漂亮、数字合理、但就是错的答案。更麻烦的是,这种错误通常不会当场暴露,而是在某次汇报时被一个懂业务的人指出来。
Databricks 的描述角度不同,但症状一致。他们把问题归结为三点:孤立部署的 Agent 缺少业务语义;上下文是在上线时手工建模的,之后就慢慢过期了;指向同一份数据的不同 Agent 会给出互相矛盾的答案。
Manifold 从另一个方向补上了第四个症状:如果直接让 Agent 读一堆原始文件,它每次都要从头"重新做一遍数据工程",不仅慢,而且同一个问题在两天里可能得到两个不同答案。
把这四个症状放在一起看,结论很清楚:这不是模型能力问题,而是业务定义没有被固化在某个地方,导致每个 Agent、每次对话都在重新猜。Fivetran 在文中的一句话概括得很准:
Data teams have long built trust for analytics through semantic layers. Context engineering is the same discipline, pointed at a new consumer: agents.
换句话说,上下文层就是语义层换了一个消费者。过去消费语义层的是 BI 工具和分析师,现在是 Agent。
二、三家的共识:定义只解析一次
在看分歧之前,先看共识,因为共识才是这一轮产品真正的技术判断。
三家(加上 Manifold)的表述几乎可以互相替换:
| 厂商 | 原文表述(意译) |
|---|---|
| Fivetran | 一个定义只解析一次,然后被每个 Agent 继承,而不是每个工具各自重新发明 |
| Teradata | 用受治理的语义上下文和确定性检索,把工作从昂贵的概率推理转移到受治理的执行路径上 |
| Databricks | 无论用户在 Claude、ChatGPT、Cursor 还是内部界面里提问,都由同一个企业上下文层给出一致答案 |
| Manifold | 解析乱数据的成本,从每次分析转移到一次性入库 |
这背后其实是一个经济学判断:让大模型在每次对话里重新推理"收入是哪张表",既贵又不稳定;把这件事提前做一次、存下来、让所有 Agent 复用,既便宜又可复现。
这跟昨天那篇文章里 BI-Agent 的实验结论是同一个方向:接上专用工具后,GPT-OSS-120B 从 5.3 分涨到 45.3 分。模型的"数据能力"很大程度上不是它自己的属性,而是它背后那层确定性基础设施的属性。 上下文层,就是这层基础设施里最靠近业务的那一块。
共识到此为止。接下来的分歧,才决定了企业该怎么选。
三、三条路线:上下文放在哪,交出去的是什么
如果只看新闻稿,三家都在说"governed context""any agent""no lock-in"。但把产品机制拆开,会发现它们对"Agent 应该拿到什么"有截然不同的回答。
路线一:Fivetran——给 Agent 表
Fivetran 的核心主张是:上下文应该在"意义被赋予的地方"构建,也就是数据接入和 dbt 建模的环节,而不是事后另起一个系统。
具体做法有几块:
- 元数据连接器:从 dbt Semantic Layer、Looker、Sigma、Power BI 等已有语义资产里把定义拉过来,不用重建;
- 血缘与本体发现:从元数据、wiki 和业务系统里自动发现隐含的概念,用你公司自己的词汇起草一份本体;
- 搜索优化连接器:把 Confluence、Google Drive、Jira、Zendesk 里的非结构化知识解析、建索引;
- Agents Schema:按一套开源规范,把上下文发布成数仓里的普通 SQL 表;
- Agent Context MCP:提供一个受治理的 MCP 入口,但也允许任何有 SQL 权限的 Agent 直接读表;
- Traces 与 Evals:把 Agent 的会话连同答案、背后的 SQL 或文档、以及 Agent 做出的假设,一起写回数仓。
这条路线最关键的设计是:上下文本身就是数据。它躺在你的 Snowflake 或 BigQuery 里,受你已有的权限体系管控,可以被任何能写 SQL 的东西读取。MCP 只是一个便利入口,不是必经之路。
这让它在锁定风险上最轻,但也意味着 Agent 拿到的是"原材料"——定义、实体、关系都给你了,怎么用、怎么推理,还是 Agent 自己的事。
路线二:Databricks——给 Agent 答案
Genie One MCP 的设计思路完全不同。它不是把定义交给外部 Agent,而是把 Genie One 本身作为一个"同级 Agent"(peer agent)暴露出去。
MCP 暴露的工具是:向 Genie One 提问、获取查询结果、查看增量进度、引导回答方向。外部 Agent 不需要理解 Genie Ontology 的结构,只需要把问题丢过去,拿回一个带本体引用的答案。复杂子任务还会被路由给特定领域的 Genie Agents。整个 MCP 托管在 Unity Gateway 里,每次调用都有集中治理、细粒度策略和审计日志。
Databricks 举的场景很能说明这种形态:一个做 PPT 的 Agent,排版风格、高管偏好它都懂,但要往里填业务数字时,它去问 Genie One;一个客户成功团队的外呼 Agent,在发邮件之前先问 Genie One 这个客户的使用量下降意味着什么。
GetYourGuide 的工程经理在发布文里说得很直接:有的人在 Genie One 界面里工作,有的人整天待在 Claude Cowork 或 IDE 里,MCP 让同样可信的答案出现在所有地方。
这条路线的优点是一致性最强:定义不会在传递中走样,因为它根本不离开平台。代价是,外部 Agent 看到的是一个黑盒——它知道答案,但不一定知道答案背后的定义;而本体、推理和治理,全部内聚在 Databricks 平台里。
路线三:Teradata——给 Agent 结果
Teradata 走得最远。它的口号是"通用 AI 助手生成答案,Tera 交付结果"。换句话说,它不仅要管上下文,还要管执行。
Tera Context Engine 负责上下文。它自称是开放、中立的一层,跨越企业已有的数据库、数据平台、管道引擎、目录和模型,而且不限于 Teradata 自己管理的数据。它有几个值得注意的设计:
- 原生上下文图:把元数据、血缘、语义和业务含义作为"关系"保存,而不是压平成关系表;
- 读写回源:从现有记录系统读取,也写回去,声称能从真实使用中持续学习;
- 行业知识模型:把 Teradata 在大型企业里积累的行业术语、关系、政策封装成符号化知识底座,和统计 AI 结合(它称之为 neurosymbolic)。
Tera Harness 负责执行,这是其他两家没有的部分:
- 在推理之前套用 84 种已验证的执行模式,让 Agent 一开始就有执行计划,而不是每一步都靠 LLM 重新想;
- 把安全策略和人工审批嵌入 Agent 循环内部,在高风险操作执行前拦截;
- 用 Go + gRPC 实现,声称单台 8 vCPU 虚拟机能跑 512 个并发 Agent,每分钟 279 次工具调用;
- 原生支持状态检查点,Agent 可以运行数天甚至数周,等待人工审批时零计算成本,故障后原地恢复。
再加上 Agent Skills(把数据工程、分析、科学任务封装成可调用函数)和两类预置 Agent(管平台运维的 Platform Agents、做分析的 Analytics Agents),Teradata 交给用户的是一个完整的"会干活的同事"。
这条路线承诺最多,但也要求企业把最多的东西交给它:不只是定义,还有执行路径、审批流程和运行时。
三条路线放在一起
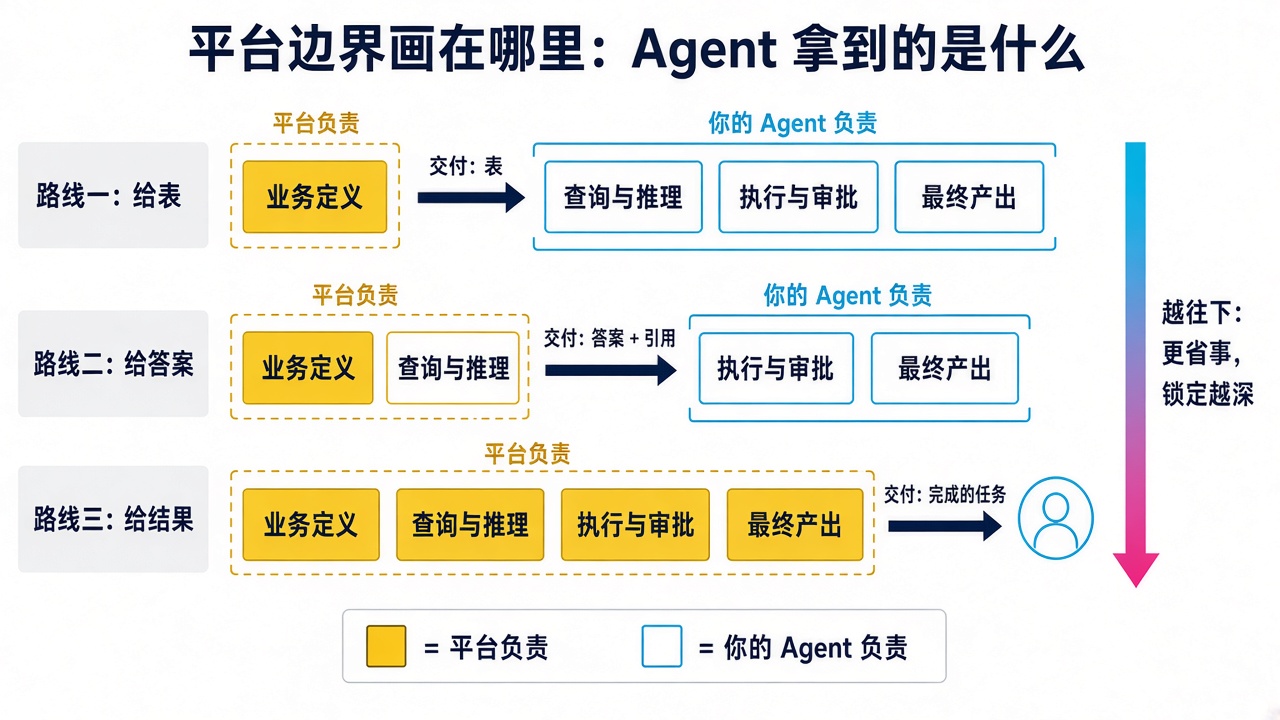
三家的差别,本质上是"平台边界画在哪里":边界之内由平台负责,边界之外交给你自己的 Agent。
把各维度摊开对比:
| 维度 | Fivetran | Databricks | Teradata |
|---|---|---|---|
| Agent 拿到什么 | 表(定义与实体) | 答案(带本体引用) | 结果(完成的任务) |
| 上下文存放在哪 | 客户自己的数仓 | Databricks 平台内(Genie Ontology) | 跨平台的中立层(上下文图) |
| 访问方式 | SQL 直读 或 MCP | MCP(Unity Gateway 托管) | 自有 Harness + MCP 扩展 |
| 是否接管执行 | 否 | 部分(路由到领域 Agent) | 是(Harness + Skills) |
| 可观测性 | Trace 写回数仓 | 每次调用审计日志 | 运行时全程可观测 |
| 当前状态 | 有限公开预览 | 已 GA | Q4 2026 可用 |
从左到右看,是一条清晰的梯度:Agent 拿到的东西越"成品化",一致性和易用性越好,但企业对平台的依赖也越深。
四、别急着信数字:厂商宣称要打几折
这一轮发布里有不少漂亮数字,选型前值得逐个看清楚它们是怎么来的。
Teradata 的基准测试是最显眼的:在 SWE-bench Pro 上用同一个 Opus 5 模型,Tera 比 Claude Code 少用 73% 的 token、快 42%、总成本低 58%;在 Snowflake Labs 和 Bespoke Labs 开发的 data-eng-bench 上,每个"可靠解决的任务"成本比 Snowflake Cortex Code 低 53%,并拿到最高的 Pass^3 分数。
这些数字有两个需要注意的地方。第一,SWE-bench Pro 是软件工程基准,不是数据工程基准,它更多说明 Harness 的执行效率,而不是上下文层的价值。第二,data-eng-bench 的对比是"基于对方公开的基准数据",也就是说对照组不是 Teradata 自己跑的。Teradata 表示提供了完整方法论和独立验证材料,这一点值得肯定,但仍属厂商自测。
Fivetran 的效果宣称更加定性:用内部评测和"通用 MCP"对比,接入 Context Layer 的 Agent 工具调用更少、回答更快、输入 token 显著减少。没有给出具体数字,对照组"通用 MCP"的定义也不清楚。
Databricks 基本没给量化数字,给的是客户引述和使用场景。
这并不是说这些产品没用——"定义只解析一次"在原理上必然能省掉重复推理。但昨天那篇文章已经说明:分数跨基准、跨引擎、跨运行都不一定迁移,厂商自测的数字更是如此。真正有决策价值的,是用你自己的 schema、你自己的业务问题跑一遍。
五、真正该问的四个问题
抛开营销话术,上下文层的选型其实可以归结为四个问题。这四个问题没有标准答案,但每一个都会在上线半年后回来找你。
问题一:本体归谁所有
这是最根本的问题。当你把公司的业务定义——什么是 Majors 客户、收入怎么算、财年怎么切——沉淀进某个平台之后,这份本体还能不能带走?
Fivetran 的回答是"它就是你数仓里的表,按开源规范存放";Databricks 的本体住在 Genie Ontology 里;Teradata 说自己是中立层,但它的上下文图、行业知识模型和 84 种执行模式,都是 Teradata 自己的资产。
过去,企业被锁定的是数据格式和计算引擎,湖仓开放表格式(Iceberg、Delta)正在把这层锁打开。下一轮锁定,很可能发生在业务语义这一层——因为迁移数据只需要复制文件,迁移本体却要重新对齐整个公司的口径。
问题二:定义变了,谁来批准
Databricks 点出了一个真问题:手工建模的上下文会过期。Teradata 的回答是让上下文层"从真实使用中持续学习、写回记录系统"。
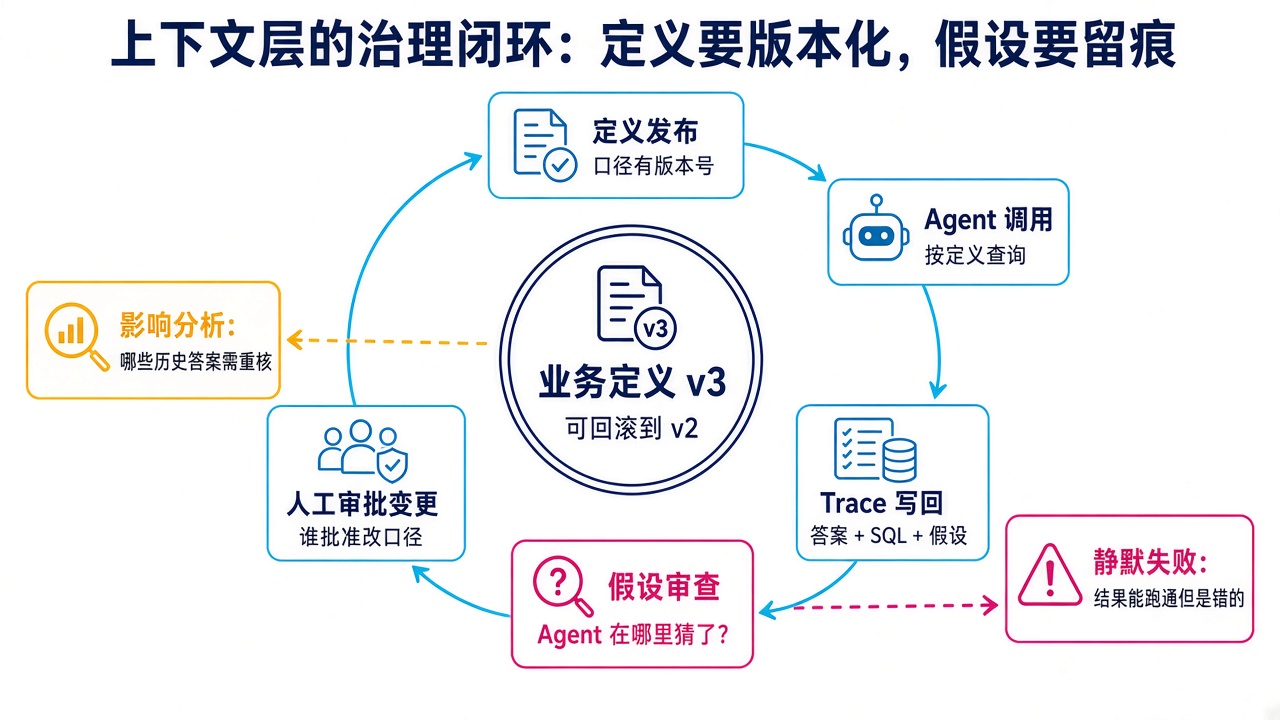
这听起来很好,但也带来一个治理问题:如果 Agent 的使用行为可以反过来修改业务定义,那么谁来审批这些修改? 收入口径变了,过去三个月的所有 Agent 答案是否需要重新核对?定义有没有版本号,能不能回滚到上个季度的口径?
这是语义层时代就存在、但在 Agent 时代被放大的问题。BI 报表的口径变了,至少有人会看到报表数字跳了一下;Agent 的口径变了,可能只是回答里的某个数字悄悄不一样了。
问题三:MCP 只是管道,上下文才是资产
三家都支持 MCP,这很容易让人觉得"都接了 MCP,所以差不多"。但前天那篇写联合国数据共享平台的文章已经讨论过:MCP 只是最后一公里的传输协议,它决定 Agent 怎么连上来,不决定 Agent 拿到的东西对不对。
同样是 MCP,Fivetran 暴露的是一组可查询的上下文表,Databricks 暴露的是一个会回答问题的 Agent,Teradata 用 MCP 让你往它的 Harness 里接更多工具。协议相同,交付物完全不同。选型时要问的不是"支不支持 MCP",而是"通过 MCP 我能拿到什么,拿不到什么"。
问题四:Agent 做了什么假设,能不能查到
Fivetran 的 Trace 设计里有一个容易被忽略的细节:写回数仓的不只是答案和 SQL,还有 Agent 为得出答案而不得不做出的假设。
这一点非常关键。昨天那篇文章提到,DataClawEval 里约三分之一的低分运行是静默失败——程序正常跑完,结果是错的。在上下文层场景里,静默失败最常见的来源就是 Agent 在定义缺失时"自己补了一个假设"。如果这些假设不被记录,你永远不知道哪些答案是建立在猜测之上的。
Databricks 的调用审计和 Teradata 的运行时可观测性,解决的是"谁在什么时候调了什么";Fivetran 的假设记录,解决的是"Agent 在哪里猜了"。两者都需要,但后者更少见。
把问题二和问题四连起来,就是一个完整的治理闭环:定义有版本号,Agent 按定义调用,调用轨迹连同假设写回,人工审查假设、批准口径变更,再发布新版本。
六、放到国内看:可信数据空间里的上下文层
这一轮发布都是海外厂商,但它们讨论的问题,在国内正以另一种形式出现。
中国信通院在 9 月初的演讲里提到,AI 时代可信数据空间需要探索新规则,包括"多主体协同网络中的角色定义、基于任务需求的数据智能调用、AI 智能体场景化组织与编排、词元贡献的计量计利方式"。9 月 11 日启动的北京城市可信数据空间,也在架构里放进了"空间智能体",用于数据产品开发、检索推荐、合规监测等融合开发链路。
对照三家海外厂商,可以看到一个明显的差异:海外的上下文层基本都在单一企业内部,而可信数据空间天然是跨组织的。 当多家机构的数据在一个空间里融合开发时,"收入"的定义可能在每一家都不一样;智能体调用数据时,需要的不只是一家的本体,而是多方之间的口径映射。
这意味着,在可信数据空间场景里:
- 开放、可携带的上下文格式比平台内聚的本体更重要,因为没有哪一方愿意把业务定义交给另一方的平台;
- 假设与口径的留痕不只是质量问题,还是合规问题——跨主体的数据使用,需要能说清楚每个答案用的是谁的定义;
- 词元贡献的计量,最终也需要落到"哪一方的上下文被调用了多少次"这个粒度上。
从这个角度看,Fivetran 那种"上下文即数据、按开源规范存放"的思路,对国内数据空间的建设者可能更有参考价值;而 Teradata 的行业知识模型,则提示了另一种可能——行业级的公共本体,也许会成为数据空间运营方的核心资产。
结论
这一周的三个发布,说明数据平台的竞争焦点正在从"谁的模型接得好"转向"谁掌握业务定义"。读完可以带走四点:
- 共识:上下文层是语义层在 Agent 时代的延续,核心逻辑是"定义只解析一次,所有 Agent 复用",本质是用确定性基础设施替代重复的概率推理。
- 分歧:Fivetran 给表、Databricks 给答案、Teradata 给结果。越往后越省事,锁定也越深。
- 判断标准:选型时别只问"支不支持 MCP",要问本体能不能带走、定义变更谁批准、Agent 的假设有没有留痕。
- 行动建议:在采购任何上下文层之前,先把公司最常被问错的 20 个业务问题列出来,看看每个问题背后需要哪几个定义——这份清单本身,就是你上下文层的第一版。
最后留一个问题给你:你们公司现在的"收入"定义,是写在某张表里、某个人脑子里,还是每个 Agent 各猜各的?
参考资料
- Kevin Kim、Jon Lewis,Fivetran,《Announcing Fivetran Context Layer》,2026-09-16 — https://www.fivetran.com/blog/announcing-fivetran-context-layer
- Ben Tripp、Sydney Sundell,Databricks,《The Genie One MCP is now Generally Available》,2026-09-22 — https://www.databricks.com/blog/genie-one-mcp-now-generally-available
- Teradata,《Teradata Transforms Tera into an Agentic Coworker; Introduces Tera Context Engine and Tera Harness》,PR Newswire,2026-09-22 — https://www.prnewswire.com/news-releases/teradata-transforms-tera-into-an-agentic-coworker-introduces-tera-context-engine-and-tera-harness-302885832.html
- Qi Wang、Sourav Dey,Manifold,《Data Prep Agent: Turn Raw Files into Query-ready Tables》,2026-09-16 — https://www.manifold.ai/resources/data-prep-agent-turn-raw-files-into-query-ready-tables
- 数字中国建设峰会,《可信数据空间正与AI深度融合》,2026-09-02 — https://www.szzg.gov.cn/2026/xwzx/szkx/202609/t20260902_5366710.htm
- 经济观察网,《服贸观澜|北京数据集团周年"成绩单"出炉,正式启动北京城市可信数据空间》,2026-09-11 — http://www.eeo.com.cn/2026/0911/1033139.shtml